

Crawler les sites en préproduction.
Découvre comment réaliser un audit SEO d’un site en préproduction et être prêt pour la mise en ligne.
Comment crawler un site en préproduction en contournant les blocages prévus pour les moteurs : robots.txt, authentification, restrictions IP, noindex et nofollow. À la fin, compare la préproduction avec le site en ligne.
Analyser les sites en préproduction
Les sites en préproduction (staging) ne peuvent généralement pas être crawlés par les moteurs et les robots. Comme il existe plusieurs façons d’empêcher le crawl, Screaming Frog propose différentes approches et réglages pour les crawler quand même et contourner ces limites.
robots.txt
Le cas le plus courant est un robots.txt qui bloque le crawl. SEO Spider ne collecte alors qu’une seule URL, le statut affiche « Blocked by robots.txt » et l’URL est « Non-Indexable ».
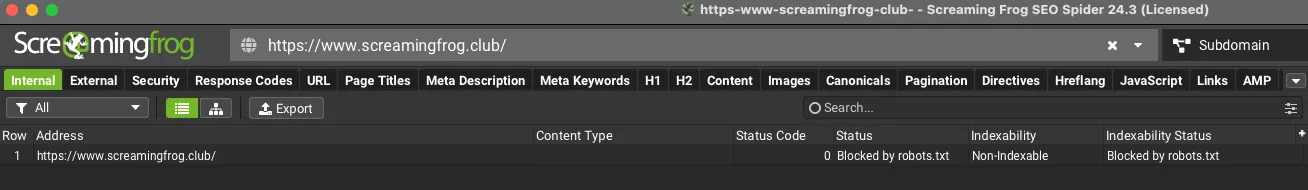
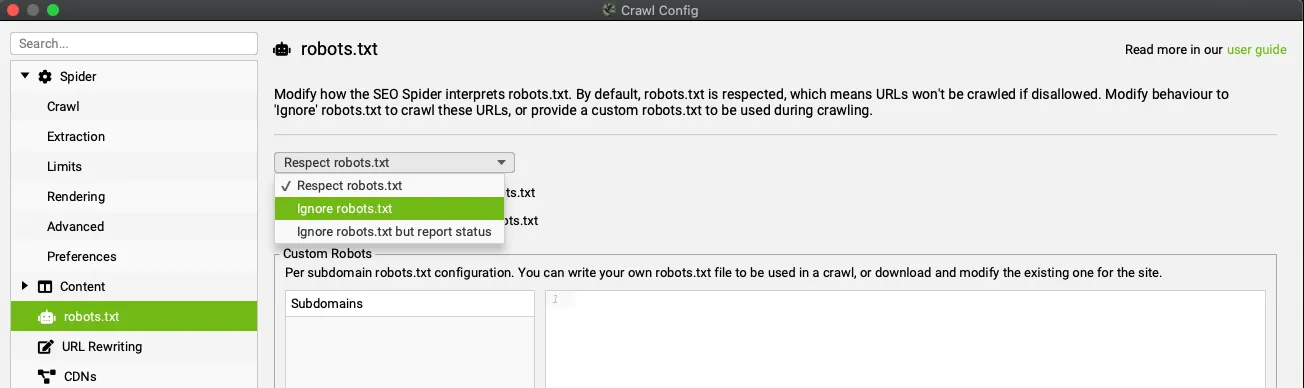
Pour passer cette barrière, il suffit de régler Ignore robots.txt dans 1Configuration›2robots.txt.
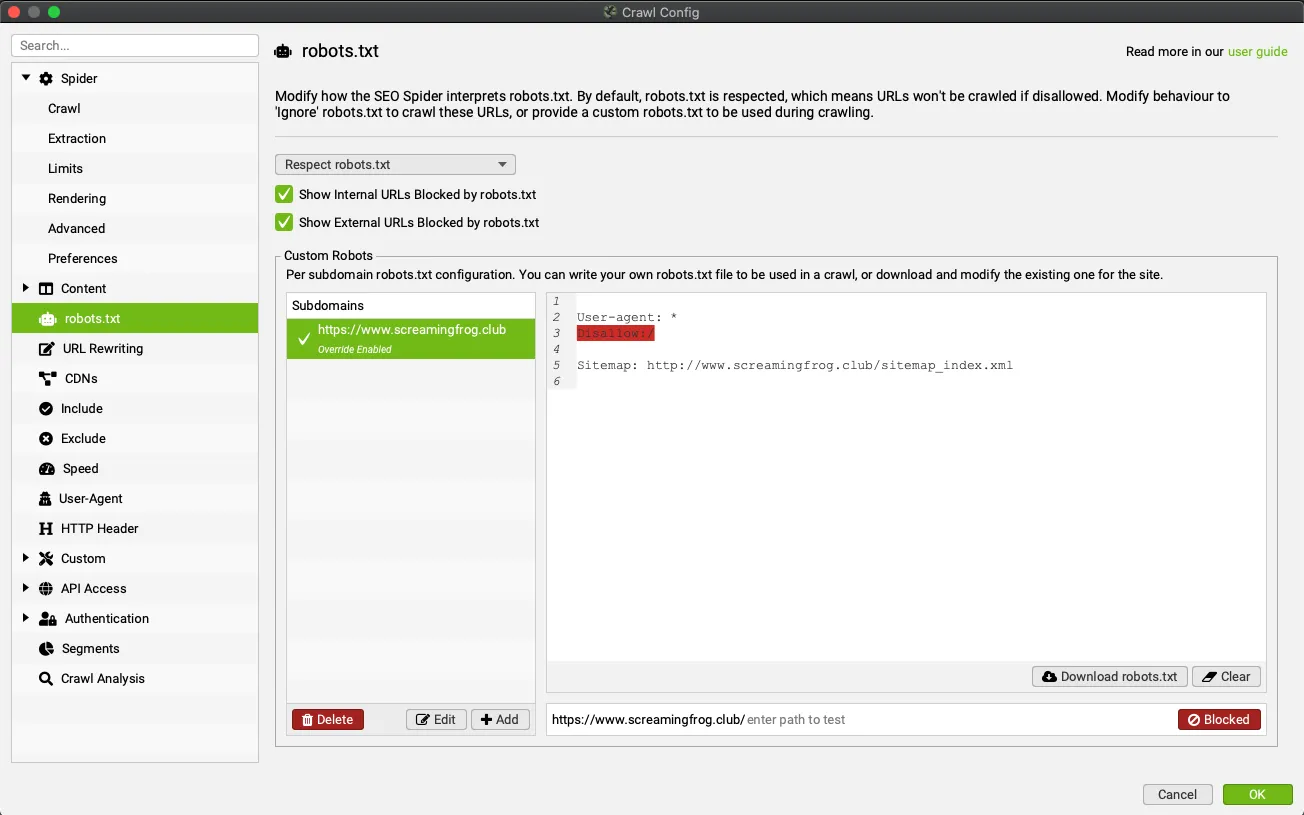
Autre possibilité : configurer un robots.txt personnalisé dans la section Custom Robots de la même fenêtre, pour retirer les directives « disallow » et ajouter, si besoin, d’autres règles à suivre.
Authentification
Si le serveur demande une authentification, tu peux fournir un identifiant et un mot de passe à SEO Spider pour crawler le site.
Authentification de base
L’authentification basic et digest est détectée automatiquement par SEO Spider pendant le crawl : une fenêtre d’authentification s’affiche, comme dans un navigateur, et demande identifiant et mot de passe.
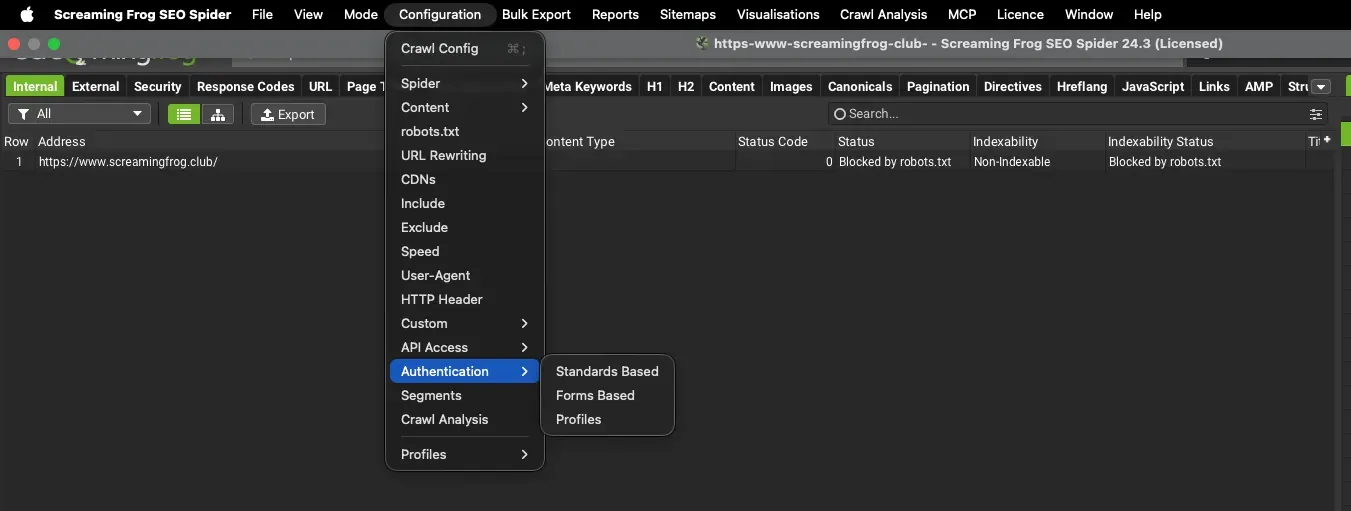
Tu peux aussi saisir les identifiants avant le crawl dans 1Configuration›2Authentication›3Standards Based : active Allow standards based authentication, clique sur Add et remplis URL/Host, Username et Password.
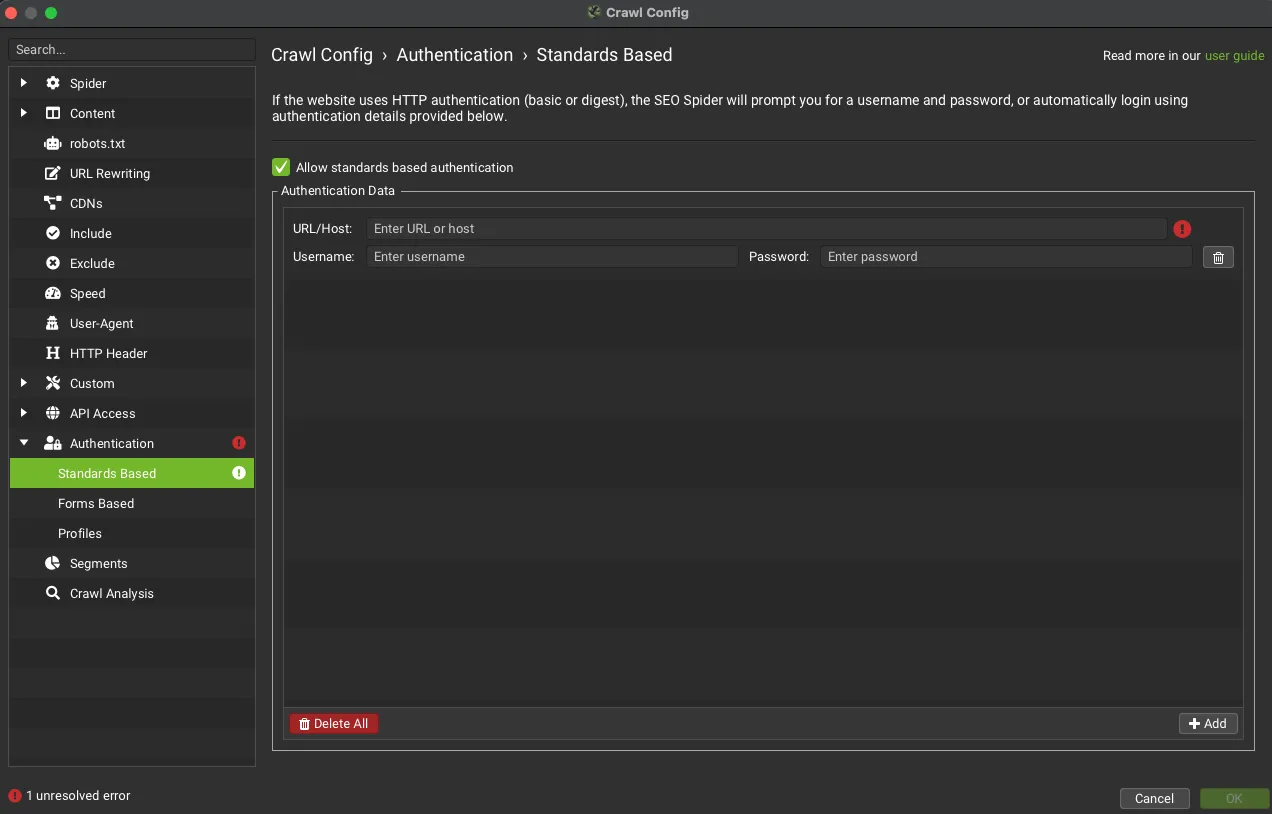
Avec les bons identifiants, SEO Spider crawle normalement le site en préproduction.
Authentification par formulaire
S’il y a des formulaires ou des zones qui demandent une connexion par cookies, SEO Spider permet de s’y connecter dans son navigateur Chrome intégré.
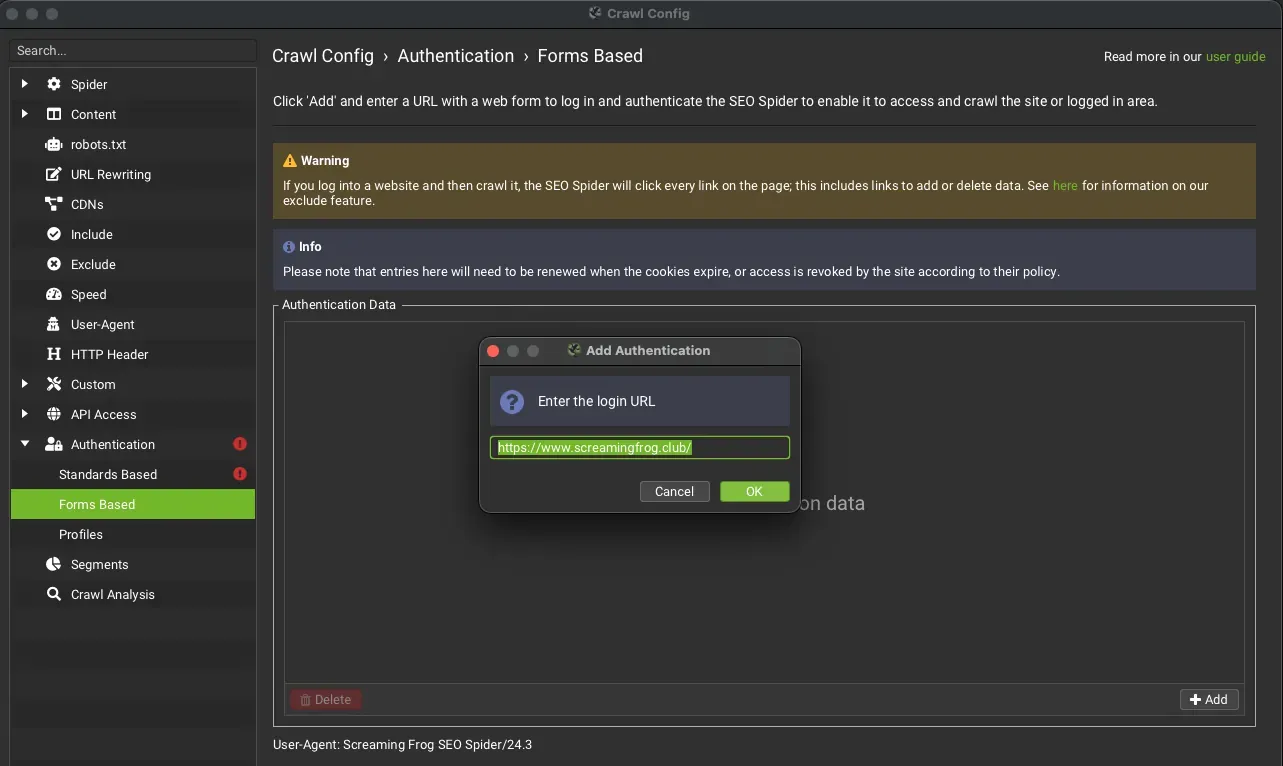
Pour te connecter par formulaire, va dans 1Configuration›2Authentication›3Forms Based, clique sur Add, saisis l’URL de la page de connexion et connecte-toi depuis le navigateur.
Adresse IP
Certaines plateformes de préproduction limitent l’accès selon l’adresse IP.
Comme SEO Spider crawle en local depuis la machine où il tourne, il faut fournir cette adresse IP pour qu’elle soit ajoutée à la liste blanche.
Configuration de SEO Spider
Les sites en développement peuvent répondre aux requêtes HTTP différemment des sites en ligne, et ont souvent des directives robots qui demandent des réglages supplémentaires dans SEO Spider.
Vitesse de crawl
Les sites en préproduction sont en général plus lents et ne supportent pas la même charge qu’un serveur de production. Si tu constates de l’instabilité, des délais dépassés ou des erreurs serveur, réduis la vitesse de crawl dans 1Configuration›2Speed.
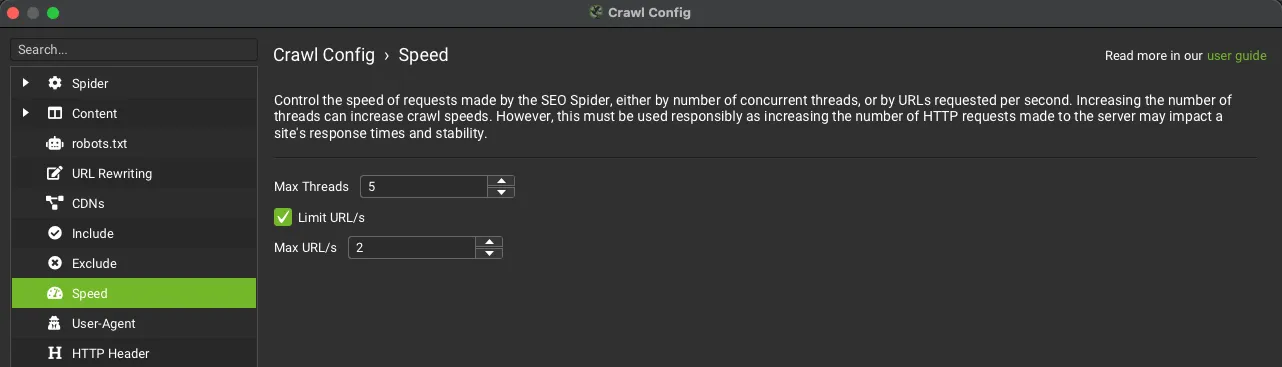
Tu peux aussi gérer le délai de réponse et le délai AJAX pour les crawls avec rendu JavaScript.
Nofollow
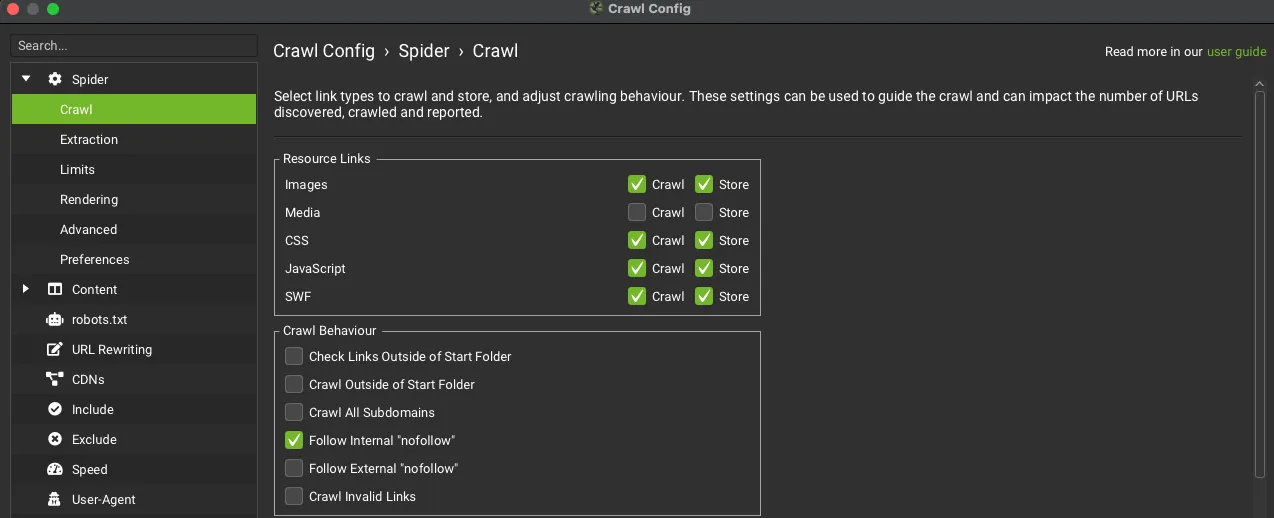
Pour se protéger des robots, beaucoup de sites en développement ont une meta robots « nofollow » sur tout le site, ou un X-Robots-Tag dans l’en-tête HTTP. « nofollow » est une directive très différente de noindex : elle demande au robot de ne suivre aucun lien sortant de la page.
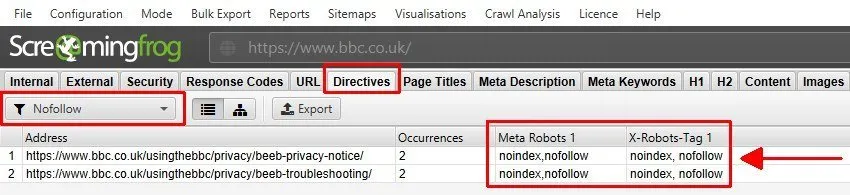
Dans ce cas, va dans 1Configuration›2Spider›3Crawl et active Follow Internal “nofollow” pour crawler les liens sortants de ces pages et obtenir un audit complet.
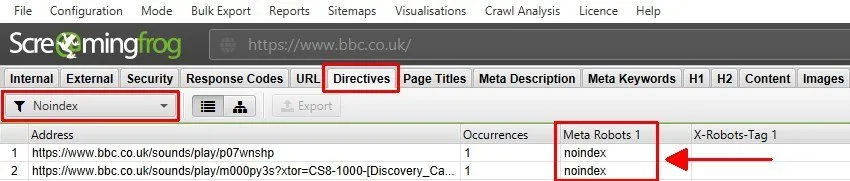
URL en noindex
Autre balise fréquente en préproduction : le noindex, qui autorise le crawl mais pas l’indexation. Tu le vois dans l’onglet Directives avec le filtre Noindex. Je te conseille de vérifier qu’il est retiré dès la mise en ligne : on voit trop souvent des sites encore bloqués par le robots.txt ou le noindex après leur lancement.
Au-delà de la mise en ligne, SEO Spider crawle les pages en noindex (comme un robot normal) mais les considère comme « non indexables ». Par défaut, il les exclut des filtres de problèmes : il ne signale pas les contenus dupliqués, titles manquants, meta descriptions, etc., et l’analyse peut être très partielle.
La solution : désactiver Ignore Non-Indexable URLs for Issues pour un crawl complet du site en préproduction :
1Configuration›2Spider›3Advanced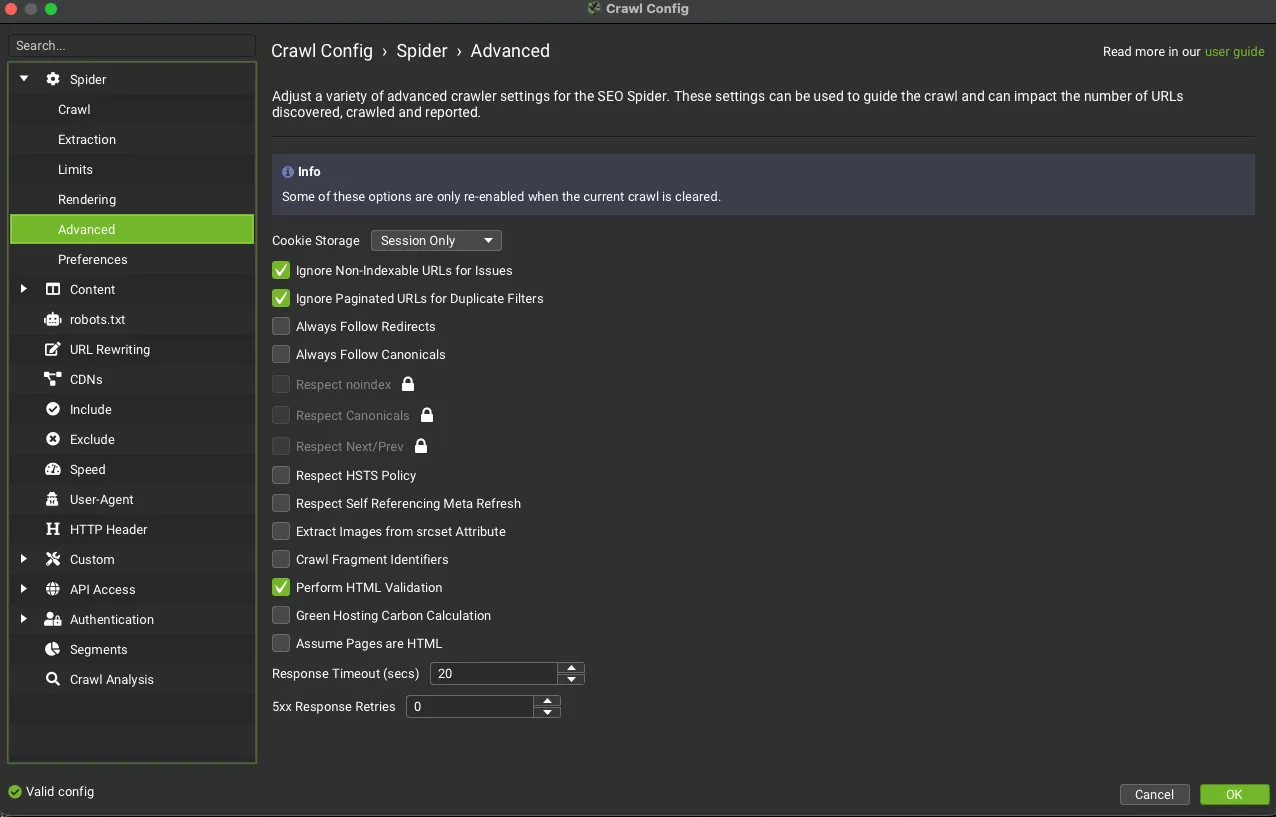
La directive none
La directive « none » est trop souvent sous-estimée et mal comprise, comme si elle signifiait « aucune directive » : en réalité, elle équivaut à « noindex, nofollow » !
Dans ce cas, suis les mêmes étapes que ci-dessus.
Site en ligne vs préproduction
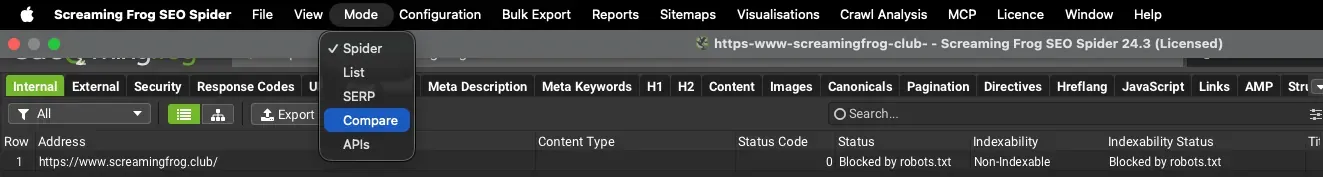
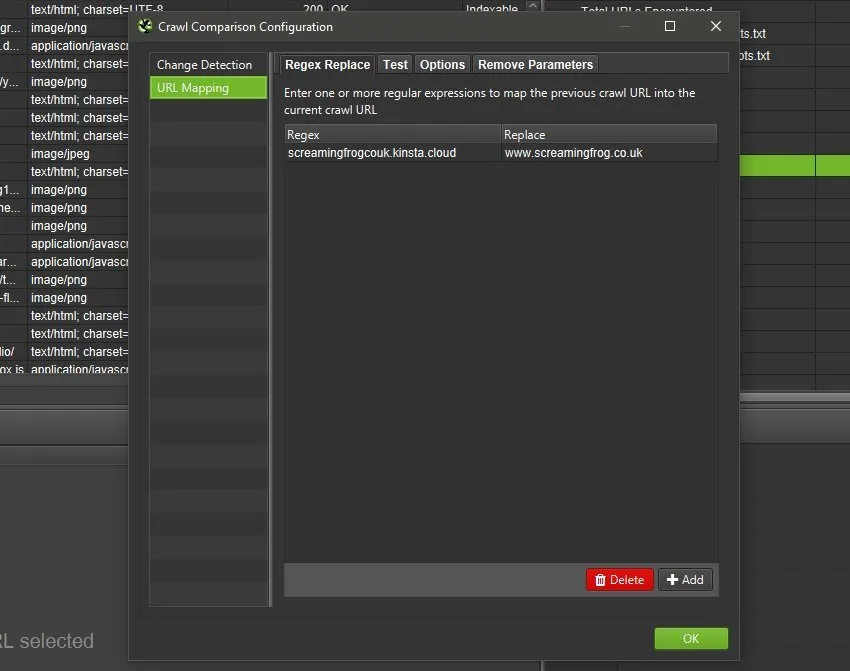
Avec les dernières versions de Screaming Frog, tu peux comparer deux crawls pour voir les différences, notamment grâce à l’URL Mapping, qui compare deux structures d’URL différentes comme un site de préproduction et l’environnement de production.
Pour comparer la préproduction au site en ligne, clique sur 1Mode›2Compare et sélectionne les deux crawls.
Vidéo sur le crawl des sites en préproduction
Des questions sur Crawler les sites en préproduction?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
