

ONGLET DONNÉES STRUCTURÉES.
Une première analyse pour gérer les microdonnées et les données structurées en JSON.
Sommaire du guide 3 sections
●Brief01.Présentation des données structurées02.L’onglet Structured DataCe que tu trouves dans l’onglet Structured Data de SEO Spider : formats pris en charge (JSON-LD, Microdata, RDFa), options à activer et filtres pour les erreurs de validation.
Présentation des données structurées
Les moteurs de recherche, et Google en particulier, évoluent sans cesse pour mieux comprendre le contenu d’une page web. Les données structurées servent précisément à cela : elles facilitent le crawl et l’interprétation en fournissant au moteur des indices plus précis.
Ce sont des éléments très précieux qui aident le classement de la page et permettent d’activer des fonctionnalités et des enrichissements dans les résultats de recherche. Les données structurées sont codées avec un balisage précis et suivent le vocabulaire Schema.org, même si la référence principale reste « Google Search Central », qui indique quelles données sont obligatoires, recommandées ou facultatives selon les cas.
Schema.org prévoit bien d’autres propriétés, qui ne sont pas obligatoires pour la recherche Google et peuvent donc être laissées de côté lors de l’optimisation d’un site.
La recherche Google prend en charge 3 formats de données structurées :
- JSON-LD (recommandé) ;
- Microdata ;
- RDFa.
Les données structurées peuvent être testées et validées avec le test des résultats enrichis, et leur état de santé suivi dans la section dédiée de la Search Console.
Screaming Frog est aussi un allié utile pour surveiller ce balisage : l’onglet « Structured Data » contient tous les détails principaux et signale les problèmes de validation trouvés pendant le crawl.
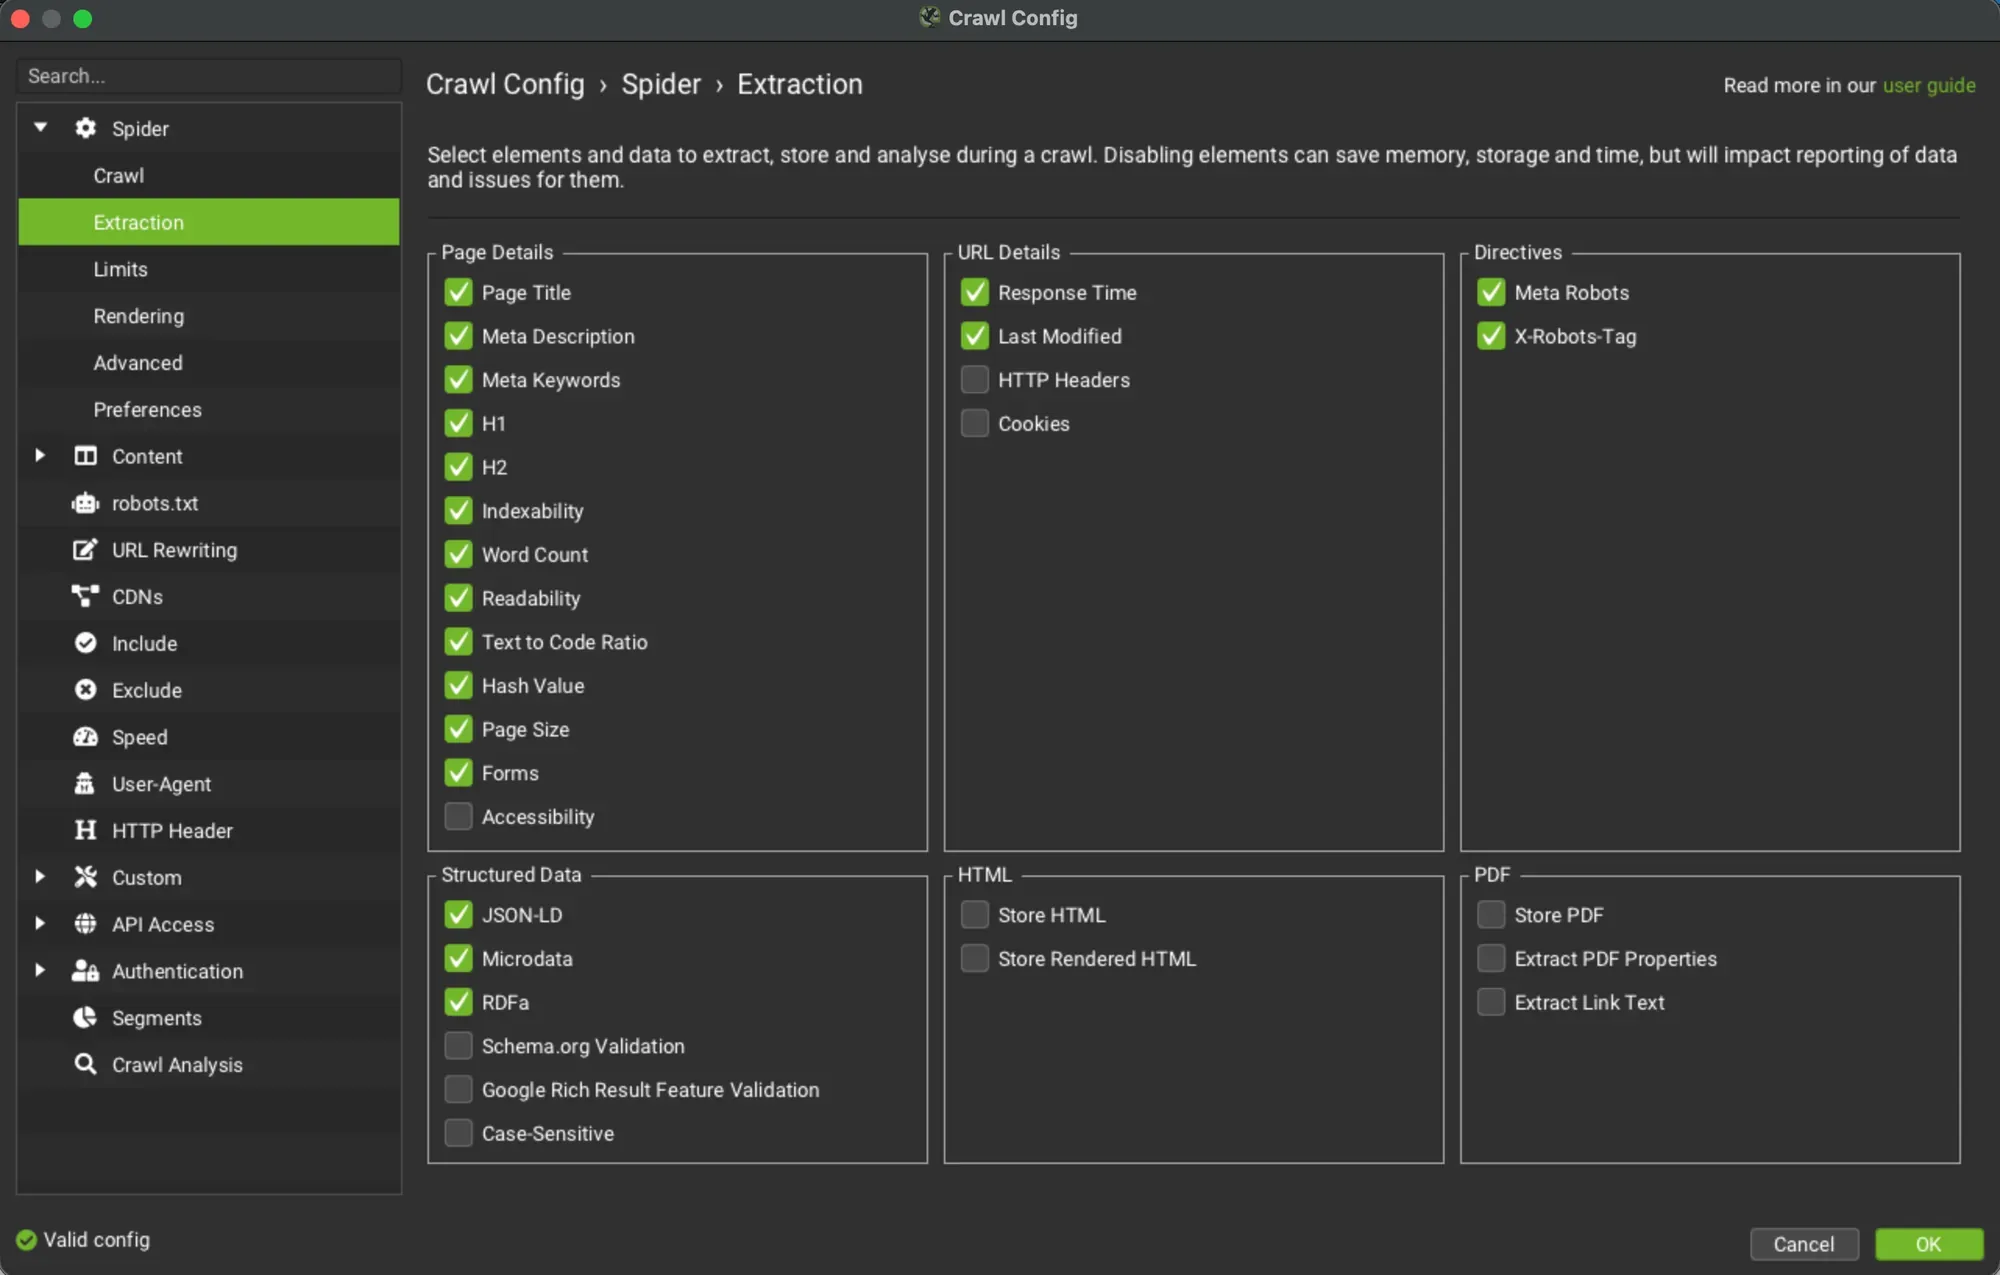
Pour collecter les données et remplir les filtres, active les options JSON-LD, Microdata, RDFa, Schema.org Validation et Google Rich Result Feature Validation dans 1Configuration›2Spider›3Extraction.
L’onglet Structured Data
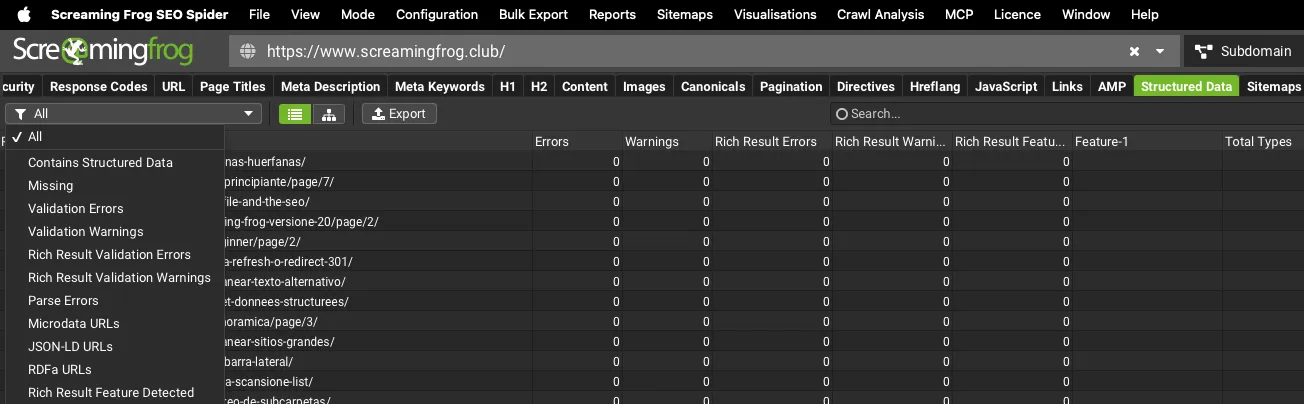
Les colonnes disponibles dans l’onglet « Structured Data » :
- Address : l’URL crawlée.
- Errors : le nombre total d’erreurs de validation.
- Warnings : le nombre total d’avertissements trouvés pendant le crawl.
- Rich Result Errors et Warnings : erreurs et avertissements de validation des Rich Results de Google.
- Rich Result Features : les fonctionnalités de Rich Result détectées (Feature 1, 2, etc.).
- Total Types : le nombre total de types de données structurées trouvés pour l’URL.
- Unique Types : combien de types uniques de données structurées ont été trouvés pour l’URL.
- Type 1 : le premier type de données structurées trouvé.
- Type 2 etc. : le deuxième type de données structurées trouvé.
Les filtres disponibles sont :
- Contains Structured Data : toutes les URL qui contiennent des données structurées.
- Missing : les URL sans données structurées.
- Validation Errors : toutes les URL qui présentent des erreurs de validation par rapport au vocabulaire Schema.org, aux rich results de Google ou aux deux, selon ta configuration. SEO Spider classe toujours les problèmes Schema.org comme des erreurs plutôt que comme des avertissements. La validation des rich results de Google signale les propriétés obligatoires manquantes ou mal implémentées.
- Validation Warnings : toutes les URL qui présentent des avertissements de validation par rapport aux Rich Results de Google. SEO Spider ne remplit ce filtre qu’avec les problèmes de validation des propriétés recommandées (facultatives).
- Rich Result Validation Errors et Warnings : séparent les erreurs et avertissements qui concernent uniquement les Rich Results de Google.
- Parse Errors : toutes les URL dont les données structurées n’ont pas pu être analysées correctement. C’est souvent dû à un balisage incorrect. Si tu utilises le format préféré de Google, JSON-LD, le JSON-LD Playground est un excellent outil pour déboguer ces erreurs.
- Microdata URLs | JSON-LD URLs | RDFa URLs : les URL qui contiennent des données structurées au format Microdata, JSON-LD ou RDFa.
- Rich Result Feature Detected : les URL pour lesquelles au moins une fonctionnalité de Rich Result a été détectée.
Des questions sur ONGLET DONNÉES STRUCTURÉES?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
