

ONGLET CUSTOM SEARCH – EXTRACTION.
Analyse pour les recherches personnalisées et le scraping sur mesure.
Ce que tu trouves dans les onglets Custom Search et Custom Extraction de SEO Spider et comment lire les résultats des recherches et extractions personnalisées.
Custom Search
L’onglet de recherche personnalisée te permet de vérifier la présence ou l’absence de certains éléments dans le code source des pages HTML. Les recherches se configurent depuis 1Configuration›2Custom›3Custom Search, les extractions depuis 1Configuration›2Custom›3Custom Extraction.
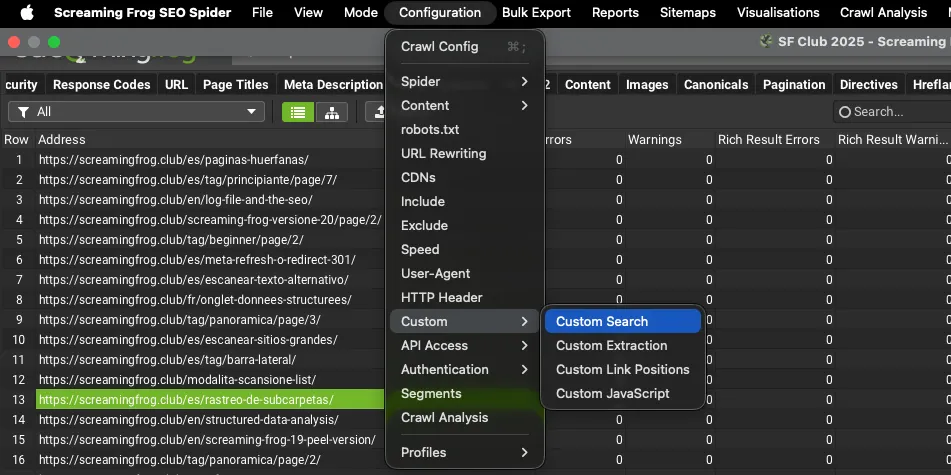
Tu peux appliquer jusqu’à 100 filtres avec des règles regex et obtenir un résultat booléen avec les pages qui « contiennent » ou « ne contiennent pas » l’élément choisi.
Les résultats de ta recherche contiendront les données suivantes :
- Address : l’adresse de l’URL crawlée ;
- Content : le type de contenu détecté pour l’URL ;
- Status Code : le code de statut de la ressource.
- Status : la réponse de l’en-tête HTTP.
- Contains: [x] : le nombre d’occurrences [x] dans chaque URL où l’élément recherché a été trouvé.
- Does Not Contain [y] : indique si l’élément recherché a été trouvé ou non pendant la custom search.
La section des filtres de l’onglet affiche le nom choisi pour chaque custom search.
Pour aller plus loinCustom Search.Comment configurer les recherches personnalisées, avec des exemples de regex pour les fautes de frappe, la cannibalisation et les scripts manquants.Lire le guideCustom Extraction
Avec cette fonction, tu peux configurer jusqu’à 100 custom extractions via XPath, CSSPath ou regex. L’extraction ne s’exécute que sur les URL au contenu HTML.
Les résultats sont présentés selon ces dimensions :
- Address : l’adresse de l’URL crawlée.
- Content : le type de contenu détecté pour l’URL.
- Status Code : le code de statut de la ressource.
- Status : la réponse de l’en-tête HTTP.
La section des filtres de l’onglet affiche le nom choisi pour chaque custom extraction.
Pour aller plus loinCustom Extraction.XPath, CSSPath et regex prêts à l’emploi pour extraire titres, hreflang, Open Graph, identifiants de suivi et données structurées.Lire le guideDes questions sur ONGLET CUSTOM SEARCH – EXTRACTION?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
