

STATUS CODE.
L’onglet de référence pour analyser les codes de statut : 4xx, 3xx et erreurs serveur
Ce que tu trouves dans l’onglet Response Codes de SEO Spider : colonnes et filtres pour les URL bloquées, sans réponse, les redirections et les erreurs 4xx et 5xx, avec les actions à mener pour chacune.
Présentation de l’onglet Status Code
L’onglet « Response Codes » affiche le statut HTTP et les codes de statut des URL internes et externes découvertes pendant le crawl. Voici toutes les colonnes disponibles :
- Address : l’URL crawlée.
- Content : le type de contenu de l’URL (text/html, image/png, image/jpg, etc.).
- Status Code : le code de réponse HTTP (200, 3xx, 4xx, 5xx, no response).
- Status : la réponse de l’en-tête HTTP (OK pour 200, Not Found, Moved Permanently, etc.).
- Indexability : si l’URL est indexable ou non indexable.
- Indexability Status : la raison pour laquelle une URL n’est pas indexable, par exemple canonicalisée vers une autre URL, « noindex » ou « Redirected ».
- Inlinks : le nombre de liens internes entrants vers la page, c’est-à-dire les liens qui pointent vers l’URL depuis des ressources du même sous-domaine crawlé.
- Response Time : le temps en secondes pour télécharger l’URL.
- Redirect URL : si l’URL redirige, cette colonne indique la destination.
- Redirect Type : cette colonne peut contenir
- HTTP Redirect : une redirection déclenchée par un en-tête HTTP.
- HSTS Policy : une redirection causée par un en-tête HSTS précédent.
- JavaScript Redirect : déclenchée par l’exécution de JavaScript. Disponible uniquement en mode de rendu JavaScript.
- Meta Refresh Redirect : déclenchée par une balise meta refresh dans le HTML de la page.
Filtres Status Code
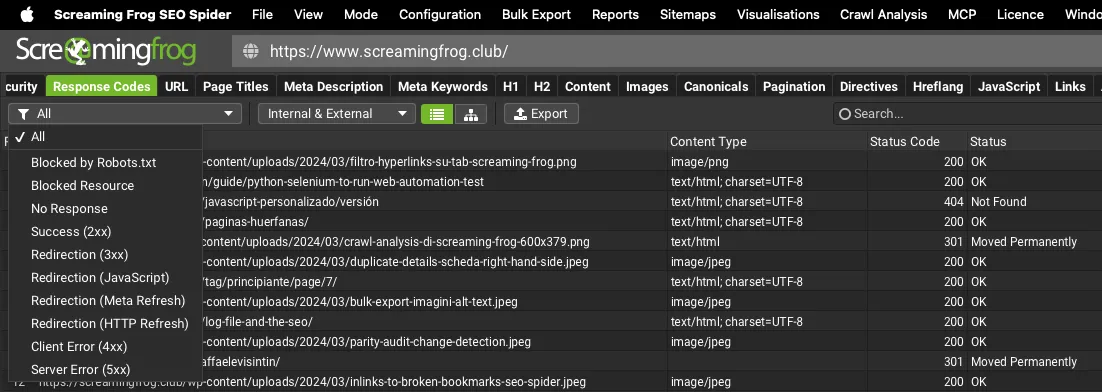
L’onglet « Response Codes » propose les filtres suivants :
- Blocked by Robots.txt : toutes les URL bloquées par le robots.txt du site, qui empêchent le robot de les crawler et donc les moteurs de les indexer.
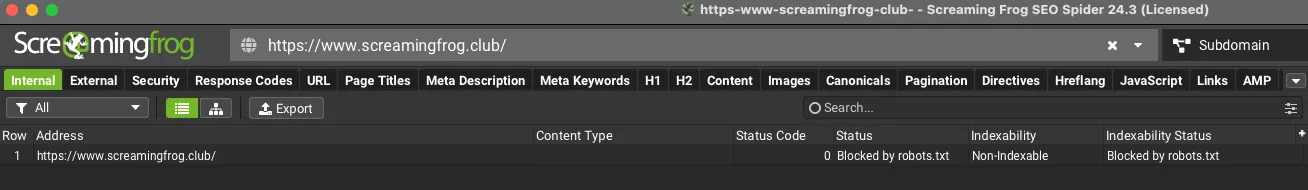
Un « 0 » dans la colonne Status Code signifie qu’il n’y a pas eu de réponse HTTP du serveur ; la colonne Status en donne la raison. Dans l’exemple ci-dessus, le user agent du Spider a été bloqué par une directive « disallow » du robots.txt : bloqué, il ne pouvait pas obtenir de réponse HTTP.
- Blocked Resource : toutes les ressources bloquées par le robots.txt, comme les images, le JavaScript et le CSS. Ce filtre ne se remplit que si le rendu JavaScript est activé. Sinon, les ressources bloquées apparaissent dans « Blocked by Robots.txt ».
- No Response : les URL qui ne répondent pas à la requête HTTP de SEO Spider. Le plus souvent, il s’agit d’une URL mal saisie, d’un délai dépassé, d’une connexion refusée ou d’une erreur de connexion. Avec ce statut, SEO Spider a du mal à établir des connexions ou à recevoir des réponses. Le problème peut venir d’un proxy.
| Address | Status Code | Status |
|---|---|---|
| https://www.screamingfrog.co.uk/no-response/ | 0 | No Response |
Le statut « DNS lookup failed » indique que le site n’a pas été trouvé du tout, à cause d’une erreur de saisie du domaine ou d’une absence de connexion réseau.
| Address | Status Code | Status |
|---|---|---|
| https://www.screamingfrog.zone/ | 0 | DNS lookup failed |
« Connection Timeout » indique que Screaming Frog a demandé la réponse HTTP au serveur sans l’obtenir dans les 20 secondes. Pour y remédier, tu peux augmenter le Response Timeout dans 1Configuration›2Spider›3Advanced ou réduire la vitesse du crawl dans 1Configuration›2Speed, pour ne pas surcharger le serveur et lui laisser plus de temps.
| Address | Status Code | Status |
|---|---|---|
| https://www.screamingfrog.co.uk/timeout/ | 0 | Connection Timeout |
« Connection Refused » est renvoyé quand la tentative de connexion de SEO Spider a été refusée quelque part entre ta machine et le site. Les causes les plus courantes sont les pare-feu et le blocage des user agents inconnus. Pour résoudre ce problème, je te conseille de passer le user agent de « Screaming Frog SEO Spider » à « Chrome » dans 1Configuration›2User-Agent.
| Address | Status Code | Status |
|---|---|---|
| https://www.screamingfrog.co.uk/refused/ | 0 | Connection Refused |
- Success (2XX) : l’URL demandée a été reçue, comprise, acceptée et traitée avec succès. Idéalement, toutes les URL d’un crawl devraient renvoyer un code « 200 » avec le statut « OK », parfait pour le crawl et l’indexation.
- Redirection (3XX) : une redirection comme une 301 ou une 302 a été trouvée. Idéalement, chaque lien interne devrait pointer vers une réponse 200, pour éviter des étapes supplémentaires au robot et préserver le budget de crawl.
- Redirection (JavaScript) : une redirection JavaScript a été trouvée.
- Redirection (Meta Refresh) : une redirection par meta refresh a été trouvée.
- Redirection (HTTP Refresh) : une redirection via l’en-tête HTTP Refresh a été trouvée.
- Client Error (4xx) : les ressources pour lesquelles la requête a posé problème. Cela peut inclure 400 Bad Request, 403 Forbidden, 404 Page Not Found, 410 Removed, 429 Too Many Requests, etc. Les erreurs client comme les 404 doivent être corrigées pour ne pas gaspiller le budget de crawl : modifie le lien source, supprime ces liens (par exemple en renvoyant un 410 via .htaccess) ou redirige-les quand c’est pertinent.
- Server Error (5XX) : le serveur n’a pas pu satisfaire une requête apparemment valide. Cela inclut des réponses courantes comme 500 Internal Server Error et 503 Service Unavailable. Un taux élevé de ces erreurs peut signaler un serveur sous pression ou une mauvaise configuration à examiner.
Des questions sur STATUS CODE?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
