

Rapports.
Vue d’ensemble des rapports disponibles dans Screaming Frog pour des analyses fines et précises.
Vue d’ensemble des rapports de SEO Spider : crawl overview, redirections, canonicals, pagination, hreflang, pages orphelines, contenus non sécurisés, données structurées, PageSpeed, en-têtes HTTP, cookies et crawl path. Pour chacun, à quoi il sert.
Rapports d’opportunités
Screaming Frog a beaucoup investi ces dernières années dans la mise à jour de son robot, et les « Reports » disponibles se sont multipliés. L’outil te permet de t’en donner à cœur joie avec les exports, grâce à toute une série de documents dédiés pour analyser précisément la plupart des problèmes.
La liste des documents se trouve dans le menu principal ; tu peux les enregistrer en local aux formats ‘.csv’, ‘.xls’, ‘xlsx’ ou en ‘gsheet’ via Google Drive. Dans ce dernier cas, tu les trouves dans le dossier « Screaming Frog SEO Spider » de Drive.
Crawl Overview
Ce rapport reprend les données de la barre latérale de SEO Spider.
C’est un résumé synthétique du crawl, très utile en première approche pour avoir une vue d’ensemble de chaque onglet et de ses filtres.
Redirects
Ces documents se concentrent sur les redirections découvertes pendant le crawl, en identifiant l’origine du lien.
Il existe actuellement trois rapports :
- All Redirects : affiche chaque redirection et signale les éventuelles chaînes.
- Redirect Chains : regroupe les URL avec 2 redirections consécutives ou plus, qui forment une dangereuse « chaîne de redirections ».
- Redirect and Canonical Chains : identifie les URL avec au moins 2 redirections et des chaînes d’URL « canonical ».
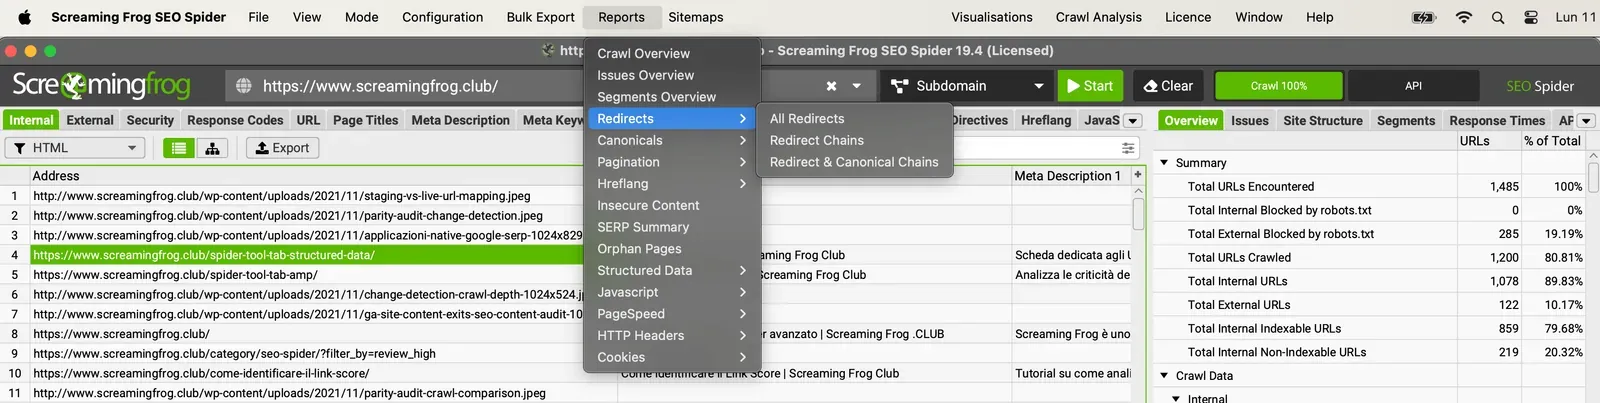
Les documents « Redirect Chains » et « Redirect and Canonical Chains » sont très utiles pour cartographier les chaînes de redirections et de canonicals et les « boucles », en voyant le nombre d’étapes et les URL sources.
En mode Spider (1Mode›2Spider), ces rapports affichent toutes les redirections découvertes à partir d’une seule étape.
Le document est organisé en colonnes et comprend :
- le « nombre de redirections » ;
- le type de chaîne identifié :
- HTTP Redirect,
- JavaScript Redirect,
- Canonical,
- etc. ;
- la présence éventuelle de boucles de redirection.
Si le rapport est vide, le Spider n’a trouvé ni boucle ni chaîne de redirections à optimiser.
Tu peux aussi télécharger les rapports ‘Redirects’, ‘Redirect Chains’ et ‘Redirect & Canonical Chains’ en mode liste (1Mode›2List). Le document affiche alors une ligne pour chaque URL de la liste.
En cochant « Always Follow Redirects » et « Always Follow Canonicals », SEO Spider continue à crawler redirections et canonicals en mode liste, sans tenir compte de la profondeur. En bref, il suit toutes les étapes jusqu’à la destination finale.
À noter : les documents sur les redirections te seront particulièrement utiles pendant une migration, pour vérifier que le classement acquis est bien transmis et ne pas gaspiller de Crawl Budget.
Canonical
Les documents ‘Canonical Chains’ et ‘Non-Indexable Canonicals’ mettent en évidence les erreurs et problèmes des éléments link canonical ou des canonicals HTTP.
1. Le rapport « Canonical Chains » signale toute URL avec plus de 2 liens canoniques en chaîne :
- l’URL A est « canonicalisée » avec une « URL canonique » vers l’URL B ;
- l’URL B est elle-même « canonicalisée » vers l’URL C.
2. Le rapport ‘Non-Indexable Canonicals’ met en évidence les erreurs des liens canoniques. Il montre notamment tous les liens canoniques qui pointent vers des URL bloquées par le robots.txt, en 3XX, 4XX ou 5XX, ou tout autre statut qu’une réponse 200 ‘OK’.
Ce rapport fournit aussi des données sur toutes les URL découvertes par SEO Spider via un lien « canonical » mais sans aucun lien interne depuis le site.
Cette information figure dans la colonne ‘unlinked’ avec la valeur ‘true’.
Pagination
SEO Spider propose deux rapports sur la pagination :
- « Non-200 Pagination URLs »
- « Unlinked Pagination URLs »
Ces deux documents sont très utiles pour repérer les erreurs des attributs de pagination « rel=prev » et « rel=next ».
« Non-200 Pagination URLs » identifie chaque URL dont les attributs « rel=prev » et « rel=next » pointent vers des ressources avec un code de statut autre que 200.
« Unlinked Pagination URLs » t’aide à repérer toutes les URL découvertes par SEO Spider grâce aux attributs « next/prev » mais qui n’ont aucun lien interne sur le site.
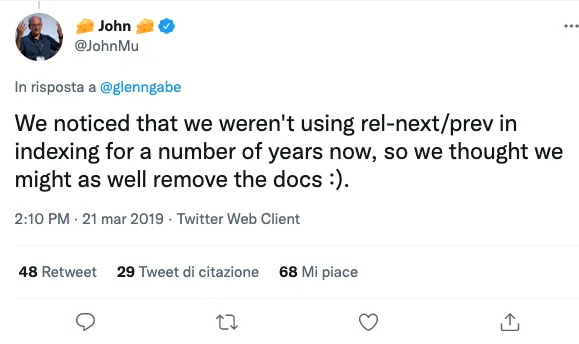
Au moment de la rédaction de ce guide, Google ne prend plus en compte ces attributs, mais d’autres moteurs les utilisent encore.
Hreflang
La balise hreflang indique à Google les différentes versions linguistiques d’une page pour qu’il serve la plus adaptée à l’internaute selon son navigateur.
Screaming Frog propose 7 documents téléchargeables, chacun avec un angle différent sur l’attribut :
- All Hreflang URLs : le rapport le plus complet, qui collecte toutes les URL et URL hreflang, avec les indications de région et de langue découvertes pendant le crawl.
- Non-200 Hreflang URLs : montre les pages qui ont des liens hreflang vers des pages avec un code de statut autre que 200 (no response, blocked by robots.txt, réponses 3XX, 4XX ou 5XX).
- Unlinked Hreflang URLs : liste toutes les URL découvertes via un lien hreflang mais qui n’ont aucun hyperlien sur le site (par ex. pages orphelines).
- Missing Confirmation Links : identifie les URL auxquelles il manque le « lien de confirmation ». Par exemple, la page A a un hreflang vers la page B et indique au robot que A et B sont deux versions linguistiques du même contenu, mais B n’a pas de hreflang vers A, ce qui crée une incohérence.
- Inconsistent Language Confirmation Links : montre les pages de confirmation qui utilisent des codes de langue incohérents et différents pour le même contenu.
- Non Canonical Confirmation Links : montre les URL dont le hreflang pointe vers des éléments « non canoniques ». Si tu « canonicalises » un élément, tu indiques au robot que ce contenu a une version principale « canonique » : c’est donc celle-ci que ton hreflang devrait indiquer.
- Noindex Confirmation Links : idéal pour repérer les URL dont le hreflang pointe vers des ressources en « noindex ». Là aussi, envoyer le robot vers des ressources « non indexables » crée une énorme contradiction entre le choix de bloquer un contenu et celui de demander à le servir comme version linguistique.
Pages orphelines
Les pages orphelines sont les URL qui ne reçoivent aucun lien interne depuis les autres pages du site et que le crawler ne peut pas atteindre, car isolées.
Le rapport « Orphan Pages » liste les URL collectées via la connexion de SEO Spider aux API de Google Analytics et de Google Search Console (Search Analytics API), ou trouvées dans le sitemap XML, qui ne correspondent à aucune URL découverte pendant le crawl.
En bref, il te fournit les URL que SEO Spider n’a pas pu atteindre faute de liens à suivre, ou parce que les liens sont en « nofollow ».
Mais si elles n’ont pas de liens, pourquoi existent-elles dans les bases de Google Analytics ou de la Search Console ?
Elles ont sans doute été indexées avec une ancienne version du site ou via d’autres sources comme les sitemaps XML, ou bien des referrals pointent vers elles.
Pour collecter des données sur les pages orphelines, il suffit de configurer les API dans les réglages de SEO Spider.
Depuis 1Configuration›2API Access, choisis les API à connecter et relie un nouveau compte ou un compte déjà configuré.
À la fin du crawl, il faut lancer la « Crawl Analysis » pour remplir l’onglet correspondant.
Les sources disponibles pour contrôler les pages orphelines sont :
- GA : l’URL a été découverte via l’API Google Analytics.
- GSC : l’URL a été découverte dans Google Search Console, via la Search Analytics API.
- Sitemap : l’URL a été découverte via le sitemap XML.
- GA & GSC & Sitemap : l’URL a été découverte dans Google Analytics, Google Search Console et le sitemap XML.
Bonne pratique : pour optimiser ton analyse SEO avec l’API Google Analytics 4, je te conseille d’utiliser la page de destination comme dimension et de filtrer le canal « Organic Search », pour obtenir des données plus pertinentes et éviter les pages de connexion, de panier, etc.
Insecure Content
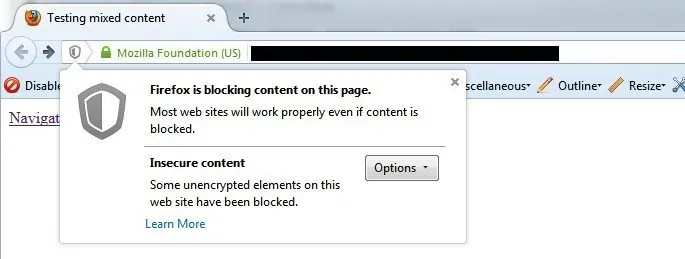
Ce rapport est très utile, car il signale les URL qui contiennent des contenus jugés non sécurisés et t’aide à éviter les avertissements de sécurité des navigateurs qui pourraient faire fuir les visiteurs.
Le document « Insecure Content » liste toutes les URL sécurisées (HTTPS) qui chargent des éléments non sécurisés en HTTP, comme des liens internes, images, JS, CSS, SWF ou images externes sur un CDN, profils sociaux, etc.
Le rapport est surtout utile pendant une migration, pour avoir une vision complète des problèmes potentiels.
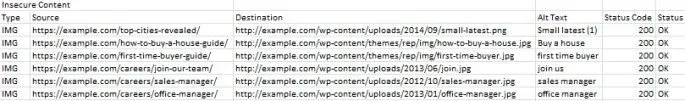
Voici un exemple de fichier où les destinations des images sont en « http » et ne sont pas jugées fiables par le robot.
Données structurées
Tu le sais, les données structurées informent le moteur et, bien gérées, apportent d’énormes bénéfices de visibilité grâce aux différentes fonctionnalités de recherche.
Screaming Frog propose 4 rapports pour évaluer et corriger les problèmes de validation des données structurées :
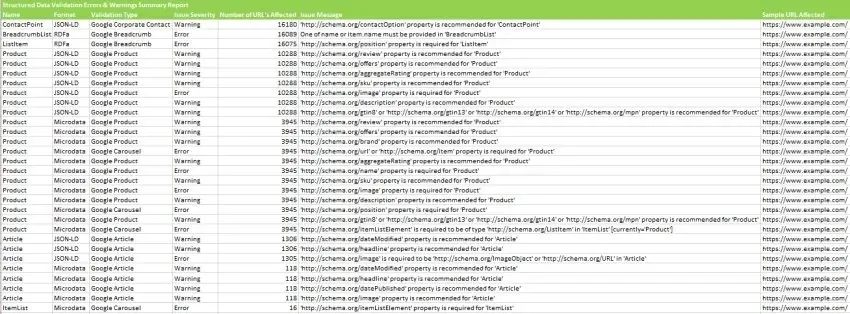
- Validation Errors & Warnings Summary : regroupe les données structurées par erreurs et avertissements de validation uniques, avec le nombre d’URL concernées par chaque problème et des URL d’exemple.
- Validation Errors & Warnings : affiche en détail chaque erreur de validation pour chaque URL, avec le nom de la propriété (Organization, etc.), le format (JSON-LD, etc.), la gravité (erreur ou avertissement), le type de validation (Google Product, etc.) et le message (par ex. /review property is required).
- Google Rich Results Features Summary : regroupe les données par « Google Rich Results Features » détectées dans un crawl, avec le nombre d’URL pour chaque fonctionnalité.
- Google Rich Results Features : associe chaque URL aux fonctionnalités disponibles et montre lesquelles ont été détectées pour chaque URL.
PageSpeed
Ce rapport s’appuie sur l’API PageSpeed Insights et fournit tous les principaux indicateurs de temps de chargement, pour un diagnostic très précis de ce qui bloque ou freine les performances.
Il s’active dans 1Configuration›2API Access›3PageSpeed Insights.
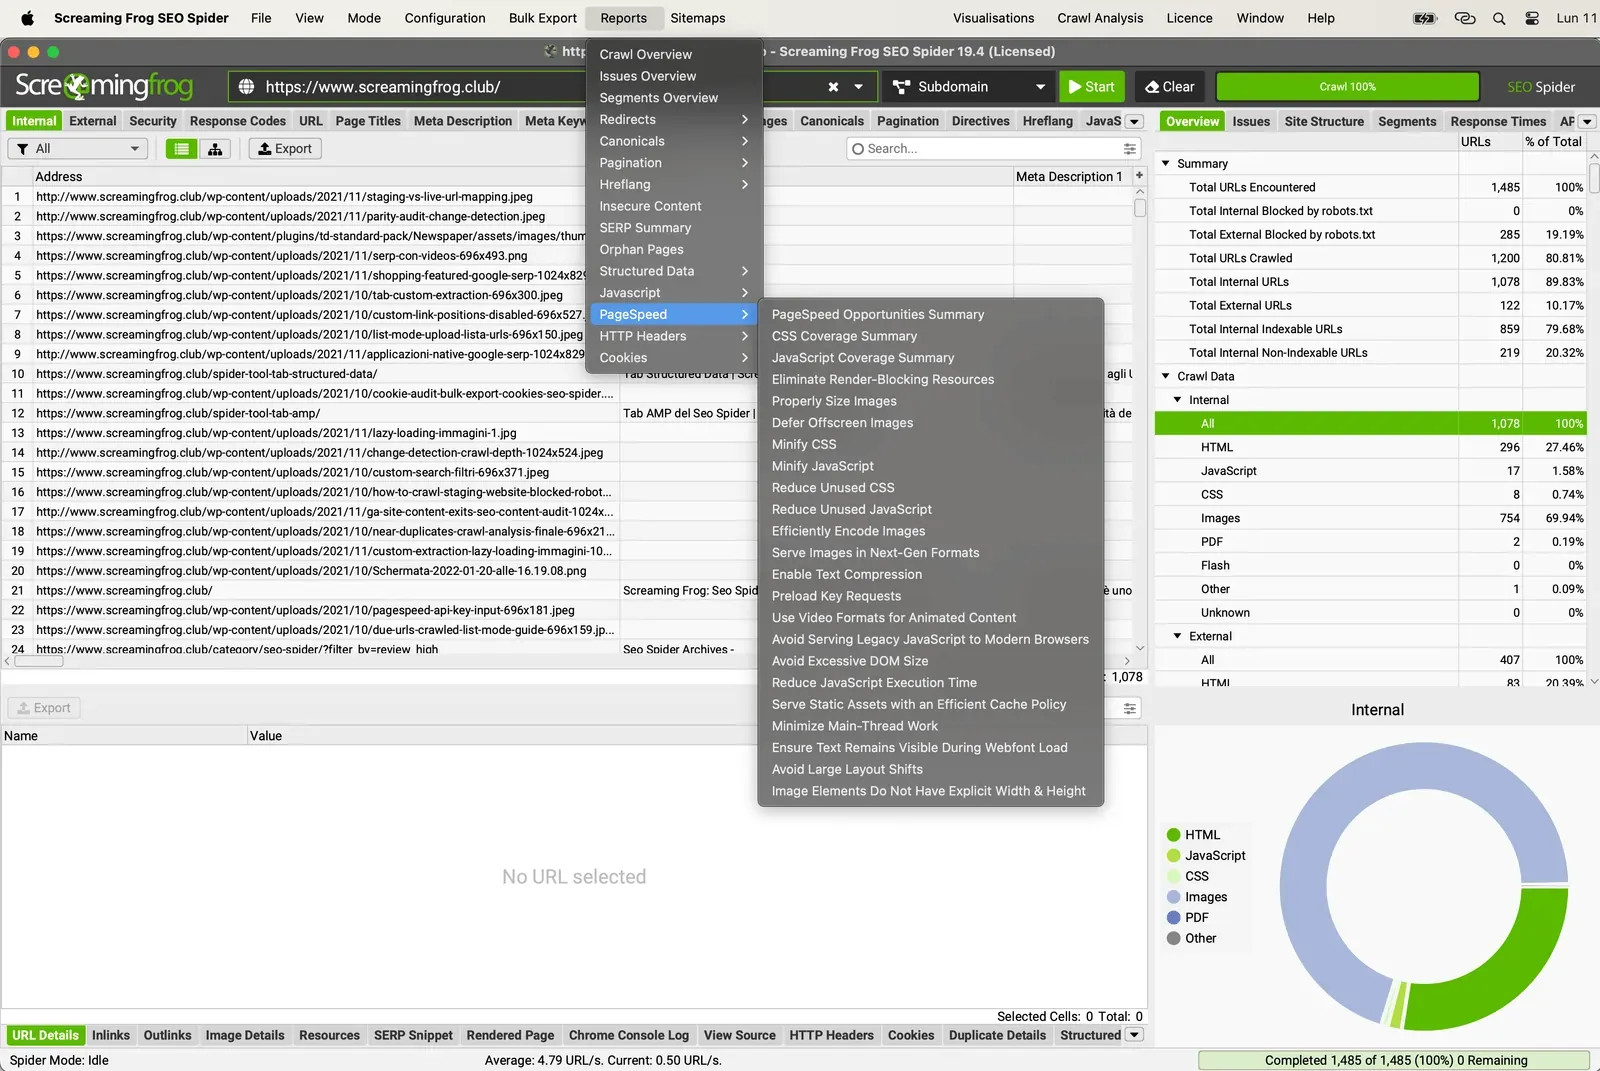
- PageSpeed Opportunities Summary : résume toutes les opportunités uniques trouvées sur le site, le nombre d’URL concernées et le gain potentiel moyen et total en taille et en millisecondes, pour prioriser les interventions.
- CSS Coverage Summary : indique le gain de temps possible en supprimant le code inutilisé de chaque CSS chargé sur le site.
- JavaScript Coverage Summary : montre la part inutilisée de chaque fichier JS pendant le crawl et le gain possible en supprimant ce code.
HTTP Header Summary
Ce document offre une vue agrégée de tous les en-têtes de réponse HTTP découverts pendant un crawl. Il affiche chaque en-tête unique et le nombre d’URL uniques qui ont répondu avec.
Pour le remplir, active HTTP Headers dans 1Configuration›2Spider›3Extraction.
Tu trouves les détails par URL et par en-tête dans l’onglet « HTTP Headers » de la fenêtre inférieure et via l’export 1Bulk Export›2Web›3All HTTP Headers.
Tu peux aussi consulter les en-têtes HTTP directement dans l’onglet « Internal », où ils sont ajoutés dans des colonnes distinctes.
Cookie Summary
Le rapport « Cookie Summary » offre une vue agrégée des cookies uniques découverts pendant un crawl, avec leur nom, leur domaine, leur expiration et les valeurs Secure et HttpOnly.
Il indique aussi le nombre d’URL sur lesquelles chaque cookie a été déposé.
Pour utiliser ce rapport, il suffit d’activer Cookies dans 1Configuration›2Spider›3Extraction.
N’oublie pas d’activer aussi le rendu JavaScript pour une vision précise des cookies chargés via JavaScript ou des pixels.
Ce rapport agrégé est extrêmement utile pour la conformité au RGPD.
Tu trouves plus de détails dans l’onglet « Cookies » de la fenêtre inférieure et via l’export 1Bulk Export›2Web›3All Cookies.
Crawl Path
Contrairement aux précédents, le « Crawl Path Report » ne se trouve pas dans le menu principal.
Il est disponible en faisant un clic droit sur une URL de la fenêtre supérieure de SEO Spider et en choisissant 1Export›2Crawl Path Report.
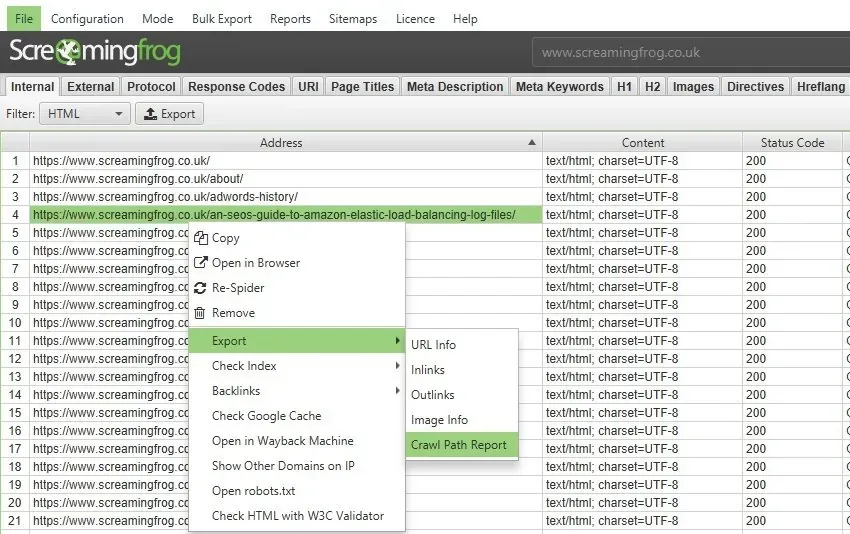
Ce rapport montre le chemin le plus court suivi par SEO Spider pendant le crawl pour découvrir l’URL.
C’est très utile pour les pages avec une « Crawl Depth » très profonde, et cela t’évite de parcourir les ‘inlinks’ de nombreuses URL pour trouver la source d’origine ; on peut s’en servir pour diagnostiquer les URL infinies causées par des plugins ou des calendriers.
Le rapport se lit de bas en haut. La première URL en bas de la colonne ‘source’ est la première URL crawlée (niveau ‘0’).
La colonne ‘destination’ montre les URL crawlées ensuite, qui deviennent les URL ‘sources’ du niveau suivant (1), et ainsi de suite vers le haut.
La première URL de la colonne ‘destination’, en haut du rapport, est l’URL dont on a reconstitué le chemin.
Des questions sur Rapports?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
