

ONGLET DIRECTIVES.
Analyse de la balise meta robots et de l’X-Robots-Tag dans l’en-tête HTTP.
Ce que tu trouves dans l’onglet Directives de SEO Spider : meta robots et X-Robots-Tag, leur interaction avec le robots.txt et la signification de chaque filtre, de noindex à unavailable_after.
Présentation de l’onglet Directives
L’onglet des directives affiche les données de la balise meta robots et de l’X-Robots-Tag dans l’en-tête HTTP. Ces directives robots contrôlent la façon dont ton contenu et tes URL apparaissent dans les moteurs de recherche comme Google.
Pour comprendre leur importance, imagine deux scénarios que peut rencontrer le robot du moteur :
- Le robots.txt est absent ou autorise le crawl d’une URL : les moteurs considèrent la ressource comme crawlable et indexable, sauf si des directives plus précises sont définies via les meta robots.
- Le robots.txt bloque l’URL en « disallow » : dans ce cas, les meta robots ne seront pas lues et leurs instructions ne seront pas appliquées.
La balise meta robots doit être placée dans le head de la page HTML, ou dans l’en-tête HTTP avec l’X-Robots-Tag, et plusieurs directives peuvent être combinées :
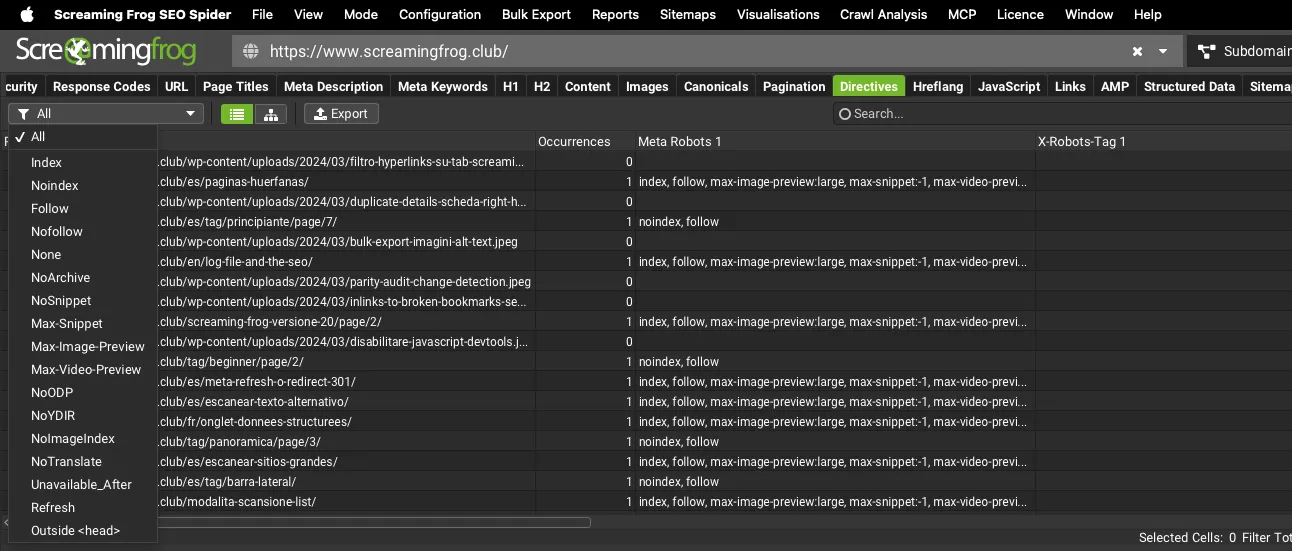
<meta name="robots" content="noindex, nofollow">X-Robots-Tag: noindex, nofollowL’onglet présente trois colonnes : la première pour l’adresse de l’URL (Address), les autres pour les meta robots et l’X-Robots-Tag, dont SEO Spider collecte toutes les occurrences.
Filtres
Les filtres disponibles sont :
-
Index : les pages avec l’attribut « index » ; il n’est pas nécessaire, car les moteurs indexent les URL même sans cette directive.
-
Noindex : cet attribut indique aux moteurs de ne pas indexer la page. Il ne bloque pas le crawl ! Il peut être défini globalement ou pour un moteur précis.
-
Follow : la directive « follow » indique au robot de suivre tous les liens de la page. En son absence, les moteurs suivent les liens par défaut.
-
Nofollow : une « indication » qui demande aux moteurs de ne suivre aucun lien de la page pour le crawl. Elle est souvent utilisée en préproduction avec « noindex » pour éviter les crawls avant la mise en ligne.
Pour crawler des pages avec cette directive, active l’option « Follow Internal Nofollow » dans 1Configuration›2Spider›3Crawl.
N’oublie pas : avec cette directive, les liens de la page ne transmettent pas de PageRank. -
None : la meta « none » ne signifie pas l’absence de directives ; au contraire, elle est très restrictive et combine « noindex » et « nofollow ».
-
NoArchive : indique à Google de ne pas afficher la copie en cache de la page dans les résultats. Depuis 2024, Google a supprimé la copie en cache et l’opérateur « cache: », cette directive a donc peu d’effet aujourd’hui.
-
NoSnippet : empêche le moteur (actuellement seulement Google) d’afficher un extrait comme la meta description dans les résultats.
-
Max-Snippet : limite la longueur de l’extrait textuel de la page dans Google à [nombre] caractères. Valeurs spéciales : 0 pour aucun extrait, ou -1 pour une longueur illimitée.
-
Max-Image-Preview : définit la taille maximale de l’aperçu d’image de la page dans Google. Les valeurs possibles :
- « none » : aucun aperçu d’image ;
- « standard » : un aperçu d’image par défaut peut être affiché ;
- « large » : un aperçu plus grand, jusqu’à la largeur de la zone visible, peut être affiché.
-
Max-Video-Preview : indique à Google d’utiliser au maximum [nombre] secondes comme extrait pour les vidéos de la page. Tu peux aussi indiquer 0 pour n’autoriser qu’une image fixe, ou -1 pour une durée illimitée.
-
NoODP : une meta obsolète qui demandait à Google de ne pas utiliser l’Open Directory Project (DMOZ) pour ses extraits. Elle peut être supprimée sans souci.
-
NoYDIR : une ancienne meta qui demandait de ne pas utiliser le Yahoo Directory pour les extraits. Elle peut être supprimée.
-
NoImageIndex : indique à Google de ne pas indexer les images d’une page HTML. Si les images d’une URL en « noimageindex » sont aussi liées depuis d’autres pages, elles peuvent quand même être indexées. Pour l’éviter, définis un X-Robots-Tag dans l’en-tête HTTP du fichier image.
-
NoTranslate : indique à Google de ne pas proposer de traduction de la page dans les résultats. Sinon, le moteur peut afficher un lien à côté du résultat pour voir la page traduite.
-
Unavailable_After : permet d’indiquer la date et l’heure exactes à partir desquelles Google doit cesser d’afficher la page dans les résultats. Très utile pour les pages d’événements, de salons, de promotions limitées, etc.
-
Refresh : redirige l’utilisateur vers une nouvelle URL après un certain délai.
-
Outside <head> : les pages avec une meta robots hors du head, que les moteurs peuvent ignorer.
Des questions sur ONGLET DIRECTIVES?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
