

Embeddings SEO avec Screaming Frog.
Guide pratique de l’analyse sémantique
Comment utiliser les embeddings avec Screaming Frog et l’API d’OpenAI pour travailler sur le sens des pages, et non sur les mots-clés. Tu calcules la similarité sémantique, trouves les doublons cachés, guides le maillage interne et crées des clusters avec un script Python prêt à l’emploi.
Que sont les embeddings ?
Les embeddings traduisent les mots en nombres (vecteurs). Imagine transformer chaque page de ton site en une coordonnée GPS multidimensionnelle :
- Vectorisation : l’IA transforme le texte en une liste de nombres (par ex. [0.1, -0.5, 0.8]).
- Proximité : deux pages qui traitent du même sujet auront des vecteurs proches dans l’espace mathématique, même avec des mots différents (par ex. « voiture » et « automobile »).
- Application SEO : cela nous aide à comprendre comment Google regroupe nos contenus et à repérer les « trous » sémantiques de notre structure.
Les embeddings deviennent rapidement un élément fondamental de l’intelligence artificielle (IA) et du machine learning (ML). Ces outils puissants permettent de représenter des données complexes dans des formats plus maniables, ce qui améliore nettement l’efficacité des algorithmes d’apprentissage automatique.
Les embeddings sont des représentations vectorielles d’objets complexes comme des mots, des images ou des utilisateurs. Ils transforment des données non numériques en une forme numérique facile à traiter pour les algorithmes de ML.
Transformer ces données en représentations vectorielles te permet de découvrir efficacement des relations et des schémas très utiles pour piloter des analyses complexes.
La dimension d’un vecteur dépend du modèle d’embedding utilisé et détermine sa capacité à représenter le sens d’un mot ou d’un document par une série de nombres exploitable par les robots.
La dimension du vecteur représente la profondeur d’analyse encodée dans l’espace d’embedding.
Mais quelles données peut-on tirer de ces vecteurs ? Dans l’embedding de mots, par exemple, on peut dégager des aspects sémantiques, syntaxiques et contextuels ; plus le vecteur est grand, plus l’information est détaillée. On voit ainsi comment l’analyse SEO passe de l’étude aseptisée des « mots-clés » à la découverte de l’« intention de recherche », non pas selon notre jugement personnel mais sur la base d’analyses poussées, de plus en plus proches de celles des robots des moteurs.
Les avantages des embeddings
- Réduction de la dimensionnalité : les embeddings réduisent la complexité des données d’origine tout en gardant les informations pertinentes. Cela rend la manipulation et l’analyse plus efficaces et, en SEO, ce sont de vraies mines d’or pour des analyses toujours plus proches du comportement des robots.
- Meilleures performances des algorithmes : en capturant les relations sémantiques, les embeddings améliorent l’exactitude et la précision des algorithmes de ML, notamment en traitement du langage naturel (NLP) et en reconnaissance d’images.
- Flexibilité et polyvalence : les embeddings s’appliquent à de nombreux types de données et secteurs, des recommandations de produits à l’analyse de sentiment. Par exemple, en attribuant des séries de nombres aux mots selon leur similarité sémantique, le « word embedding » permet aux réseaux de neurones de comprendre le contexte bien plus finement et de le traiter.
Applications des embeddings en SEO
- Traitement du langage naturel (NLP) : en NLP, les embeddings de mots comme Word2Vec et GloVe aident les modèles à mieux comprendre le contexte et le sens des mots. Ils ont révolutionné la traduction automatique, l’analyse de sentiment et les chatbots intelligents. Les word embeddings sont utiles pour l’analyse et le ciblage des mots-clés, car ils montrent le sens des mots et leurs relations, et révèlent des schémas et tendances dans les textes, en identifiant les requêtes les plus importantes d’un texte. C’est utile en SEO pour identifier les mots-clés les plus utilisés par les internautes qui cherchent un produit ou un service. En comprenant les relations entre les mots, ils aident aussi à repérer synonymes et termes associés utiles au ciblage et les termes de recherche potentiels que les utilisateurs pourraient employer.
- Recommandations de produits : une application très utile concerne l’e-commerce, où l’analyse des embeddings permet de présenter de façon précise et stratégique les produits associés selon leurs similarités et les préférences des utilisateurs. Cela améliore l’expérience client et les ventes, au-delà des produits « complémentaires » ou de même catégorie que proposent automatiquement les CMS les plus répandus. Les embeddings permettent des stratégies toujours plus précises et performantes, à la recherche de l’équilibre entre offre et demande.
- Reconnaissance d’images : les embeddings servent aussi à identifier et classer des objets dans les images. Des techniques comme les réseaux de neurones convolutifs (CNN) génèrent des embeddings qui représentent les caractéristiques visuelles et améliorent la reconnaissance.
- SEO et marketing digital : les embeddings servent aussi à améliorer les stratégies SEO et marketing, en permettant de mieux comprendre le comportement des utilisateurs et de créer des contenus plus efficaces.
Voyons plus en détail les applications SEO des embeddings :
- Clustering : en SEO, les « clusters » sont des groupes de contenus liés autour d’un sujet principal. Chaque cluster comprend une « pillar page » centrale qui couvre largement le sujet et des pages de soutien plus précises qui approfondissent des sous-thèmes. Cette approche organise mieux le contenu, améliore la navigation et l’expérience, et favorise une meilleure indexation. Les clusters renforcent aussi l’autorité du site sur des thèmes précis et améliorent le classement organique.
- Classification : attribution de catégories à des mots ou documents à partir de modèles entraînés.
- Recommandations : suggestion d’articles pertinents aux utilisateurs.
- Mesure de la similarité et de la diversité : évaluation des ressemblances et différences entre mots et documents. Cela t’aide à éviter les contenus dupliqués et à gérer les risques de « cannibalisation » des requêtes, avec des analyses très fines qui captent même les moindres détails des pages crawlées.
- Détection d’anomalies : identification des éléments qui s’écartent nettement du reste des données, pour optimiser l’architecture interne ou retravailler les contenus.
- Recherche d’informations ciblées : extraction d’informations pertinentes dans de grands jeux de données.
- Traduction : les embeddings aident la traduction en fournissant une représentation commune des mots dans différentes langues. Pour traduire un mot, un modèle doit en comprendre le sens dans les deux langues ; les word embeddings le permettent en représentant les mots indépendamment de la langue, de sorte que l’embedding d’un mot dans une langue peut être comparé à celui du même mot dans une autre. Cette approche dépasse donc la traduction lexicale et syntaxique classique et produit des contenus contextualisés dans chaque version linguistique, ce qui aide à mieux se positionner dans les SERP étrangères.
- Analyse de sentiment : pour créer un lexique de sentiments ou d’émotions avec les word embeddings, on peut commencer par sélectionner des mots ou expressions connus pour être associés à certains sentiments : annotés par des humains, ou couramment utilisés sur les réseaux sociaux pour exprimer des émotions. Ensuite, on crée des vecteurs pour chacun, avec un modèle de word embedding pré-entraîné ou à partir de zéro avec des algorithmes d’apprentissage et un grand corpus. Ces vecteurs servent ensuite à identifier le sentiment associé à d’autres mots ou expressions : si un mot est proche d’un vecteur du lexique associé à un sentiment, on peut en déduire qu’il l’est aussi (source : https://marketbrew.ai/word-embeddings-a-comprehensive-guide).
- Génération de contenus : les informations des embeddings peuvent servir à générer de nouvelles phrases liées au texte d’origine. Par exemple, pour un texte sur l’outdoor, les word embeddings identifient des mots et expressions pertinents comme « camping » ou « vie en plein air » pour rendre la page plus pertinente pour l’intention de recherche « outdoor ». Au-delà de la génération de contenus, ils permettent de calculer la similarité sémantique d’une requête avec les autres d’un vocabulaire (cosine similarity), pour un contenu plus agréable à lire, sans un texte écrit uniquement pour le SEO. Une cosine similarity élevée indique des vecteurs proches ; une faible indique qu’ils sont différents et ne seront pas considérés comme des synonymes sémantiques par le robot.
- Prédiction contextuelle des mots : les embeddings améliorent la précision de l’autocomplétion ou du texte prédictif. Ils captent le contexte des mots et peuvent donc prédire le mot suivant à partir des précédents, pour l’autocomplétion de la recherche interne. Avec l’analyse, toujours utile, des requêtes internes dans Google Analytics 4, cela améliore l’UX, par exemple de ton e-commerce, et sert la meilleure proposition à l’acheteur potentiel.
Dans les guides précédents, on a souligné l’importance des analyses N-gram, mais avec les embeddings tu passes à un tout autre niveau.
En termes d’efficacité SEO, les word embeddings présentent plusieurs avantages. D’abord, ils offrent une compréhension moins approximative du sens et du contexte des mots dans un document, utile pour évaluer la pertinence et la qualité d’une page, par rapport à une analyse fondée sur la fréquence des entités, valable pour l’architecture interne mais moins précise que le scénario décrit ici. De plus, les N-grams ne permettent pas d’identifier les termes associés : leur puissance d’analyse est donc nettement plus limitée.
Screaming Frog, embeddings et API ChatGPT
Pour activer l’analyse sémantique dans le crawler, suis ces étapes :
- Prépare la clé API : va sur la plateforme OpenAI, génère une nouvelle clé secrète et copie-la.
- Configure le Custom JavaScript :
- Ouvre Screaming Frog et va dans 1Configuration›2Custom›3Custom JavaScript.
- Clique sur « Add from Library » (en bas à droite).
- Sélectionne le snippet officiel : (ChatGPT) Extract embeddings from page content.
- Saisis la clé :
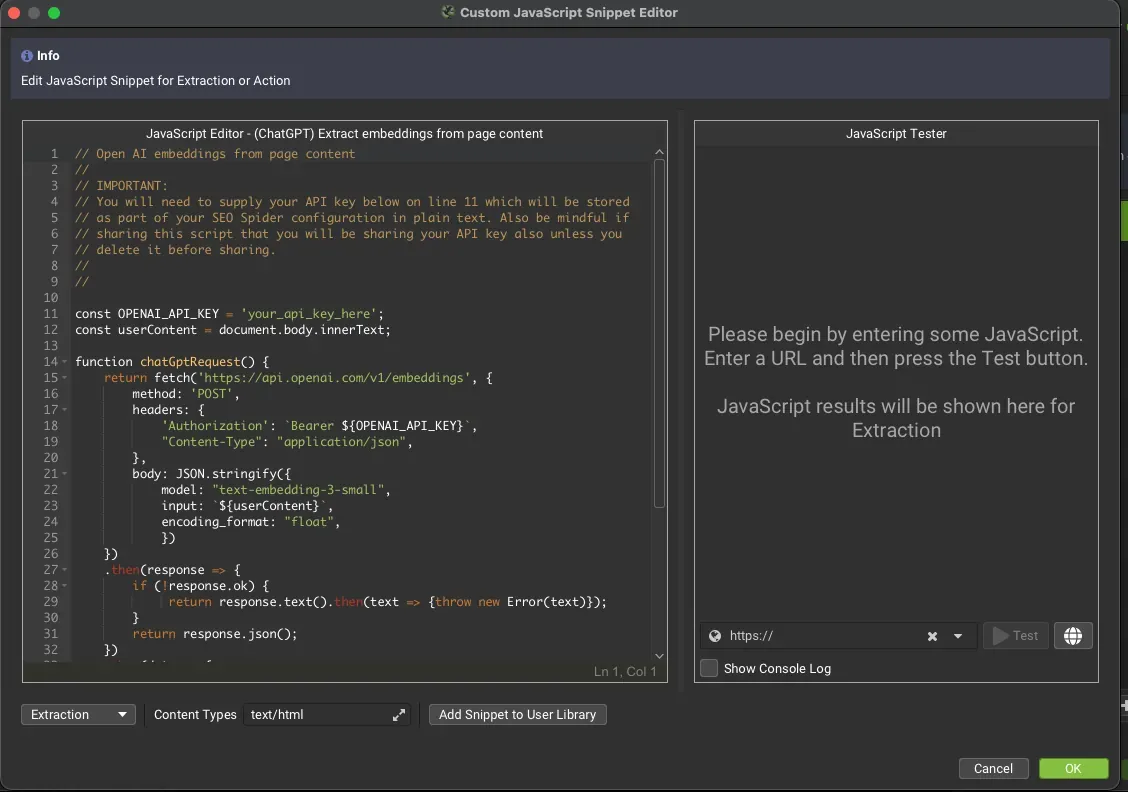
- Clique sur l’icône « JS » du snippet ajouté.
- Colle ta clé API à la ligne 11 du snippet, à la place de
your_api_key_heredansconst OPENAI_API_KEY.
- Lance le crawl : le logiciel interrogera OpenAI pour chaque URL et enregistrera le vecteur dans l’onglet Custom JavaScript.
La version 20 de Screaming Frog SEO Spider a introduit les embeddings générés avec un modèle d’OpenAI, via l’API, directement par une fonction intégrée de l’outil.
Pour cela, Screaming Frog permet d’exécuter du JavaScript personnalisé, disponible dans 1Configuration›2Custom›3Custom JavaScript, où tu choisis le script dédié et saisis ta clé API OpenAI pour générer des embeddings pendant le crawl.
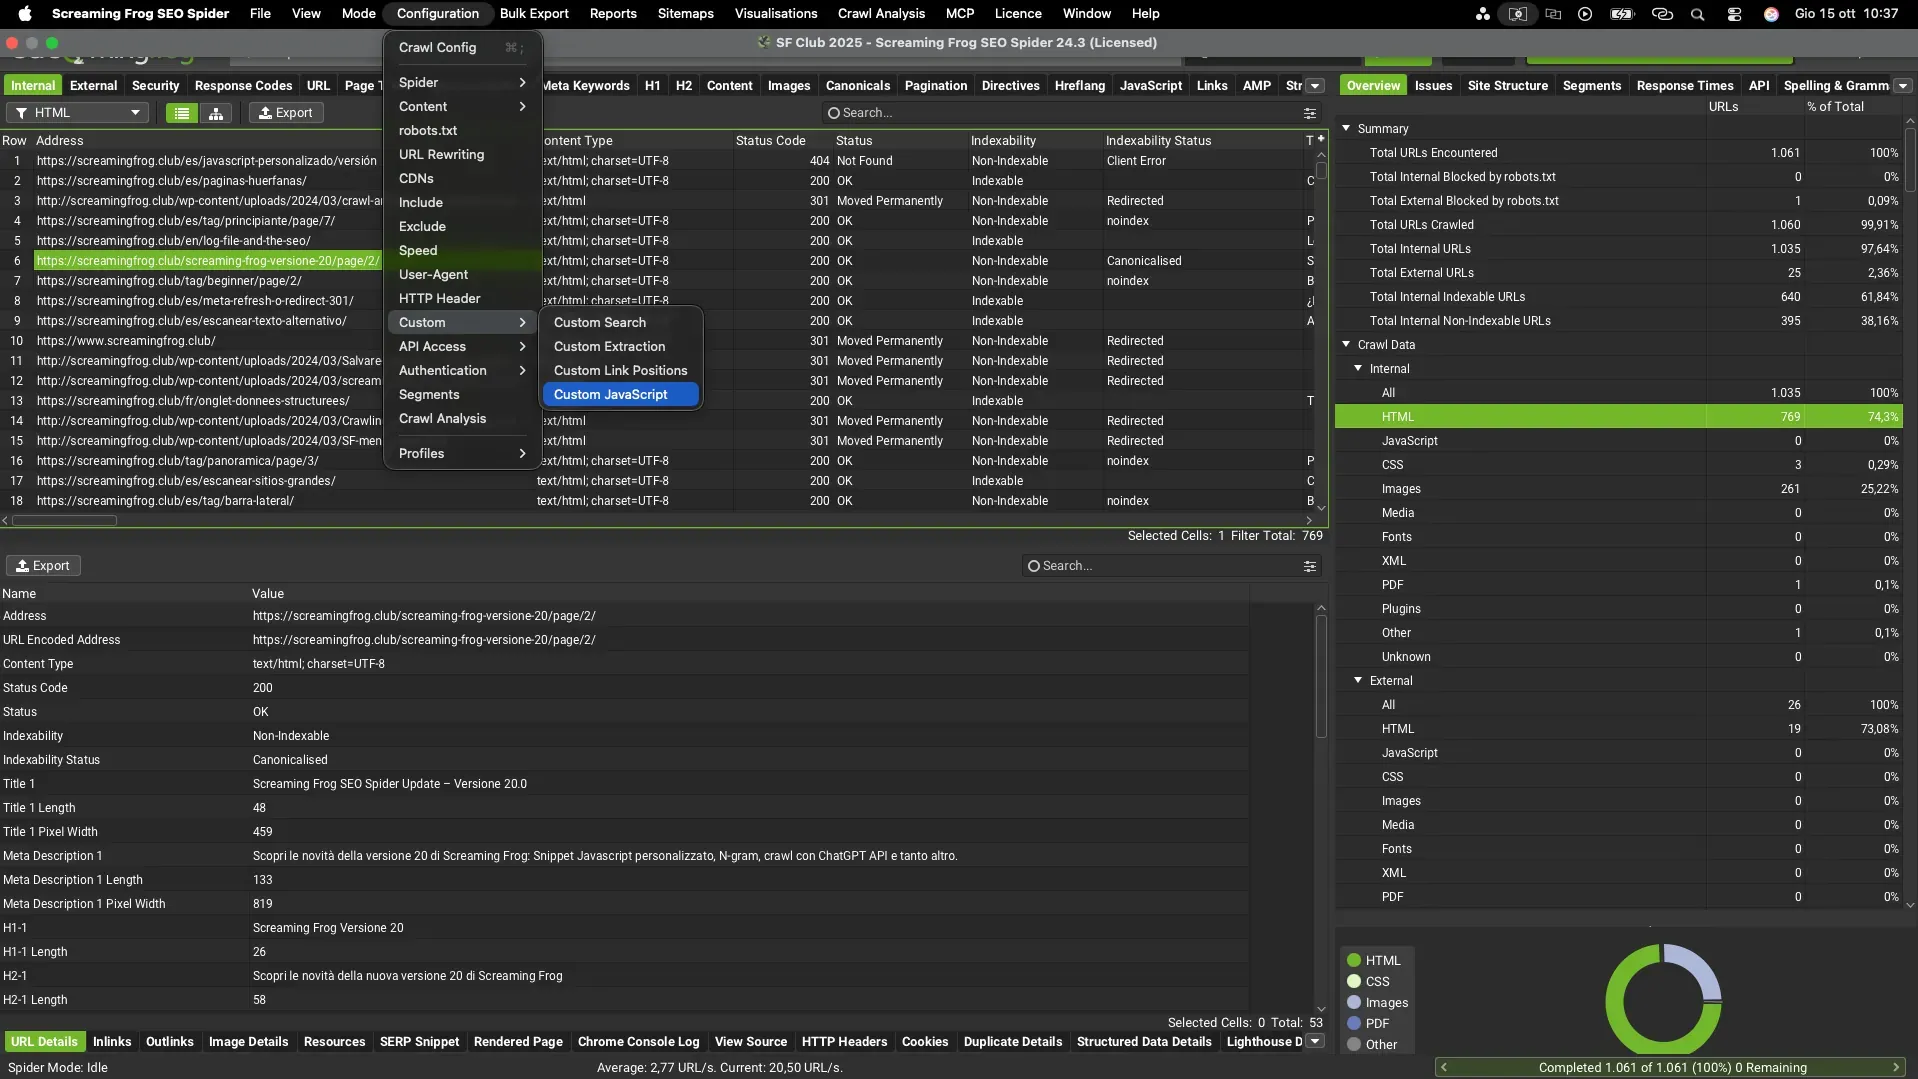
Une fois dans Custom JavaScript, il suffit de cliquer sur « +Add from Library » et de choisir le snippet de Screaming Frog « (ChatGPT) Extract embeddings from page content ».
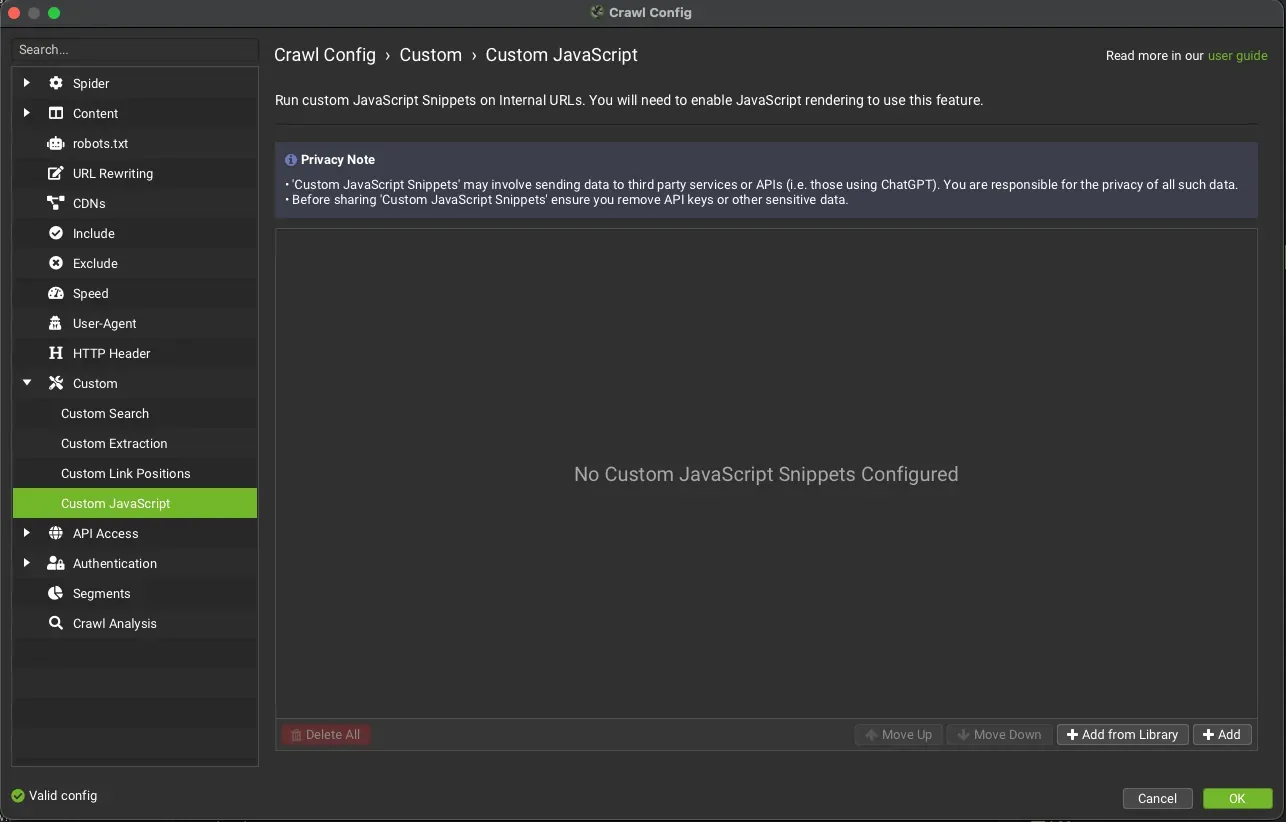
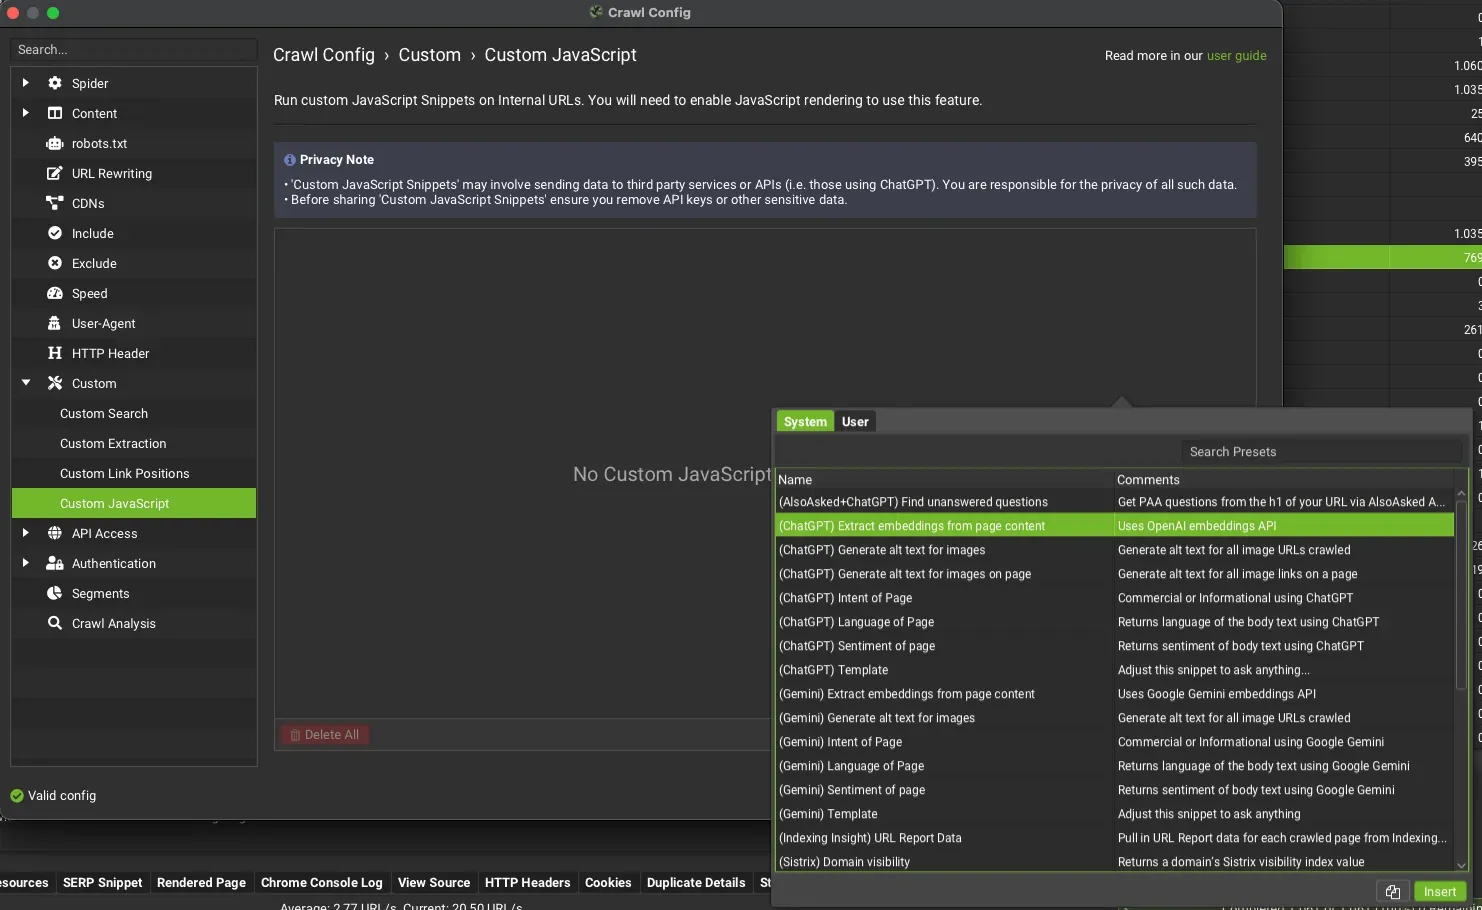
En cliquant sur l’icône « JS », tu peux modifier le script et saisir la clé API générée sur OpenAI.

Voici l’écran où saisir ta clé API. Une fois collée dans le champ prévu, il suffit de lancer le crawl avec Screaming Frog pour obtenir les embeddings. L’API étant payante, je te conseille d’utiliser le « JavaScript Tester » avec une URL pour prévisualiser le résultat d’un crawl complet.
Les résultats du « Custom JavaScript » s’affichent dans l’onglet dédié ; utilise les filtres si plusieurs extractions ou actions Custom JS sont actives.
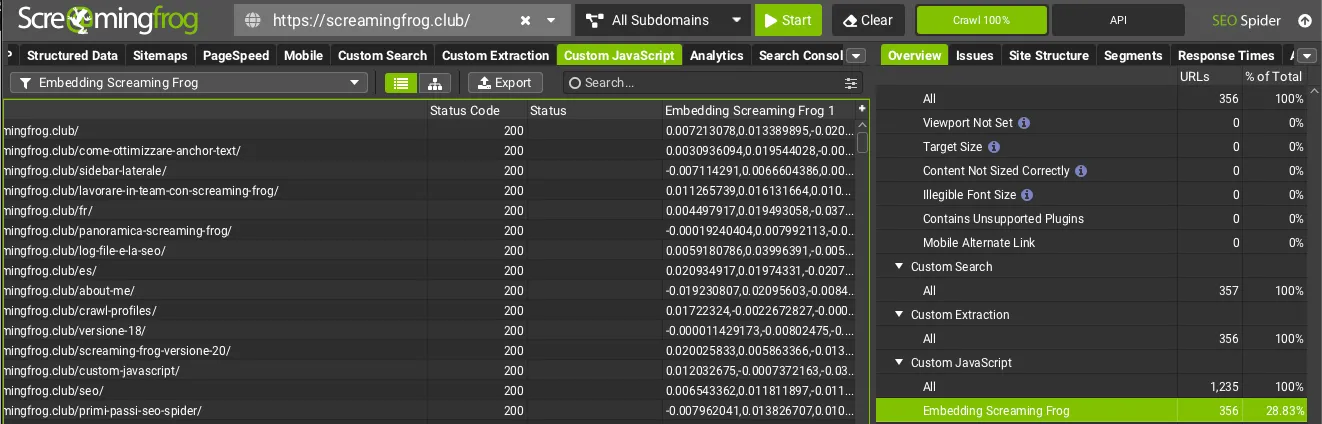
Si tu dois partager le crawl ou la configuration de Screaming Frog, supprime d’abord la clé API pour ne pas la divulguer. D’après les échos de la communauté, les développeurs de Screaming Frog ont déjà été sollicités pour masquer les clés API une fois saisies, afin de protéger cette donnée précieuse et coûteuse.
Mais maintenant qu’on a les embeddings de Screaming Frog, comment exploiter ces nouvelles données ? Comme on l’a vu, les usages sont nombreux ; voyons ensemble comment obtenir, à partir des vecteurs, une analyse très précise des pages associées.
Visualise tes clusters avec Python
Tu as extrait les données. Et maintenant ? Utilise ce script Python (compatible Google Colab) pour transformer les nombres bruts en carte visuelle 2D.
- Entrée : le fichier CSV exporté de Screaming Frog (colonnes : Address, Embeddings).
- Sortie : un nuage de points qui montre comment tes articles se regroupent par sujet.
- À quoi ça sert : repérer d’un coup d’œil les pages « sémantiquement orphelines » (points isolés) qui ont besoin de liens internes.
Étape par étape
Un premier cas d’usage : comprendre les liens entre les pages d’un site, ou entre les fiches produits d’un e-commerce, pour offrir la meilleure expérience au visiteur ou à l’acheteur potentiel.
Voici comment faire :
- Obtiens les embeddings avec Screaming Frog.
- Exporte les données de SEO Spider et formate le fichier en remplaçant « Address » par « URL ».
- Supprime les colonnes « Status Code » et « Status ». Il ne te reste que 2 en-têtes :
- URL.
- Embeddings.
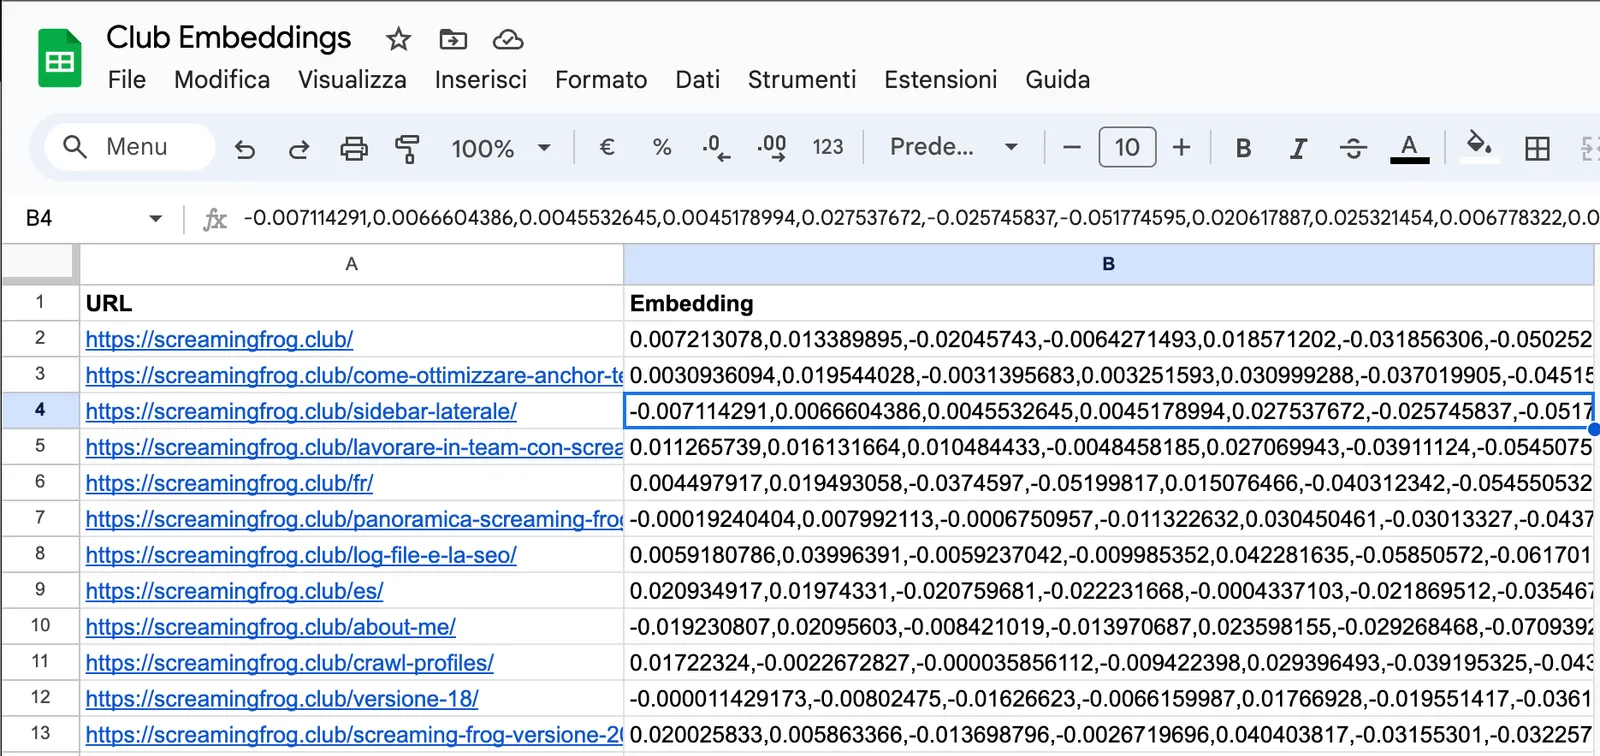
Tu peux alors utiliser un script Python sur Colab pour traiter tes données. Voici le script de Gus Pelogia pour le traitement.
L’outil te demandera de charger ton fichier CSV (celui de Screaming Frog).
Une fois les données traitées, il télécharge automatiquement un autre CSV avec les résultats répartis en deux colonnes (avec Google Sheets, il faudra répartir les données en colonnes) :
- Page source.
- Pages associées.
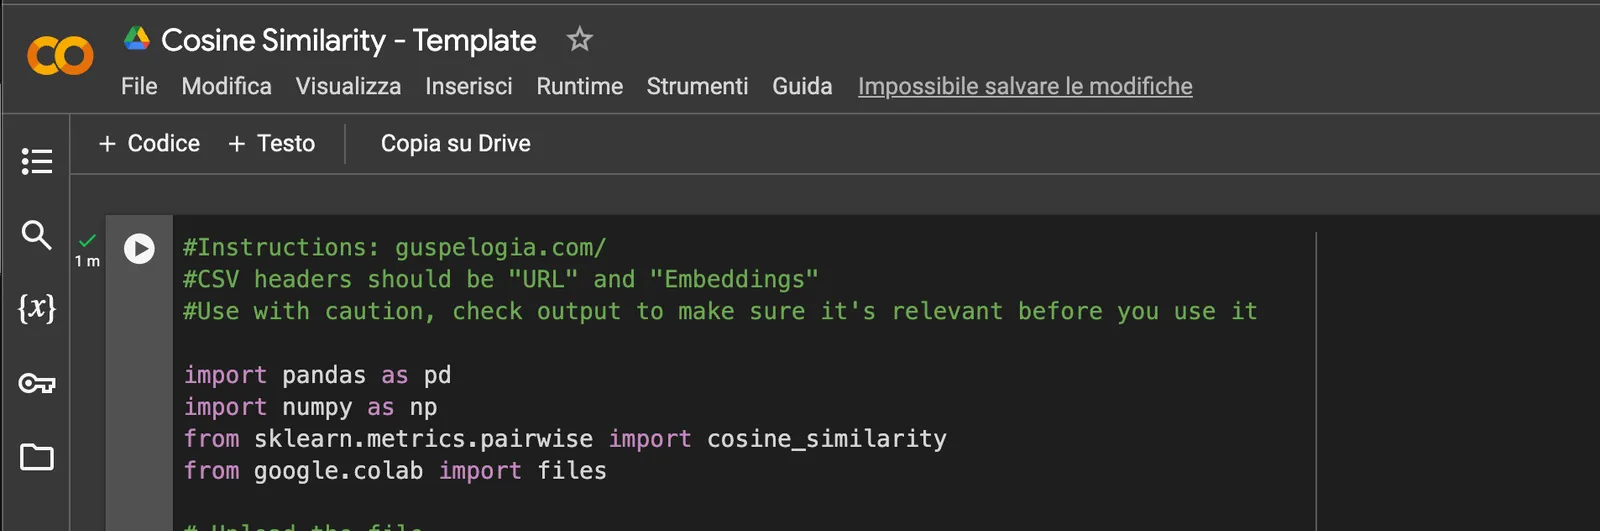
Il suffit de cliquer sur l’icône « Play » et Colab te permettra de charger le fichier de Screaming Frog.
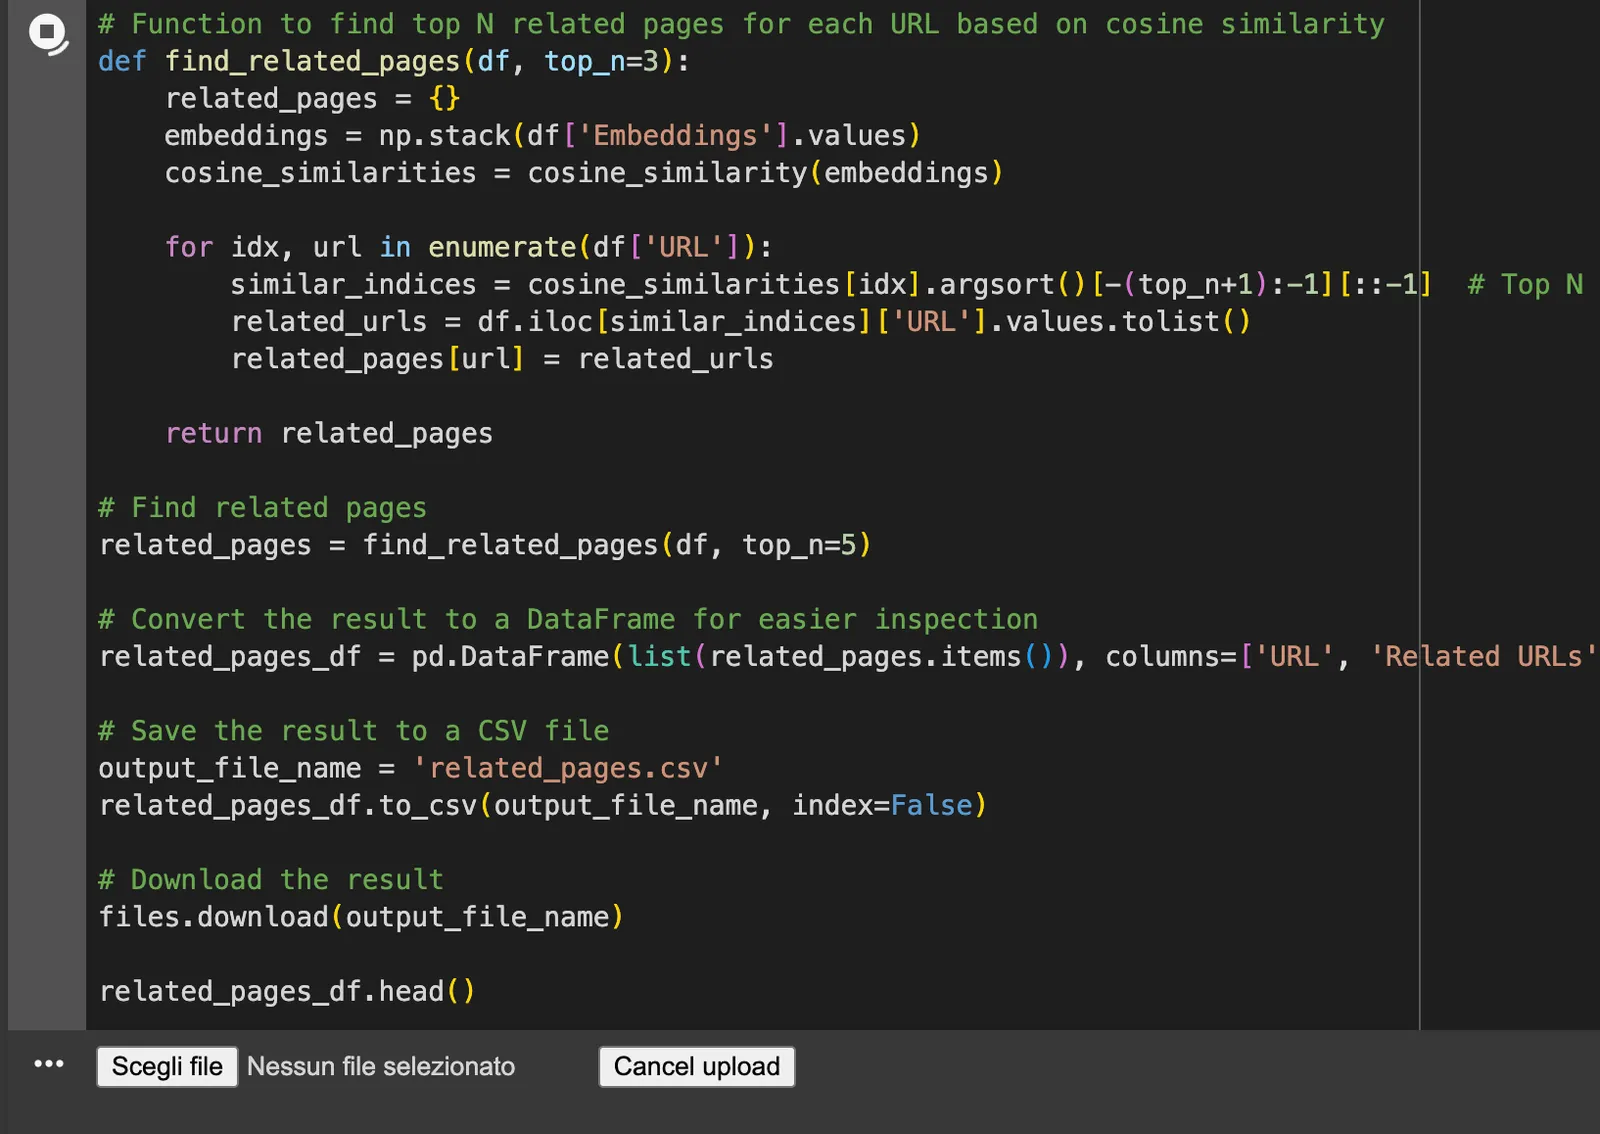
À la fin du traitement, un nouveau fichier nommé « related_pages.csv » est téléchargé automatiquement.
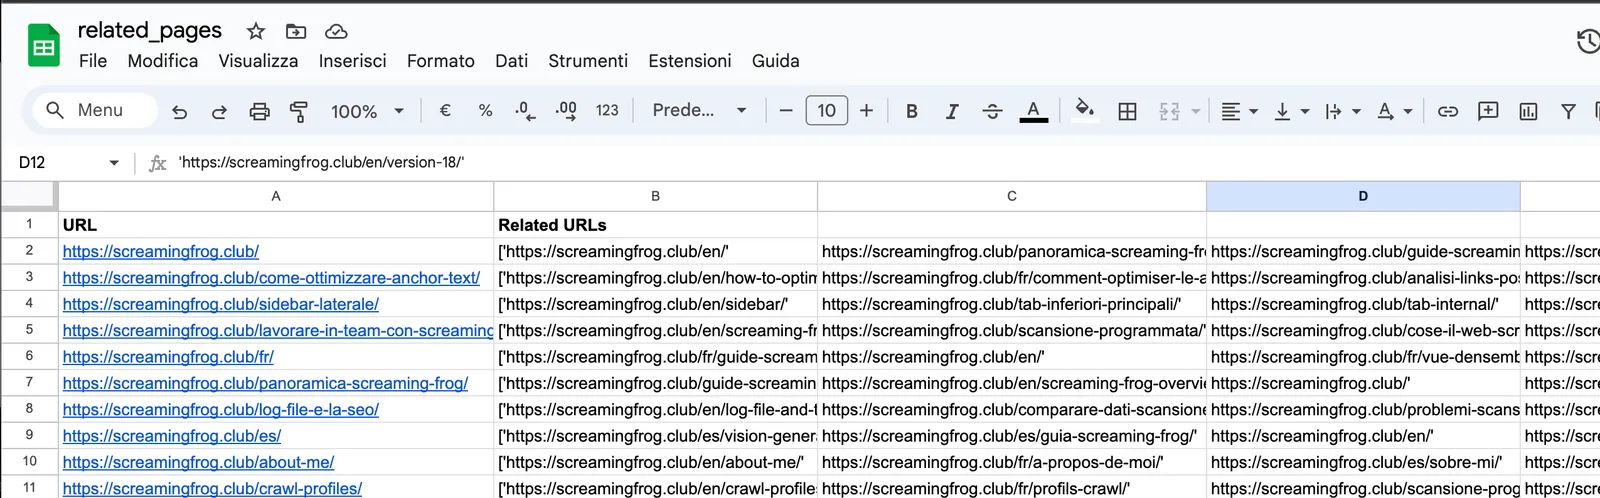
Il ne te reste qu’à vérifier les résultats et à apporter les bonnes modifications au site pour une « corrélation » sémantique optimale des contenus. Appliqué aux produits d’un e-commerce, c’est une excellente stratégie pour améliorer le ROI et le panier moyen.
Clustering
Pour le clustering avec les embeddings, tu peux utiliser différents algorithmes comme K-means ou DBSCAN, qui s’appuient sur différentes métriques de similarité pour créer des groupes homogènes. Pour mon script, j’ai utilisé « pandas » pour manipuler les données, « sklearn » pour le clustering et « matplotlib + seaborn » pour produire une image et un fichier CSV. Le fichier de données était formaté comme le précédent, avec deux colonnes : « URL » et « Embeddings ».
# Import the libraries you need
import pandas as pd
import numpy as np
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
import seaborn as sns
from google.colab import files

# Upload the file
uploaded = files.upload()

# Read the file into a DataFrame
df = pd.read_csv(next(iter(uploaded)))

# Embeddings are stored as list strings: convert them to numpy arrays
df['Embeddings'] = df['Embeddings'].apply(eval).apply(np.array)

# Choose the number of clusters
n_clusters = 5  # Change this value as you like

# Extract the embeddings
embeddings = np.vstack(df['Embeddings'].values)

# Run the clustering
kmeans = KMeans(n_clusters=n_clusters, random_state=0).fit(embeddings)
df['Cluster'] = kmeans.labels_

# Reduce dimensionality for the visualisation
pca = PCA(n_components=2)
embeddings_2d = pca.fit_transform(embeddings)

# Add the PCA components to the DataFrame
df['PCA1'] = embeddings_2d[:, 0]
df['PCA2'] = embeddings_2d[:, 1]

# Save the CSV file with the clusters
output_csv = 'clustered_data.csv'
df.to_csv(output_csv, index=False)
files.download(output_csv)

# Create an image with the clusters
plt.figure(figsize=(10, 7))
sns.scatterplot(x='PCA1', y='PCA2', hue='Cluster', data=df, palette='viridis', s=100)
plt.title('Clusters of Embeddings')
plt.xlabel('PCA1')
plt.ylabel('PCA2')
plt.legend()
plt.grid(True)

# Save the image
output_image = 'clusters_plot.png'
plt.savefig(output_image)
files.download(output_image)

# Show the image
plt.show()Des questions sur Embeddings SEO avec Screaming Frog?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
