

Analyse des données structurées.
Analyse des données structurées et suivi des opportunités et avertissements avec SEO Spider.
Sommaire du guide 4 sections
●Brief01.Les données structurées02.Filtres des données structurées03.Vidéo sur les données structuréesComment vérifier et valider les données structurées d’un site selon Schema.org et les exigences de Google. Active l’extraction JSON-LD, Microdata et RDFa, lis les filtres de l’onglet Structured Data et exporte erreurs et avertissements.
Les données structurées
Comme évoqué plus haut, les données structurées donnent aux moteurs des indices explicites sur le sens des pages et de leurs composants, et peuvent activer des fonctionnalités spéciales dans les résultats de Google.
Mettre en place les différents types de données structurées peut t’aider à obtenir des extraits enrichis plus visibles et plus détaillés, qui apportent plus de trafic et donc plus de conversions.
Dans ce guide, tu utilises Screaming Frog pour vérifier et valider les données structurées selon les spécifications de Schema.org et les exigences de Google.
-
- Active les options de données structurées dans « Configuration > Spider > Extraction ».
Commence par activer « JSON-LD », « Microdata », « RDFa », « Schema.org Validation » et « Google Rich Result Feature Validation » dans la configuration du Spider.
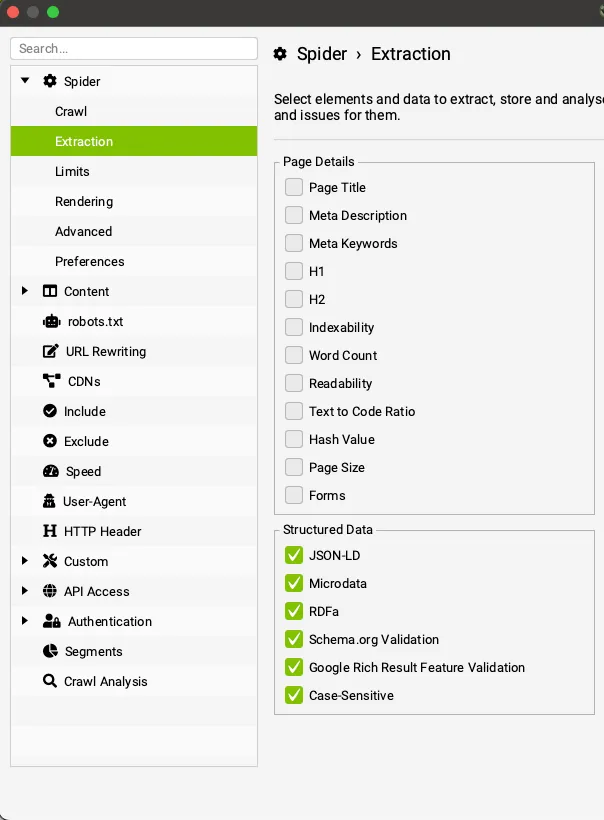
L’option « Case-Sensitive » reste facultative pour Google, mais nécessaire pour Schema.org.
-
- Lance le crawl
Une fois les options activées, il suffit de lancer le crawl : SEO Spider commence à extraire les données des pages et à les valider.
-
- Analyse les données dans l’onglet « Structured Data »
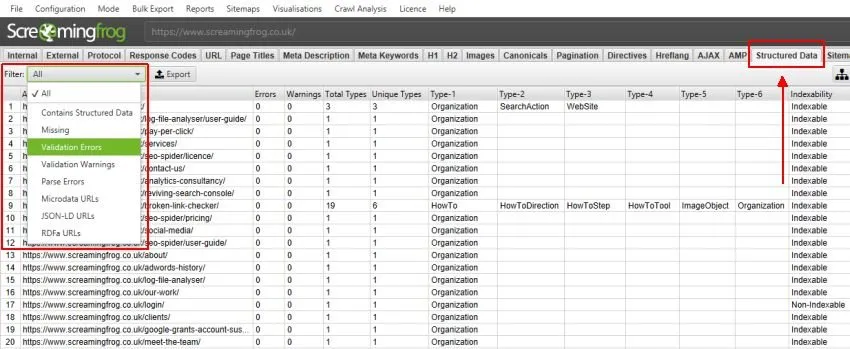
L’onglet « Structured Data » propose des filtres qui t’aident à voir si l’implémentation présente des problèmes de validation. Les colonnes « Total Types » et « Unique Types » comptent le nombre de types d’éléments trouvés pour chaque URL.
En plus de la fenêtre supérieure, la barre latérale résume les données de chaque onglet et filtre, pour savoir où cliquer sans ouvrir chaque filtre.
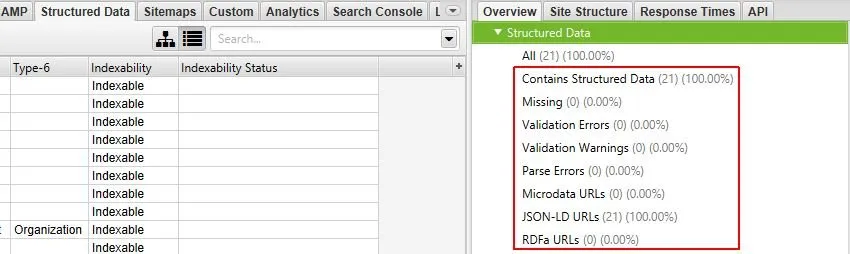
Filtres des données structurées
Voici les filtres et leur rôle :
-
Contains Structured Data : toutes les URL qui contiennent des données structurées.
-
Missing Structured Data : les URL sans données structurées.
-
Validation Errors : toutes les URL avec des erreurs de validation selon le vocabulaire Schema.org, les rich results de Google ou les deux, selon ta configuration. SEO Spider classe toujours les problèmes Schema.org comme des erreurs plutôt que des avertissements. La validation des rich results de Google signale les propriétés obligatoires manquantes ou mal implémentées.
-
Validation Warnings : toutes les URL avec des avertissements de validation par rapport aux Rich Results de Google. SEO Spider ne remplit ce filtre qu’avec les problèmes des propriétés recommandées (facultatives).
-
Parse Errors : toutes les URL dont les données structurées n’ont pas pu être analysées correctement, souvent à cause d’un balisage incorrect. Si tu utilises le format préféré de Google, JSON-LD, le JSON-LD Playground est un excellent outil de débogage.
-
Microdata URLs : les URL qui contiennent des données structurées au format Microdata.
-
Microdata URLs | JSON-LD URLs | RDFa URLs : les URL qui contiennent des données structurées au format JSON-LD, RDFa ou Microdata.
-
- Consulte l’onglet « Structured Data Details »
Une fois les données collectées, tu vois tous les détails dans la fenêtre inférieure de SEO Spider : à gauche, les valeurs des propriétés avec des icônes signalant erreurs ou avertissements ; à droite, le détail de chaque problème de validation, sa gravité et les liens Schema.org vers les spécifications pour le corriger.
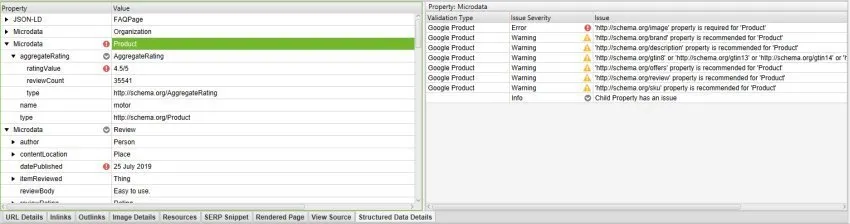
Exemple d’erreur de validation Google Product
Dans l’exemple ci-dessous, lv.com présente des erreurs et avertissements de validation sur les exigences des données structurées « Google Product ». À droite, on voit 1 erreur parmi les propriétés obligatoires et plusieurs avertissements parmi les recommandées.
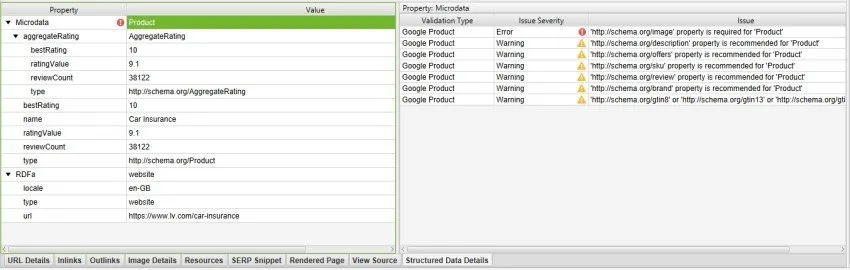
Les propriétés recommandées, signalées comme avertissements, peuvent être ajoutées pour enrichir les informations sur le contenu (et offrir une meilleure expérience) ou simplement ignorées.
Dans l’exemple suivant, HSBC a une erreur dans ses données structurées de fil d’Ariane.
Le problème indique que la propriété « http://schema.org/item » est obligatoire pour « ListItem ».
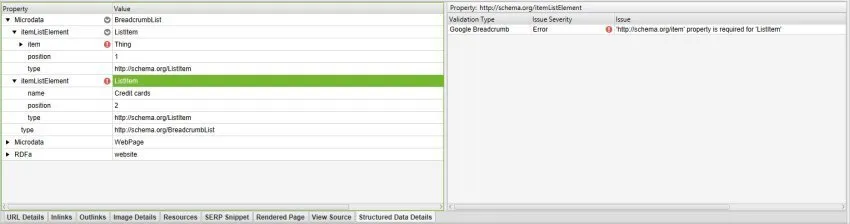
Les consignes de Google sur le fil d’Ariane indiquent que les propriétés doivent inclure item (l’URL de la page), name (le titre de l’élément) et position (dans le fil). HSBC n’a simplement pas la propriété item et l’URL associée.
Ce ne sont que quelques exemples de lecture des données collectées par SEO Spider. Je te conseille de relire régulièrement la documentation officielle, en constante évolution.
-
- Exporter les erreurs et avertissements de validation
Screaming Frog propose deux rapports dédiés aux données structurées.
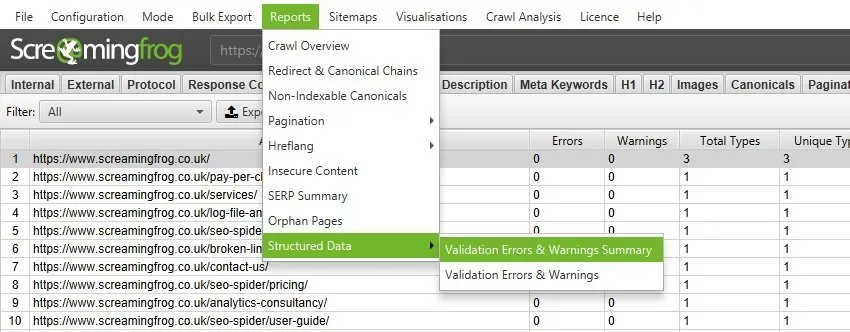
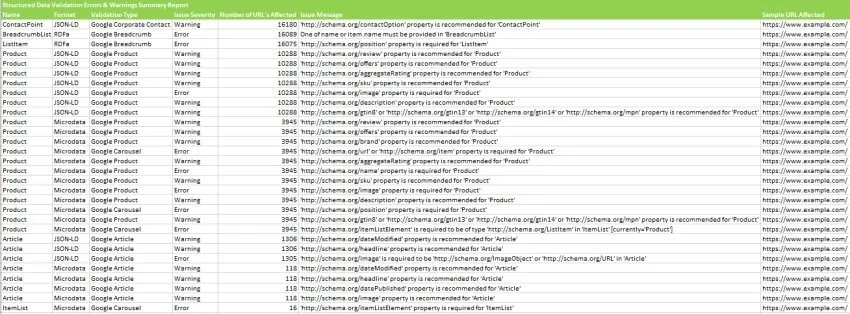
Le rapport « Validation Errors & Warnings Summary » est particulièrement utile car il regroupe les problèmes par modèle (au lieu de lister chaque occurrence) et indique le nombre d’URL concernées par modèle avec une URL d’exemple (comme la Search Console pour les Web Vitals). En voici un exemple.
Le rapport « Validation Errors & Warnings » est un véritable export en masse de chaque erreur et avertissement avec l’URL concernée. Très complet, mais difficile à lire sur les gros sites.
Onglets associés : Données structurées | Rapports
Vidéo sur les données structurées
Des questions sur Analyse des données structurées?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
