

Embeddings SEO con Screaming Frog.
Guía práctica de análisis semántico
Cómo usar los embeddings con Screaming Frog y la API de OpenAI para trabajar sobre el significado de las páginas, no sobre las palabras clave. Calculas la similitud semántica, encuentras duplicados ocultos, guías el enlazado interno y creas clusters con un script de Python listo para usar.
¿Qué son los embeddings?
Los embeddings traducen las palabras a números (vectores). Imagina convertir cada página de tu sitio en una coordenada GPS multidimensional:
- Vectorización: la IA convierte el texto en una lista de números (p. ej. [0.1, -0.5, 0.8]).
- Proximidad: dos páginas que hablan del mismo tema tendrán vectores cercanos en el espacio matemático, aunque usen palabras distintas (p. ej. «coche» y «automóvil»).
- Aplicación SEO: esto nos ayuda a entender cómo agrupa Google nuestros contenidos y a descubrir «huecos» semánticos en nuestra estructura.
Los embeddings se están convirtiendo rápidamente en un elemento fundamental de la inteligencia artificial (IA) y del machine learning (ML). Estas potentes herramientas permiten representar datos complejos en formatos más manejables, mejorando notablemente la eficacia de los algoritmos de aprendizaje automático.
Los embeddings son representaciones vectoriales de objetos complejos como palabras, imágenes o usuarios. Convierten datos no numéricos en una forma numérica que los algoritmos de ML (Machine Learning) pueden procesar fácilmente.
Transformar estos datos en representaciones vectoriales te permitirá descubrir de forma eficaz relaciones y patrones muy útiles para gestionar estratégicamente análisis complejos.
La dimensión de un vector depende del modelo de embedding utilizado y determina su capacidad de representar el significado de una palabra o documento con una serie de números que los bots puedan aprovechar.
La dimensión del vector representa la profundidad de análisis codificada en el espacio de embedding.
Pero ¿qué datos se pueden sacar de estos vectores? En el embedding de palabras, por ejemplo, se pueden obtener aspectos semánticos, sintácticos y contextuales; cuanto mayor sea el vector, más detallada será la información. Así se entiende cómo el análisis SEO pasa del estudio aséptico de las «palabras clave» al descubrimiento de la «intención de búsqueda», no según nuestra valoración personal sino con análisis profundos y cada vez más parecidos a los de los rastreadores de los buscadores.
Ventajas de los embeddings
- Reducción de la dimensionalidad: los embeddings reducen la complejidad de los datos originales manteniendo la información relevante. Esto hace más eficientes la manipulación y el análisis y, en SEO, son auténticas minas de oro para análisis cada vez más cercanos al comportamiento del rastreador del buscador.
- Mejor rendimiento de los algoritmos: al capturar relaciones semánticas, los embeddings mejoran la exactitud y la precisión de los algoritmos de ML, algo especialmente visible en el procesamiento del lenguaje natural (NLP) y en el reconocimiento de imágenes.
- Flexibilidad y aplicabilidad: los embeddings se aplican a muchos tipos de datos y sectores, de las recomendaciones de productos al análisis de sentimiento. Por ejemplo, al asignar series de números a las palabras según su similitud semántica, el «word embedding» permite a las redes neuronales entender el contexto de forma mucho más rica y procesarlo.
Aplicaciones de los embeddings en el SEO
- Procesamiento del lenguaje natural (NLP): en NLP, los embeddings de palabras como Word2Vec y GloVe ayudan a los modelos a entender mejor el contexto y el significado de las palabras. Han revolucionado la traducción automática, el análisis de sentimiento y los chatbots inteligentes. Los word embeddings son útiles para el análisis y el targeting de palabras clave, porque muestran el significado de las palabras y sus relaciones y revelan patrones y tendencias en los textos, identificando las consultas más importantes de un texto. Esto es útil para el SEO, porque permite identificar las palabras clave que más usan los usuarios al buscar un producto o servicio. Al entender las relaciones entre palabras, también ayudan a detectar sinónimos y términos relacionados útiles para el targeting y posibles términos de búsqueda que los usuarios podrían usar.
- Recomendaciones de productos: una aplicación muy útil es el e-commerce, donde el análisis de los embeddings permite presentar de forma precisa y estratégica los productos relacionados según sus similitudes y las preferencias de los usuarios. Esto mejora la experiencia del cliente y las ventas, y va más allá de proponer productos «complementarios» o de la misma categoría, como hacen automáticamente los CMS más populares. Con los embeddings se pueden diseñar estrategias cada vez más precisas y eficaces, buscando el equilibrio entre oferta y demanda.
- Reconocimiento de imágenes: los embeddings también se usan para identificar y clasificar objetos en las imágenes. Técnicas como las redes neuronales convolucionales (CNN) generan embeddings que representan las características visuales y mejoran el reconocimiento.
- SEO y marketing digital: los embeddings también sirven para mejorar las estrategias de SEO y marketing digital, permitiendo entender mejor el comportamiento de los usuarios y crear contenidos más eficaces.
Veamos más en detalle las aplicaciones SEO de los embeddings:
- Clustering: en SEO, los «clusters» son grupos de contenidos relacionados en torno a un tema principal. Cada cluster incluye una «pillar page» central que cubre el tema a fondo y páginas de apoyo más concretas que profundizan en subtemas. Este enfoque organiza mejor el contenido, mejora la navegación y la experiencia y favorece una mejor indexación. Los clusters también aumentan la autoridad del sitio en temas concretos y mejoran el posicionamiento orgánico.
- Clasificación: asignación de categorías a palabras o documentos a partir de modelos entrenados.
- Recomendaciones: sugerencia de artículos relevantes a los usuarios.
- Medición de similitud y diversidad: valoración de las semejanzas y diferencias entre palabras y documentos. Te ayuda a evitar contenidos duplicados y a gestionar posibles «canibalizaciones» de consultas, con análisis muy finos que captan hasta los mínimos detalles de las páginas rastreadas.
- Detección de anomalías: identificación de elementos que se alejan mucho del resto de los datos, para optimizar la arquitectura interna o modificar los contenidos.
- Obtención de información específica: extracción de información relevante de grandes conjuntos de datos.
- Traducción: los word embeddings ayudan a la traducción ofreciendo una representación común de las palabras en distintos idiomas. Para traducir una palabra, un modelo tiene que entender su significado en ambos idiomas; los word embeddings lo permiten al representar las palabras de forma independiente del idioma, de modo que el embedding de una palabra en un idioma se puede comparar con el de la misma palabra en otro. Así, este enfoque va más allá de la traducción léxica y sintáctica clásica y produce contenidos contextualizados en cada versión de idioma, lo que ayuda a posicionarse mejor en las SERP extranjeras.
- Análisis de sentimiento: para crear un léxico de sentimientos o emociones con word embeddings, se puede empezar seleccionando palabras o frases asociadas a ciertos sentimientos: anotadas por personas o muy usadas en redes sociales para expresar emociones. Después se crean vectores para cada una, con un modelo de word embedding preentrenado o desde cero con algoritmos de aprendizaje y un gran corpus de texto. Con esos vectores se puede identificar el sentimiento asociado a otras palabras o frases: si una palabra se parece a un vector del léxico asociado a un sentimiento, se puede deducir que también lo está (fuente: https://marketbrew.ai/word-embeddings-a-comprehensive-guide).
- Generación de contenidos: la información de los embeddings puede usarse para generar frases nuevas relacionadas con el texto original. Por ejemplo, en un texto sobre outdoor, los word embeddings identifican palabras y frases relevantes como «camping» o «vida al aire libre» para hacer la página más pertinente a la intención de búsqueda «outdoor». Además, permiten calcular la similitud semántica de una consulta con las demás de un vocabulario (cosine similarity), para un contenido más fluido sin textos escritos solo para el SEO. Una similitud del coseno alta indica vectores parecidos; una baja indica que son distintos y que el rastreador no los considerará sinónimos semánticos.
- Predicción contextual de palabras: los embeddings mejoran la precisión del autocompletado o del texto predictivo. Capturan el contexto de las palabras y pueden predecir la siguiente a partir de las anteriores, lo que permite autocompletar la búsqueda interna. Junto con el siempre útil análisis en Google Analytics 4 de las consultas internas, esto mejora la UX, por ejemplo de tu e-commerce, y ofrece la mejor propuesta al comprador potencial.
En guías anteriores destacamos la importancia de los análisis N-gram, pero con los embeddings darás un salto de nivel.
En términos de eficacia SEO, los word embeddings tienen varias ventajas. En primer lugar, permiten entender de forma menos aproximada el significado y el contexto de las palabras en un documento, útil para valorar la relevancia y la calidad de una página, frente a un análisis basado en la frecuencia de las entidades, válido para la arquitectura interna pero menos preciso que el escenario que describimos. Además, con los N-grams no se pueden identificar términos relacionados, así que su capacidad de análisis es claramente menor.
Screaming Frog, embeddings y la API de ChatGPT
Para activar el análisis semántico en el rastreador, sigue estos pasos:
- Prepara la clave API: ve a la plataforma de OpenAI, genera una nueva clave secreta y cópiala.
- Configura el Custom JavaScript:
- Abre Screaming Frog y ve a 1Configuration›2Custom›3Custom JavaScript.
- Haz clic en «Add from Library» (abajo a la derecha).
- Selecciona el snippet oficial: (ChatGPT) Extract embeddings from page content.
- Introduce la clave:
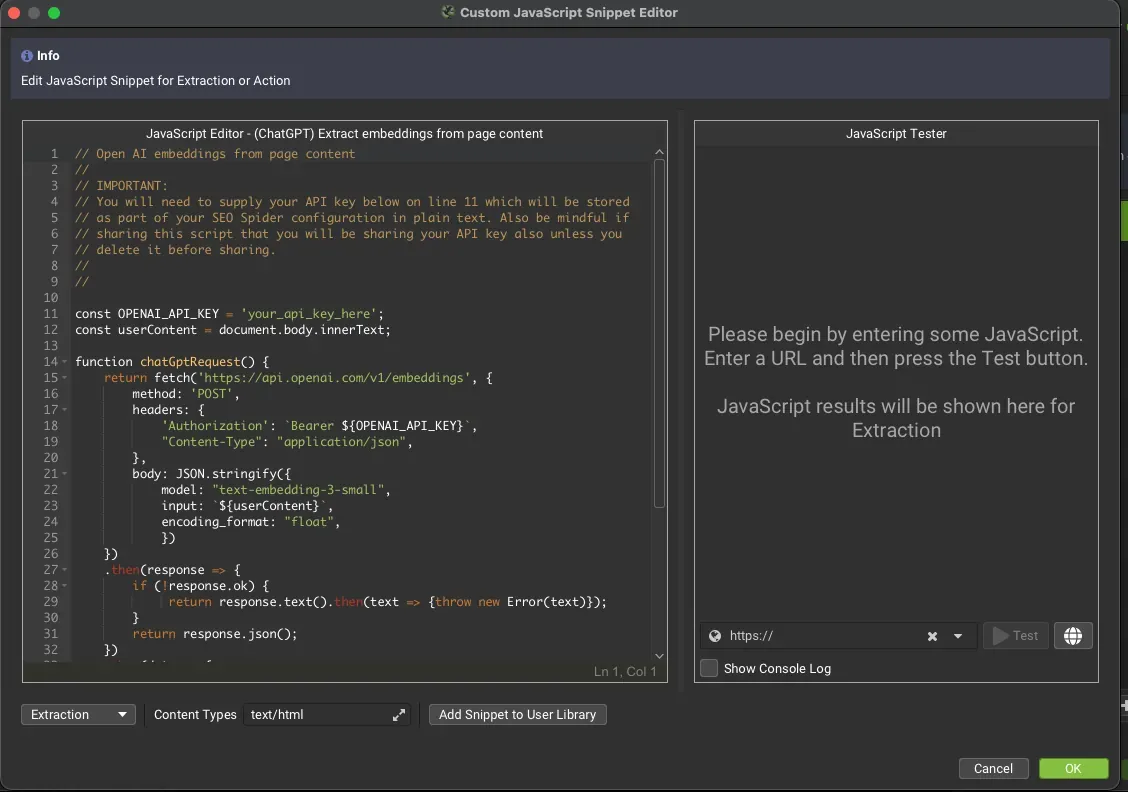
- Haz clic en el icono «JS» del snippet que acabas de añadir.
- Pega tu clave API en la línea 11 del snippet, en lugar de
your_api_key_hereenconst OPENAI_API_KEY.
- Lanza el rastreo: el software consultará a OpenAI por cada URL y guardará el vector en la pestaña Custom JavaScript.
La versión 20 de Screaming Frog SEO Spider introdujo los embeddings generados con un modelo de OpenAI, mediante la API, directamente con una función interna de la herramienta.
Para ello, Screaming Frog permite ejecutar JavaScript personalizado, disponible en 1Configuration›2Custom›3Custom JavaScript, donde eliges el script correspondiente e introduces tu clave API de OpenAI para generar embeddings durante el rastreo.
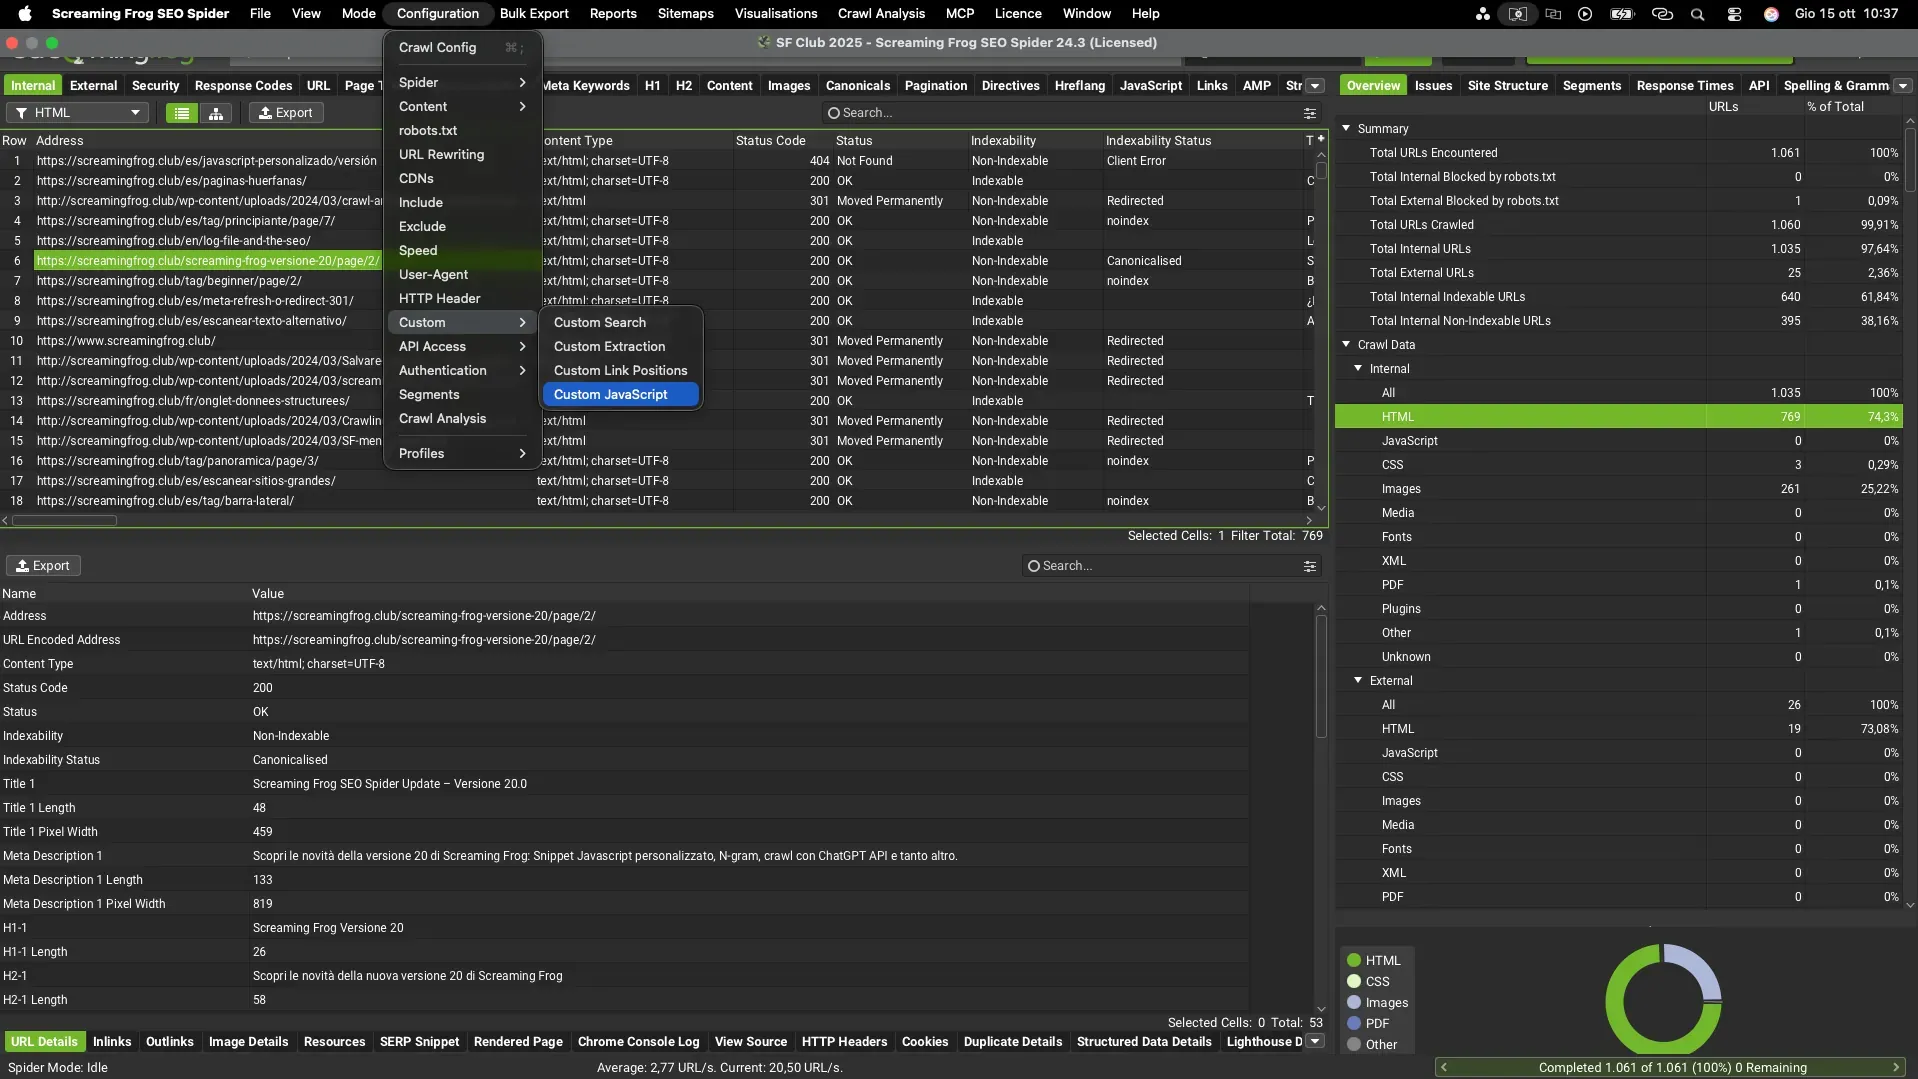
En Custom JavaScript basta con hacer clic en «+Add from Library» y elegir el snippet de Screaming Frog «(ChatGPT) Extract embeddings from page content».
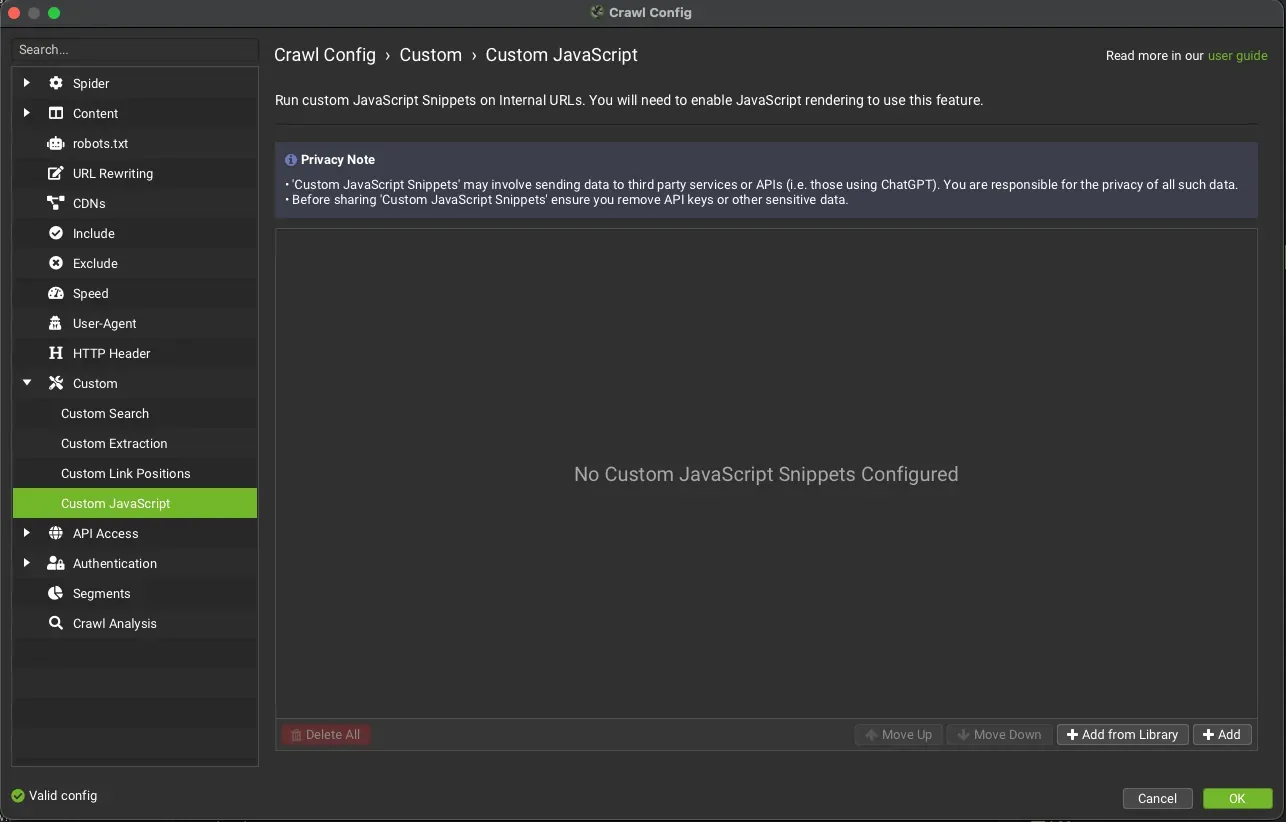
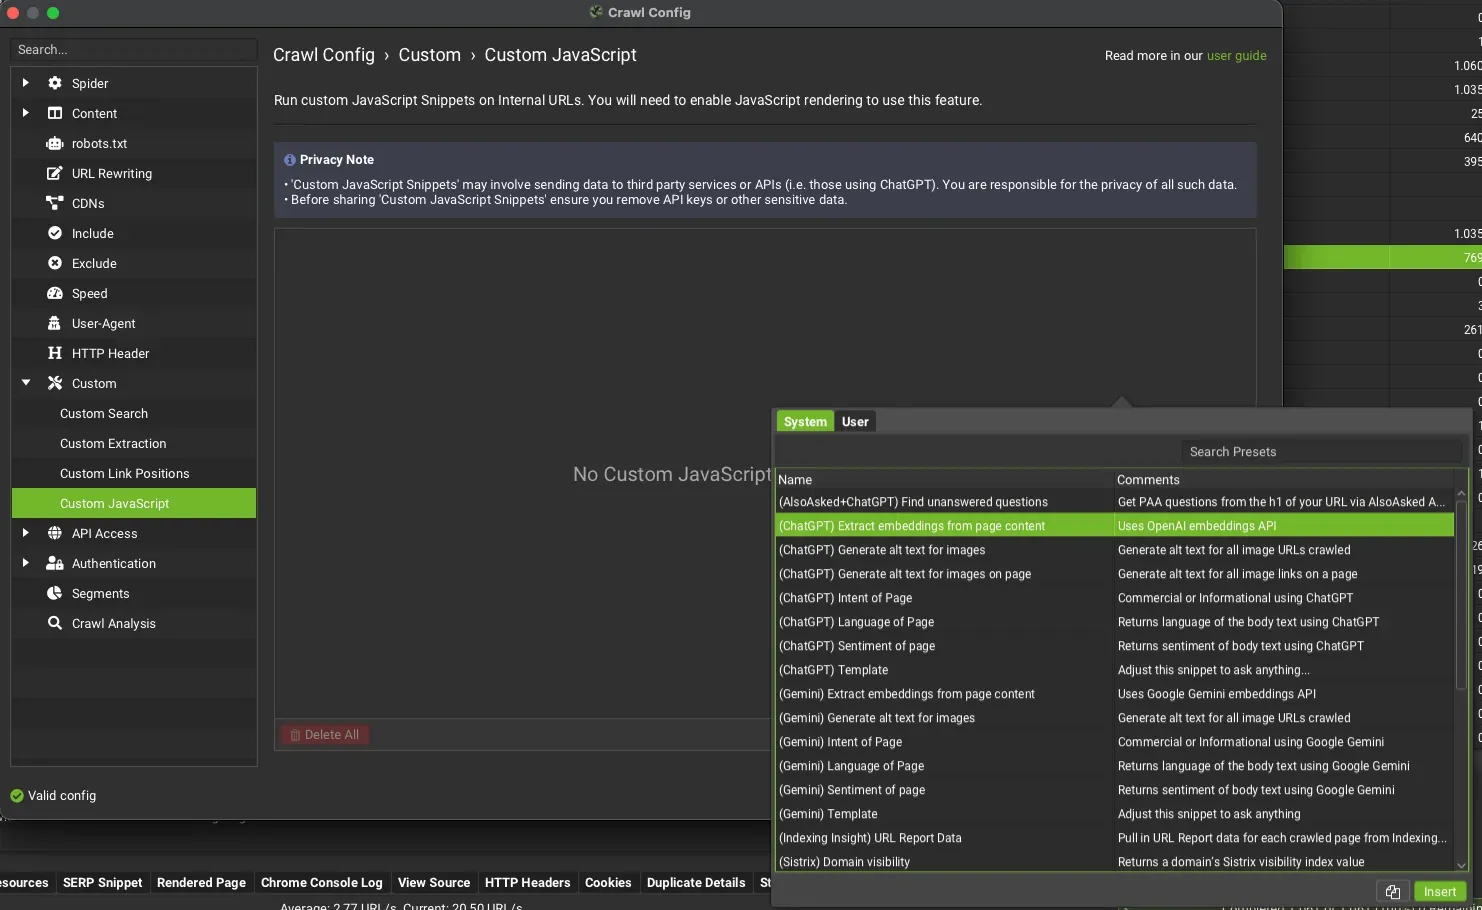
Haciendo clic en el icono «JS» podrás modificar el script e introducir la clave API generada en OpenAI.

Esta es la pantalla donde introducir tu clave API. Una vez pegada en el campo, basta con lanzar el rastreo con Screaming Frog para obtener los embeddings. Como la API tiene coste, te aconsejo usar el «JavaScript Tester» con una URL para ver una vista previa del resultado de un rastreo completo.
Los resultados del «Custom JavaScript» aparecen en su pestaña; usa los filtros si hay varias extracciones o acciones Custom JS activas.
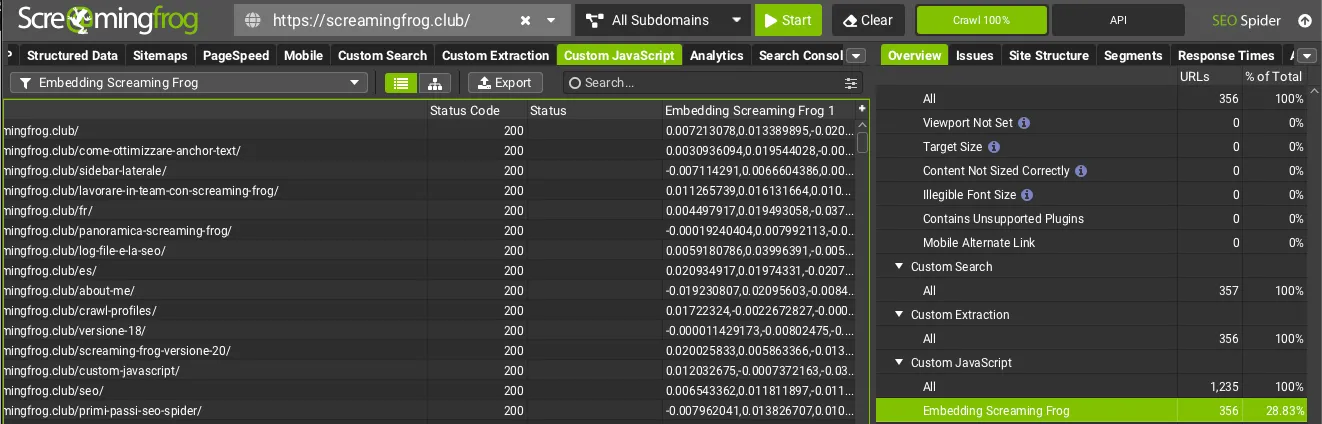
Si necesitas compartir el rastreo o la configuración de Screaming Frog, borra antes la clave API para no facilitarla. Según comentan en la comunidad, ya se ha pedido a los desarrolladores de Screaming Frog que oculten las claves API una vez introducidas, para proteger este dato valioso y costoso.
Pero ahora que tenemos los embeddings de Screaming Frog, ¿cómo trabajamos con estos nuevos datos? Como hemos visto, los usos son muchos; veamos juntos el proceso para obtener, a partir de los vectores, un análisis muy preciso de las páginas relacionadas.
Visualiza tus clusters con Python
Ya has extraído los datos. ¿Y ahora? Usa este script de Python (compatible con Google Colab) para convertir los números en bruto en un mapa visual en 2D.
- Entrada: el archivo CSV exportado de Screaming Frog (columnas: Address, Embeddings).
- Salida: un gráfico de dispersión que muestra cómo se agrupan tus artículos por tema.
- Para qué sirve: detectar de un vistazo las páginas «huérfanas semánticamente» (puntos aislados) que necesitan enlaces internos.
Paso a paso
Un primer caso de uso es entender las conexiones entre las páginas de un sitio, o entre las fichas de producto de un e-commerce, para ofrecer la mejor experiencia al visitante o comprador potencial.
Veamos cómo:
- Obtén los embeddings con Screaming Frog.
- Exporta los datos de SEO Spider y formatea el archivo sustituyendo «Address» por «URL».
- Elimina las columnas «Status Code» y «Status». Te quedarán solo 2 encabezados:
- URL.
- Embeddings.
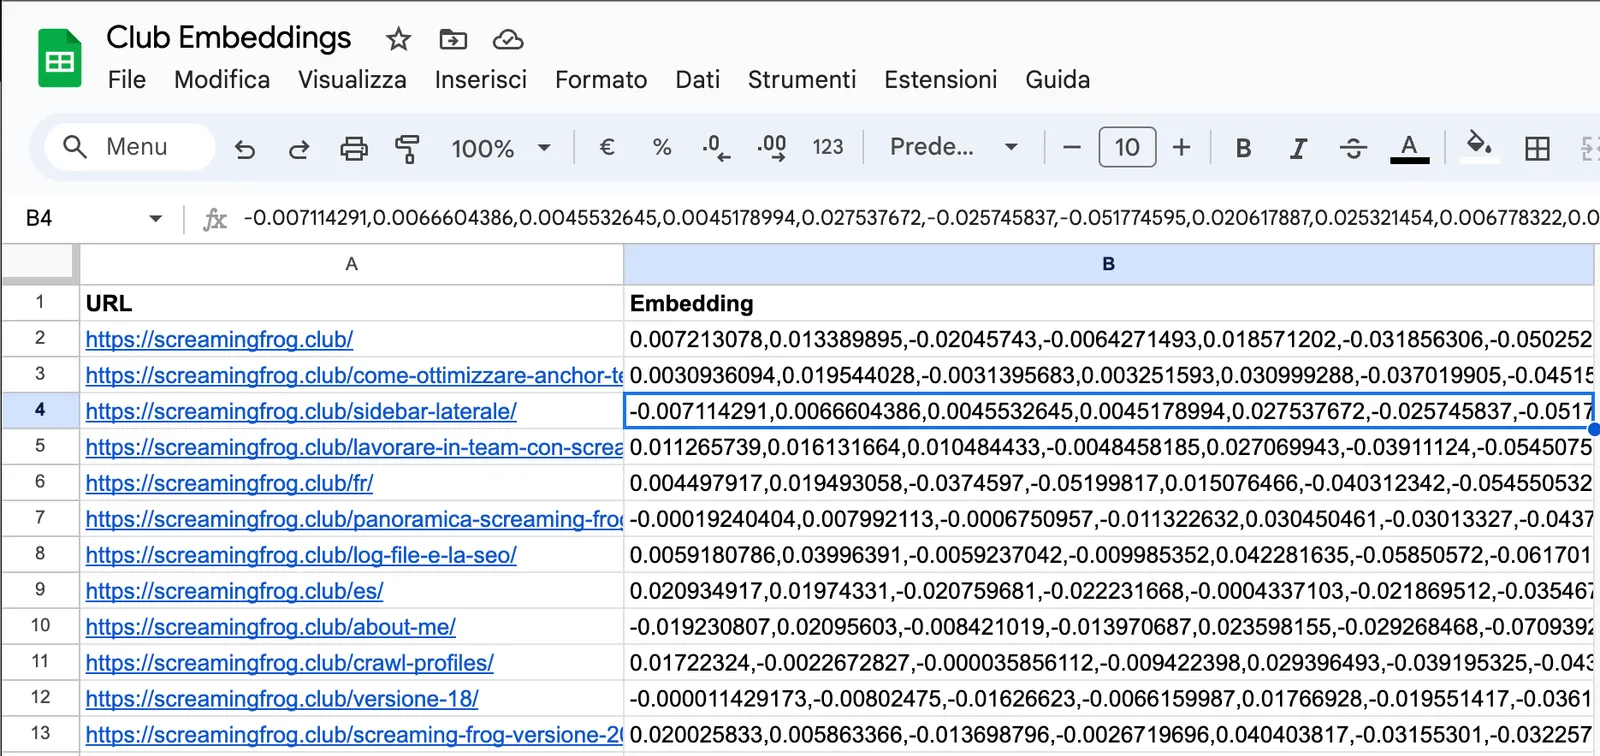
Ahora puedes usar un script de Python en Colab para procesar tus datos. Aquí tienes el script de Gus Pelogia.
La herramienta te pedirá que subas tu archivo CSV (el de Screaming Frog).
Una vez procesados los datos, descargará automáticamente otro CSV con los resultados en dos columnas (si usas Google Sheets tendrás que separar los datos en columnas):
- Página de origen.
- Páginas relacionadas.
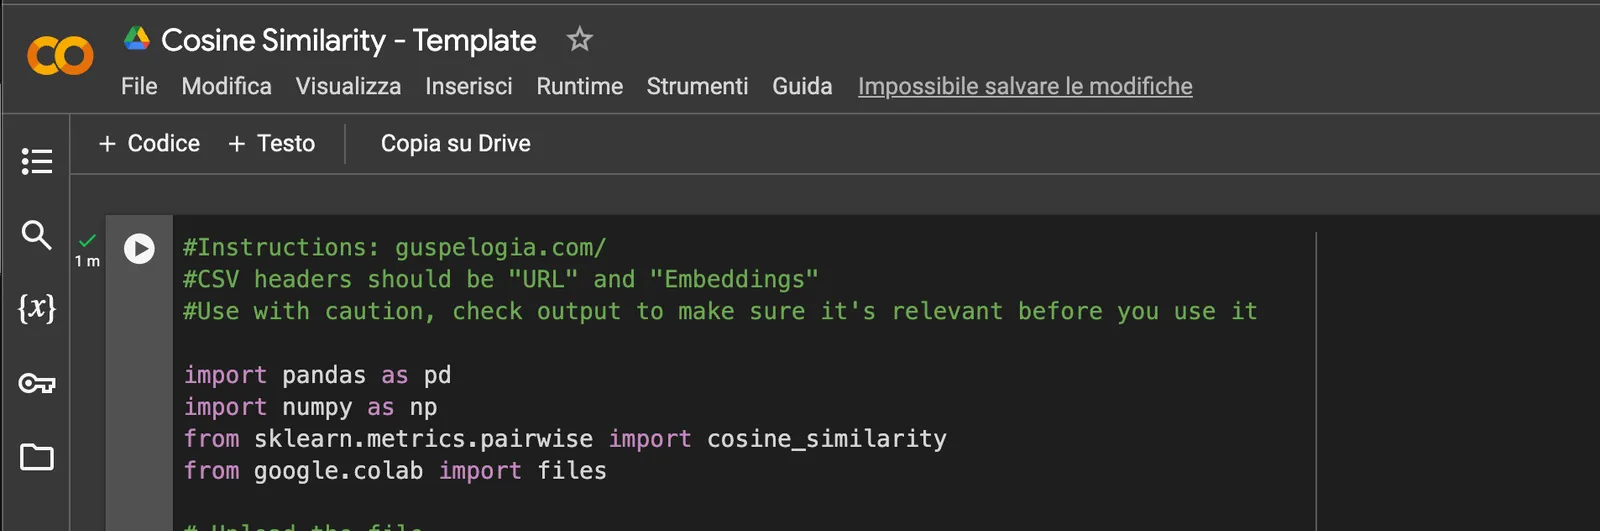
Basta con hacer clic en el icono «Play» y Colab te dejará subir el archivo de Screaming Frog.
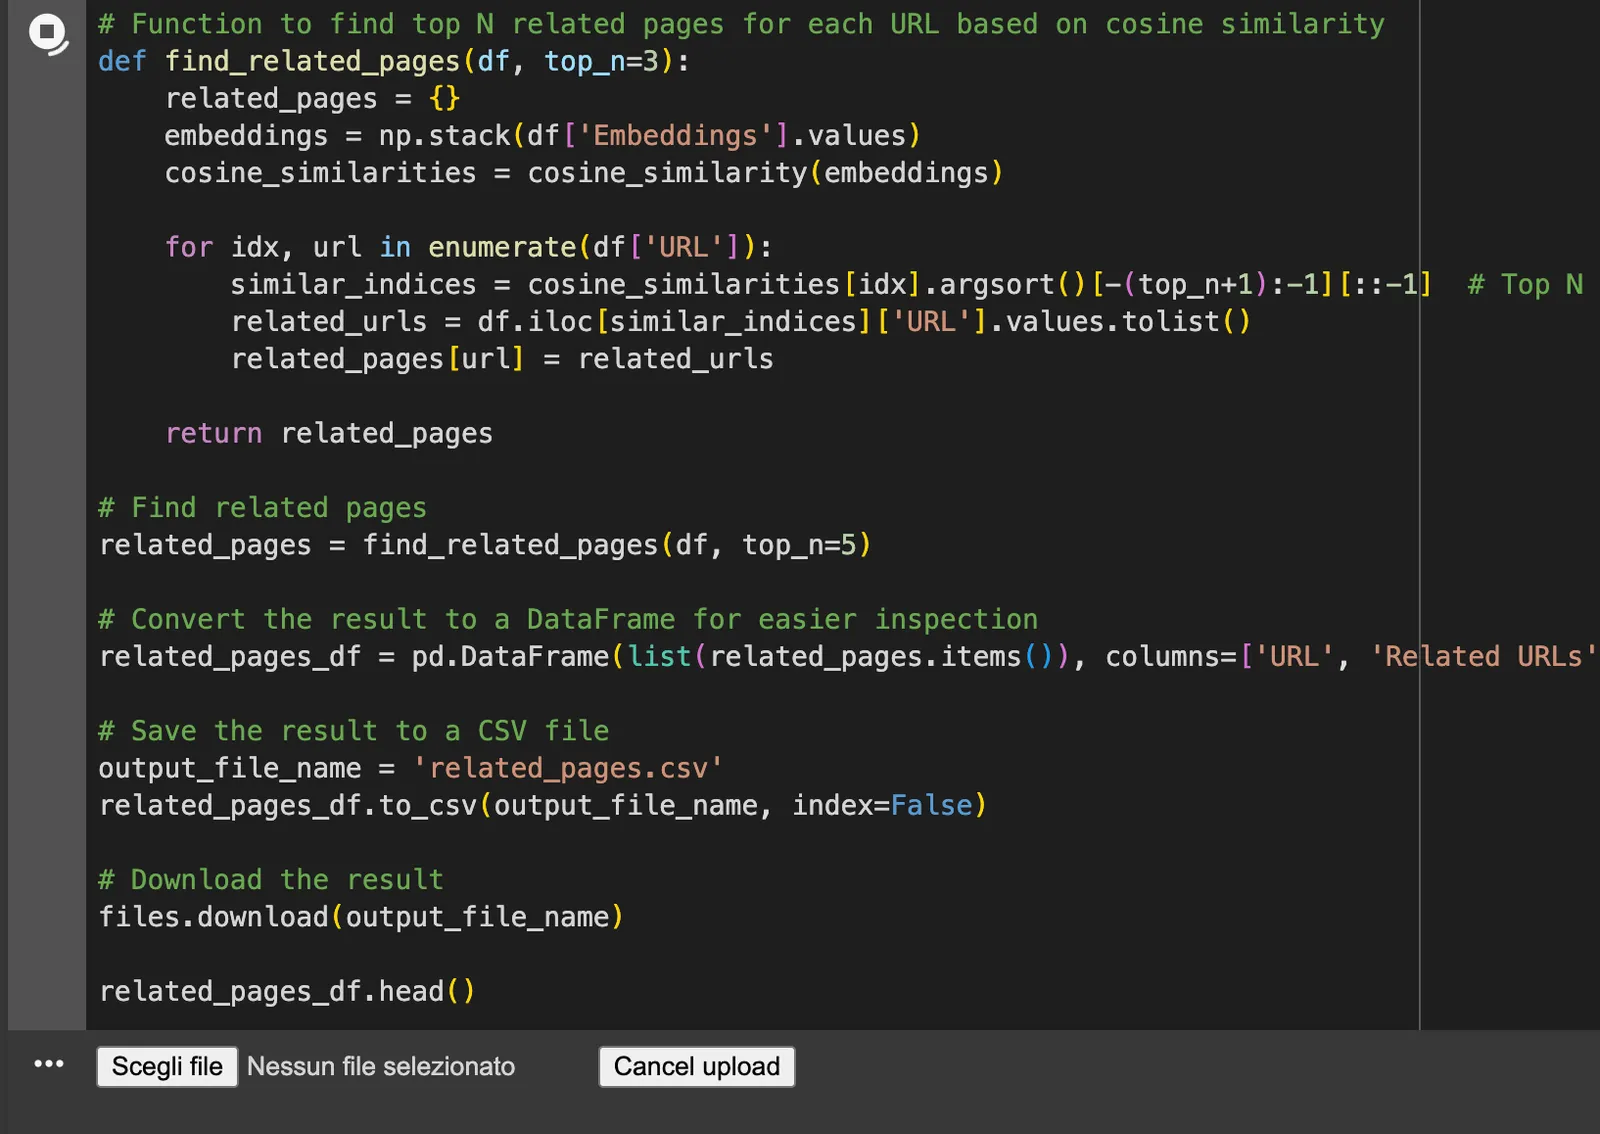
Al terminar el proceso, se descargará automáticamente un nuevo archivo llamado «related_pages.csv».
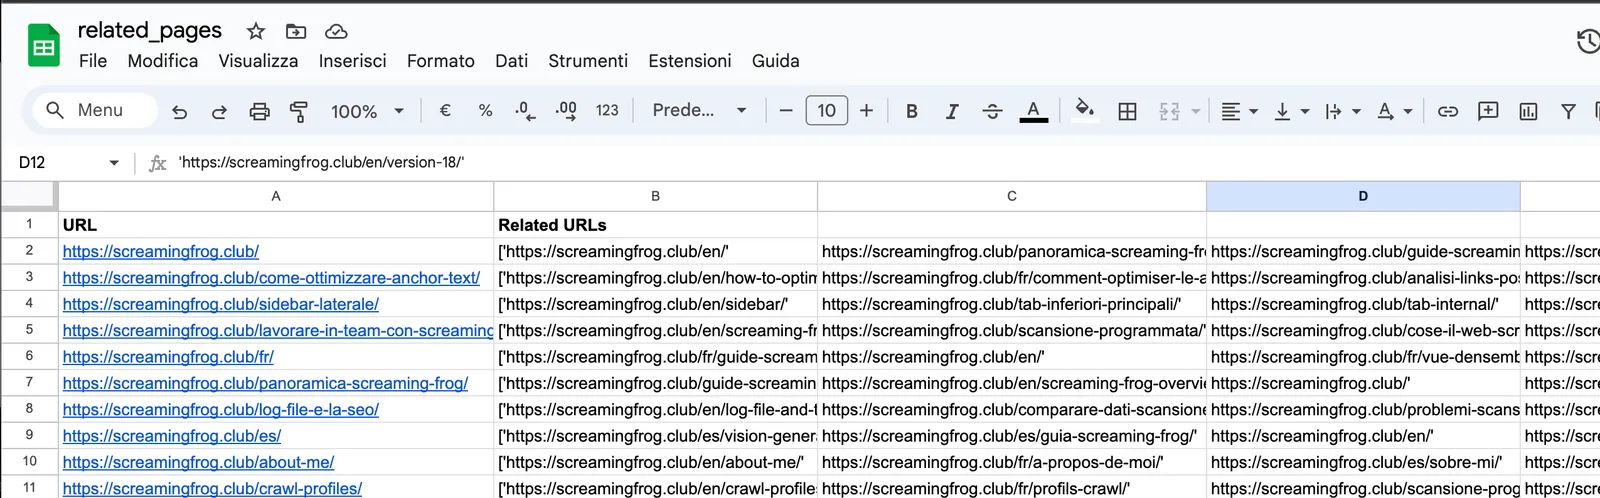
Solo te queda revisar los resultados y hacer los cambios adecuados en el sitio para una «correlación» semántica óptima de los contenidos. Aplicado a los productos de un e-commerce, puede ser una estrategia excelente para mejorar el ROI y el ticket medio.
Clustering
Para el clustering con embeddings puedes usar distintos algoritmos como K-means o DBSCAN, que emplean diferentes métricas de similitud para crear grupos homogéneos. Para mi script usé la librería «pandas» para manejar los datos, «sklearn» para el clustering y «matplotlib + seaborn» para generar una imagen y un archivo CSV. El archivo de datos tenía el mismo formato que el anterior, con dos columnas: «URL» y «Embeddings».
# Import the libraries you need
import pandas as pd
import numpy as np
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
import seaborn as sns
from google.colab import files

# Upload the file
uploaded = files.upload()

# Read the file into a DataFrame
df = pd.read_csv(next(iter(uploaded)))

# Embeddings are stored as list strings: convert them to numpy arrays
df['Embeddings'] = df['Embeddings'].apply(eval).apply(np.array)

# Choose the number of clusters
n_clusters = 5  # Change this value as you like

# Extract the embeddings
embeddings = np.vstack(df['Embeddings'].values)

# Run the clustering
kmeans = KMeans(n_clusters=n_clusters, random_state=0).fit(embeddings)
df['Cluster'] = kmeans.labels_

# Reduce dimensionality for the visualisation
pca = PCA(n_components=2)
embeddings_2d = pca.fit_transform(embeddings)

# Add the PCA components to the DataFrame
df['PCA1'] = embeddings_2d[:, 0]
df['PCA2'] = embeddings_2d[:, 1]

# Save the CSV file with the clusters
output_csv = 'clustered_data.csv'
df.to_csv(output_csv, index=False)
files.download(output_csv)

# Create an image with the clusters
plt.figure(figsize=(10, 7))
sns.scatterplot(x='PCA1', y='PCA2', hue='Cluster', data=df, palette='viridis', s=100)
plt.title('Clusters of Embeddings')
plt.xlabel('PCA1')
plt.ylabel('PCA2')
plt.legend()
plt.grid(True)

# Save the image
output_image = 'clusters_plot.png'
plt.savefig(output_image)
files.download(output_image)

# Show the image
plt.show()¿Dudas sobre Embeddings SEO con Screaming Frog?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
