

Informes.
Resumen de los informes disponibles en Screaming Frog para análisis detallados y precisos.
Resumen de los informes de SEO Spider: crawl overview, redirecciones, canonicals, paginación, hreflang, páginas huérfanas, contenido no seguro, datos estructurados, PageSpeed, cabeceras HTTP, cookies y crawl path. Para qué sirve cada uno.
Informes de oportunidades
En los últimos años Screaming Frog ha invertido mucho en actualizar su rastreador y, con ello, han crecido también los «Reports» disponibles. La herramienta te permite exportar datos a placer, con toda una serie de documentos específicos para analizar en detalle la mayoría de los problemas.
La lista de documentos está en el menú principal y puedes guardarlos en local en formato ‘.csv’, ‘.xls’, ‘xlsx’ o como ‘gsheet’ con Google Drive. En este último caso, los encontrarás en la carpeta «Screaming Frog SEO Spider» de Drive.
Crawl Overview
Este informe te da los datos que ves en la barra lateral de SEO Spider.
Es un resumen sintético del rastreo, muy útil como primera visión de conjunto de cada pestaña y sus filtros.
Redirects
Estos documentos se centran en las redirecciones descubiertas durante el rastreo e identifican el origen del enlace.
Ahora mismo hay tres informes disponibles:
- All Redirects: muestra cada redirección y señala si hay cadenas.
- Redirect Chains: incluye las URL con 2 o más redirecciones consecutivas, que forman una peligrosa «cadena de redirecciones».
- Redirect and Canonical Chains: identifica las URL con al menos 2 redirecciones y cadenas de URL «canonical».
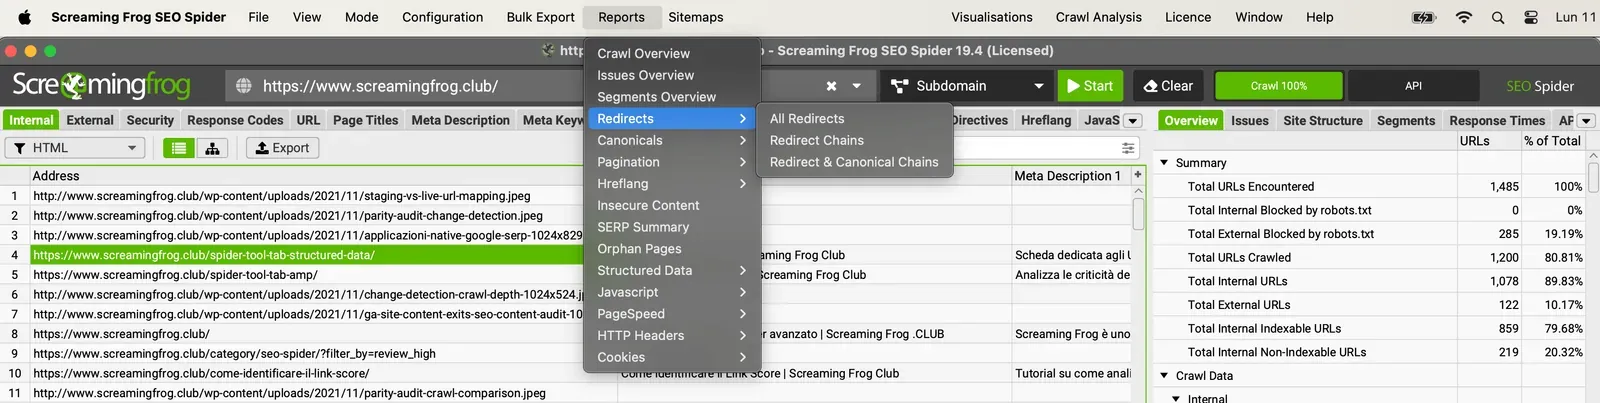
Los documentos «Redirect Chains» y «Redirect and Canonical Chains» son muy útiles para mapear cadenas de redirecciones y canonicals y situaciones de «bucle», mostrando el número de saltos y las URL de origen.
En modo Spider (1Mode›2Spider) estos informes muestran todas las redirecciones descubiertas a partir de un solo salto.
El documento se divide en columnas e incluye:
- el «número de redirecciones»;
- el tipo de cadena identificada:
- HTTP Redirect,
- JavaScript Redirect,
- Canonical,
- etc.;
- si existen bucles de redirección.
Si el informe no tiene filas, el Spider no ha encontrado bucles ni cadenas de redirecciones que optimizar.
También puedes descargar los informes ‘Redirects’, ‘Redirect Chains’ y ‘Redirect & Canonical Chains’ al rastrear en modo lista (1Mode›2List). En ese caso, el documento muestra una fila por cada URL de la lista.
Si marcas «Always Follow Redirects» y «Always Follow Canonicals», SEO Spider seguirá rastreando redirecciones y canonicals en modo lista sin tener en cuenta la profundidad. En resumen, seguirá todos los pasos hasta el destino final.
Nota: los documentos de redirecciones te serán especialmente útiles en una migración, para comprobar que el posicionamiento adquirido se transmite bien y no malgastar Crawl Budget.
Canonical
Los documentos ‘Canonical Chains’ y ‘Non-Indexable Canonicals’ señalan errores y problemas con los elementos link canonical o con los canonicals HTTP.
1. El informe «Canonical Chains» señala cualquier URL con más de 2 enlaces canónicos en cadena:
- la URL A está «canonicalizada» con una «URL canónica» hacia la URL B;
- la URL B está a su vez «canonicalizada» hacia la URL C.
2. El informe ‘Non-Indexable Canonicals’ señala errores y problemas con los enlaces canónicos. En concreto, muestra todos los enlaces canónicos que apuntan a URL bloqueadas por el robots.txt, con códigos 3XX, 4XX o 5XX o cualquier respuesta distinta de 200 ‘OK’.
Este informe también da datos de todas las URL que SEO Spider ha descubierto mediante un enlace «canonical» pero que no tienen enlaces internos desde el sitio.
Aparece en la columna ‘unlinked’ con el valor ‘true’.
Pagination
SEO Spider tiene dos informes de paginación:
- «Non-200 Pagination URLs»
- «Unlinked Pagination URLs»
Estos dos documentos son muy útiles para detectar errores y problemas con los atributos de paginación «rel=prev» y «rel=next».
Con «Non-200 Pagination URLs» identificas cada URL cuyos atributos «rel=prev» y «rel=next» apuntan a recursos con un código de estado distinto de 200.
«Unlinked Pagination URLs» te ayuda a localizar todas las URL que SEO Spider ha descubierto gracias a los atributos «next/prev» pero que no tienen ningún enlace interno en el sitio.
En el momento de escribir esta guía, Google ya no tiene en cuenta estos atributos, aunque otros buscadores los siguen usando.
Hreflang
La etiqueta hreflang permite a Google conocer las distintas versiones de idioma de una página y servir la más adecuada a cada usuario según su navegador.
Screaming Frog ofrece 7 documentos descargables, cada uno con un enfoque distinto sobre el atributo:
- All Hreflang URLs: el informe más completo, que recoge todas las URL y URL hreflang, con las indicaciones de región e idioma descubiertas durante el rastreo.
- Non-200 Hreflang URLs: muestra qué páginas tienen enlaces hreflang hacia páginas con un código de estado distinto de 200 (no response, blocked by robots.txt, respuestas 3XX, 4XX o 5XX).
- Unlinked Hreflang URLs: recoge todas las URL descubiertas mediante un enlace hreflang que no tienen ni un solo hipervínculo en el sitio (p. ej. páginas huérfanas).
- Missing Confirmation Links: identifica las URL a las que les falta el «enlace de confirmación». Por ejemplo, la página A tiene un hreflang hacia la B e indica al bot que A y B son dos versiones de idioma del mismo contenido, pero B no tiene hreflang hacia A, lo que crea una incongruencia.
- Inconsistent Language Confirmation Links: muestra las páginas de confirmación que usan códigos de idioma incoherentes y distintos para el mismo contenido.
- Non Canonical Confirmation Links: muestra las URL con hreflang hacia elementos «no canónicos». Si «canonicalizas» un elemento, le dices al rastreador que ese contenido tiene una versión principal «canónica», así que esa es la que tu hreflang debería indicar.
- Noindex Confirmation Links: ideal para detectar URL con hreflang hacia recursos con «noindex». También aquí, mandar al bot a recursos «no indexables» crea una enorme contradicción entre bloquear un contenido y pedir que se sirva como versión de idioma.
Páginas huérfanas
Las páginas huérfanas son URL que no reciben ningún enlace interno desde otras páginas del sitio y que el rastreador no puede alcanzar porque están aisladas.
El informe «Orphan Pages» ofrece una lista de URL recogidas mediante la conexión de SEO Spider con las API de Google Analytics y de Google Search Console (Search Analytics API), o encontradas en el sitemap XML, que no coinciden con ninguna URL descubierta durante el rastreo.
En resumen, te da las URL que SEO Spider no ha podido alcanzar por falta de enlaces que seguir o porque los enlaces son «nofollow».
Pero si no tienen enlaces, ¿por qué están en las bases de datos de Google Analytics o Search Console?
Probablemente se indexaron con una versión anterior del sitio o desde otras fuentes como sitemaps XML, o hay referrals que apuntan a ellas.
Para recoger datos sobre las páginas huérfanas basta con configurar las API en los ajustes de SEO Spider.
En 1Configuration›2API Access elige las API que conectar y vincula una cuenta nueva o ya configurada.
Al terminar el rastreo hay que ejecutar la «Crawl Analysis» para rellenar la pestaña correspondiente.
Las fuentes disponibles para controlar las páginas huérfanas son:
- GA: la URL se ha descubierto mediante la API de Google Analytics.
- GSC: la URL se ha descubierto en Google Search Console, mediante la Search Analytics API.
- Sitemap: la URL se ha descubierto mediante el sitemap XML.
- GA & GSC & Sitemap: la URL se ha descubierto en Google Analytics, Google Search Console y el sitemap XML.
Buena práctica: para optimizar tu análisis SEO con la API de Google Analytics 4, te aconsejo usar la página de destino como dimensión y filtrar el canal «Organic Search», para obtener datos más relevantes y evitar páginas de login, de carrito, etc.
Insecure Content
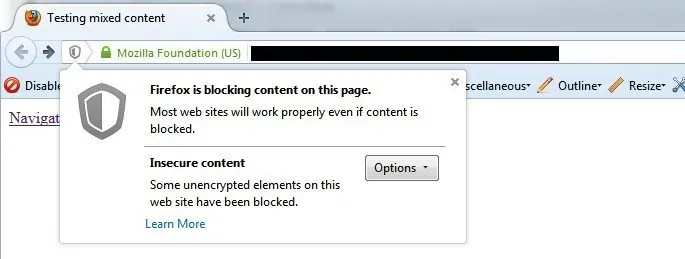
Este informe es muy útil porque señala las URL con contenido considerado no seguro y te ayuda a evitar los avisos de seguridad de los navegadores, que podrían ahuyentar a los visitantes.
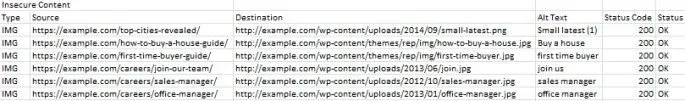
El documento «Insecure Content» muestra todas las URL seguras (HTTPS) que cargan elementos no seguros en HTTP, como enlaces internos, imágenes, JS, CSS, SWF o imágenes externas en un CDN, perfiles sociales, etc.
El informe es especialmente útil en las migraciones, para tener una visión completa de los posibles problemas.
Aquí tienes un ejemplo del archivo en el que los destinos de las imágenes usan «http» y el rastreador no los considera fiables.
Datos estructurados
Como sabes, los datos estructurados informan al buscador y, bien gestionados, aportan enormes beneficios de visibilidad gracias a las distintas funciones de búsqueda.
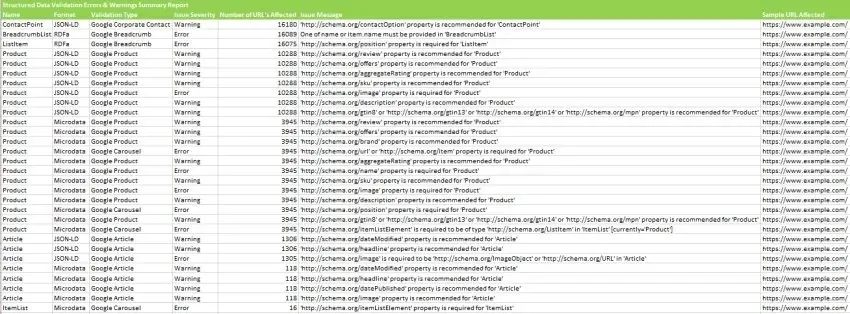
Screaming Frog te ofrece 4 informes para evaluar y corregir problemas de validación de los datos estructurados:
- Validation Errors & Warnings Summary: agrupa los datos estructurados por errores y avisos de validación únicos, con el número de URL afectadas por cada problema y URL de ejemplo.
- Validation Errors & Warnings: muestra en detalle cada error de validación para cada URL, con el nombre de la propiedad (Organization, etc.), el formato (JSON-LD, etc.), la gravedad (error o aviso), el tipo de validación (Google Product, etc.) y el mensaje (p. ej. /review property is required).
- Google Rich Results Features Summary: agrupa los datos por «Google Rich Results Features» detectadas en un rastreo, con el número de URL de cada función.
- Google Rich Results Features: asigna cada URL a las funciones disponibles y muestra cuáles se han detectado en cada una.
PageSpeed
Este informe se basa en la API de PageSpeed Insights y ofrece todos los indicadores principales del tiempo de carga, para un diagnóstico muy preciso de lo que bloquea o perjudica el rendimiento.
Se activa en 1Configuration›2API Access›3PageSpeed Insights.
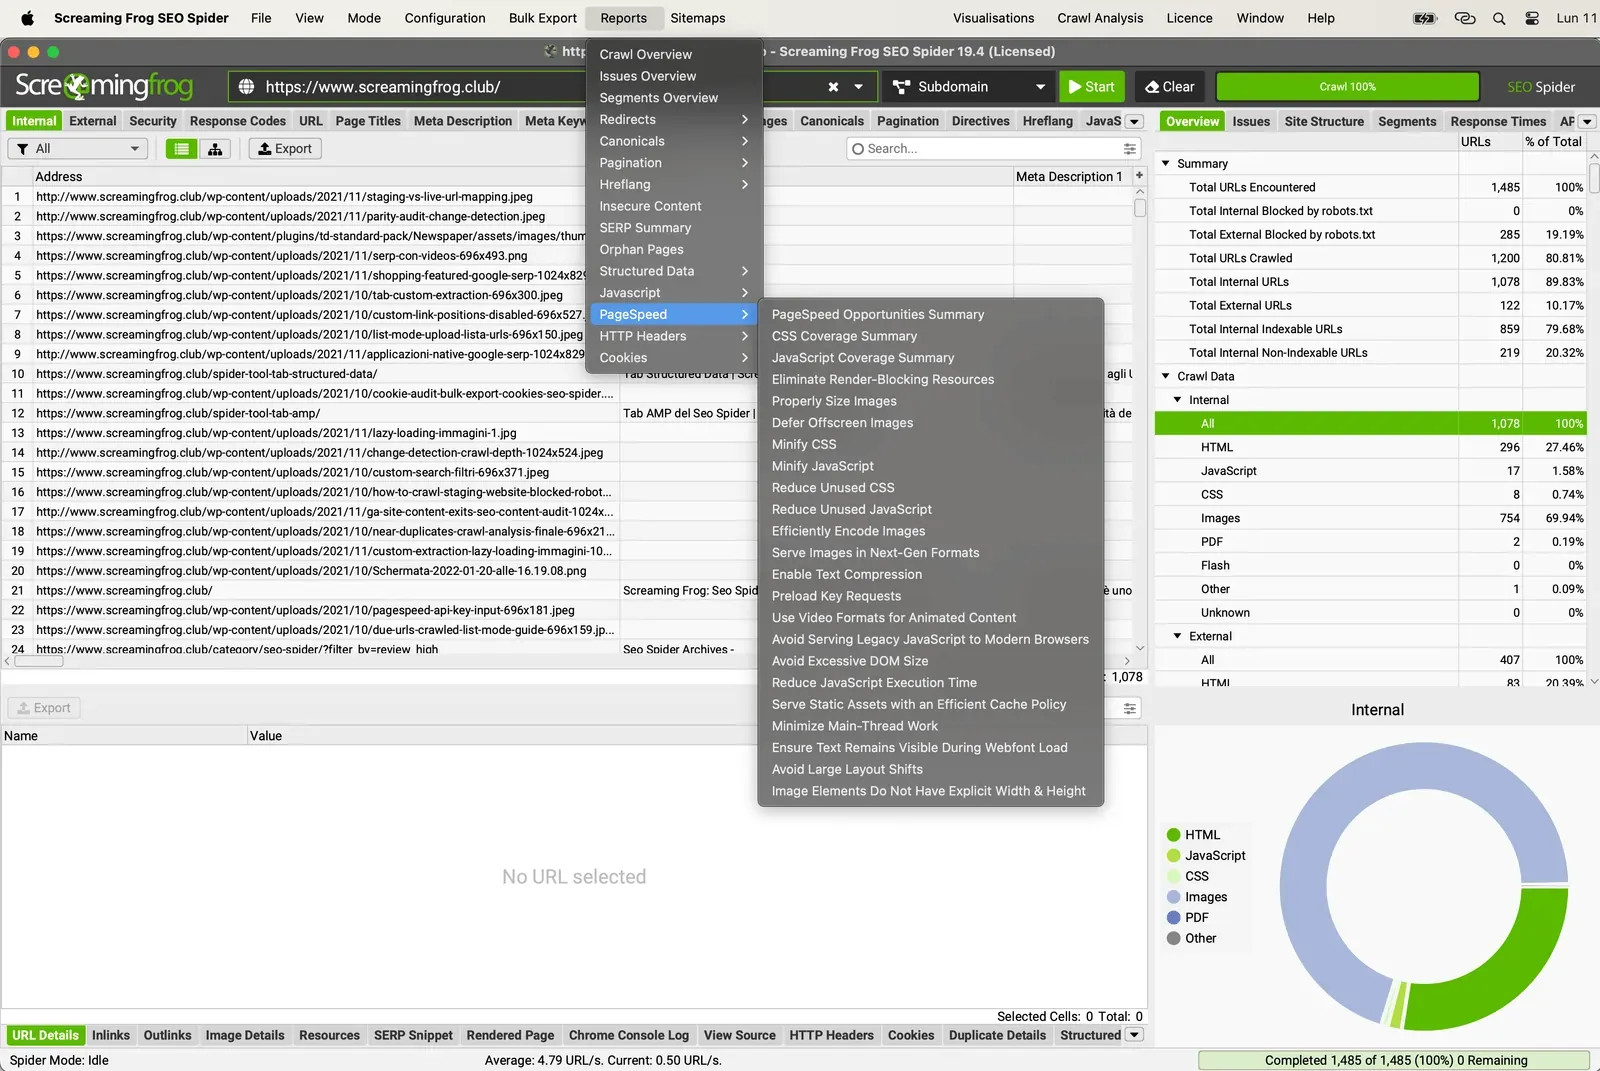
- PageSpeed Opportunities Summary: resume todas las oportunidades únicas del sitio, el número de URL afectadas y el ahorro potencial medio y total en tamaño y milisegundos, para priorizar las intervenciones.
- CSS Coverage Summary: indica el ahorro de tiempo posible si se elimina el código no utilizado de cada CSS cargado en el sitio.
- JavaScript Coverage Summary: muestra cuánto de cada archivo JS no se usa durante el rastreo y el ahorro posible eliminando ese código.
HTTP Header Summary
Este documento ofrece una vista agregada de todas las cabeceras de respuesta HTTP descubiertas en un rastreo. Muestra cada cabecera única y el número de URL únicas que han respondido con ella.
Para rellenarlo, activa HTTP Headers en 1Configuration›2Spider›3Extraction.
Encontrarás los detalles por URL y cabecera en la pestaña «HTTP Headers» de la ventana inferior y exportando desde 1Bulk Export›2Web›3All HTTP Headers.
También puedes consultar las cabeceras HTTP directamente en la pestaña «Internal», donde se añaden en columnas separadas.
Cookie Summary
El informe «Cookie Summary» muestra una vista agregada de las cookies únicas descubiertas en un rastreo, con su nombre, dominio, caducidad y los valores Secure y HttpOnly.
También muestra el número de URL en las que se ha instalado cada cookie.
Para usar este informe basta con activar Cookies en 1Configuration›2Spider›3Extraction.
No olvides activar también el renderizado JavaScript para ver con precisión las cookies que se cargan mediante JavaScript o píxeles.
Este informe agregado es muy útil para cumplir el RGPD.
Tienes más detalles en la pestaña «Cookies» de la ventana inferior y exportando desde 1Bulk Export›2Web›3All Cookies.
Crawl Path
A diferencia de los anteriores, el «Crawl Path Report» no está en el menú principal.
Está disponible haciendo clic derecho en una URL de la ventana superior de SEO Spider y eligiendo 1Export›2Crawl Path Report.
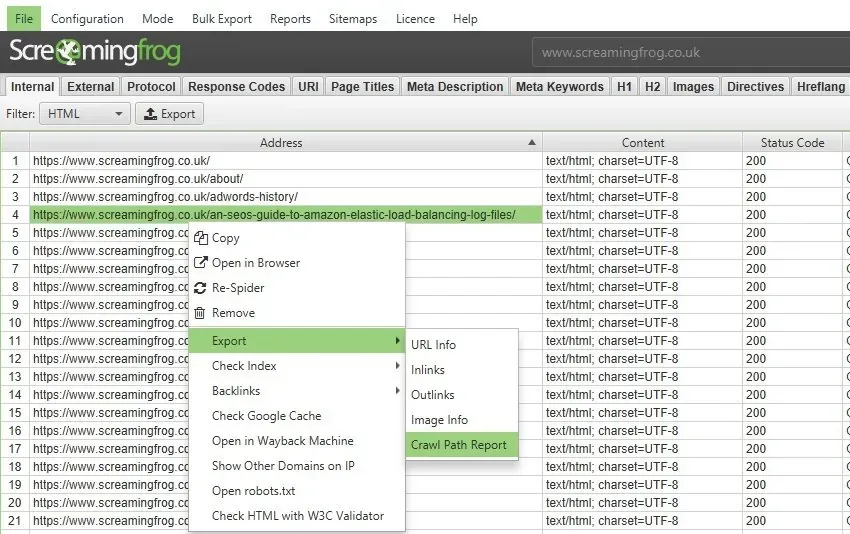
Este informe muestra la ruta más corta que siguió SEO Spider durante el rastreo para descubrir la URL.
Es muy útil para las páginas con una «Crawl Depth» muy profunda y te evita revisar los ‘inlinks’ de muchas URL para encontrar la fuente original; por ejemplo, para diagnosticar URL infinitas causadas por plugins o calendarios.
El informe se lee de abajo arriba. La primera URL al final de la columna ‘source’ es la primera URL rastreada (nivel ‘0’).
La columna ‘destination’ muestra qué URL se rastrearon después, y estas pasan a ser las URL ‘source’ del nivel siguiente (1), y así sucesivamente hacia arriba.
La primera URL de la columna ‘destination’, al principio del informe, es la URL cuya ruta se ha reconstruido.
¿Dudas sobre Informes?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
