Mise à jour Screaming Frog SEO Spider – version 22.0.
Découvre comment utiliser l’analyse sémantique de Screaming Frog pour repérer les contenus similaires et les pages hors sujet et améliorer maillage et redirections en SEO.
Sommaire du guide 11 sections
●Brief01.Screaming Frog – version 2202.Analyse de la similarité sémantiqueLes nouveautés de la version 22 de SEO Spider ("knee-deep") : analyse de similarité sémantique avec les embeddings, contenus peu pertinents, recherche sémantique, nouvelles intégrations IA (dont Anthropic) et nouvelles options d’export.
Screaming Frog – version 22
La version 22.0 de Screaming Frog SEO Spider, baptisée « knee-deep », vient de sortir.
Une vraie révolution pour SEO Spider, qui nous surprend une fois de plus avec de nouvelles intégrations IA et confirme sa place de leader parmi les outils SEO les plus polyvalents et efficaces au monde.
Analyse de la similarité sémantique
Tu peux désormais analyser la similarité sémantique des pages d’un crawl pour repérer les contenus dupliqués, similaires ou potentiellement hors sujet et peu pertinents d’un site.
Analyse de la similarité sémantique des pages crawlées
- Cette fonction va au-delà de la simple comparaison textuelle utilisée pour détecter le contenu dupliqué : elle exploite les embeddings générés par des modèles de langage (LLM), qui captent le sens des mots et leurs relations sémantiques.
Tu peux ainsi identifier des pages similaires même quand elles utilisent des formulations différentes mais traitent des mêmes sujets, ce qui crée des contenus redondants, de la cannibalisation ou des inefficacités de crawl et d’indexation.
Si tu ne connais pas encore les embeddings, je te conseille l’article de Mike King « Vector Embeddings is All You Need ». Il a inspiré de nombreux SEO à expérimenter et à créer des outils innovants fondés sur ces technologies.
Grâce à l’intégration des principaux fournisseurs d’IA (OpenAI, Gemini, Ollama), accessible depuis 1Configuration›2API Access, tu obtiens facilement les embeddings vectoriels des pages crawlées.
L’analyse de similarité sémantique dans les outils de crawl (comme Screaming Frog) est un tournant stratégique pour le SEO technique et éditorial, pour plusieurs raisons clés :
1. Elle va au-delà de la simple détection du contenu dupliqué
Jusqu’ici, les outils SEO s’appuyaient sur la correspondance littérale du texte pour repérer les doublons. Cette approche ignore les nuances sémantiques qui peuvent suffire à l’utilisateur mais être considérées comme « dupliquées » par les moteurs.
Avec les embeddings des LLM, on analyse le sens du contenu et on détecte les similitudes conceptuelles même quand la formulation diffère.
✅ Exemple : deux pages qui parlent du même produit avec des textes différents peuvent désormais être identifiées comme se recoupant, ce qui facilite l’analyse de la « cannibalisation ».
2. Elle aide à prévenir la cannibalisation des contenus
Beaucoup de sites, surtout les grands e-commerces ou les portails éditoriaux, publient au fil du temps plusieurs contenus sur le même sujet. Cela entraîne :
- Une concurrence interne dans les résultats (cannibalisation)
- Une confusion pour Google dans le choix de la page à indexer
- Un gaspillage du crawl budget
Grâce à cette analyse, tu peux :
- Repérer les pages redondantes sur le plan thématique
- Regrouper les contenus similaires en ressources plus fortes (par redirection ou fusion)
- Clarifier l’architecture de l’information
3. Elle enrichit l’audit SEO d’insights de haut niveau
L’analyse sémantique permet de :
- Cartographier à grande échelle les sujets qui se chevauchent
- Analyser la répartition thématique des pages
- Repérer des clusters de contenus similaires, même sans tags ni catégorisation manuelle
Cela ouvre de nouvelles possibilités stratégiques, comme :
- Restructurer un blog ou une rubrique éditoriale
- Repérer les manques de contenus (topic gaps)
- Optimiser les relations internes avec un maillage thématique plus précis
4. Elle intègre concrètement l’IA dans le travail SEO
Beaucoup de SEO parlent d’IA, mais peu d’outils l’ont intégrée de façon utile. Cette fonction :
- Utilise de vrais embeddings vectoriels, pas une correspondance de mots-clés
- S’appuie sur des fournisseurs avancés comme OpenAI ou Gemini
- Automatise l’analyse sémantique à grande échelle, ce qui prendrait des heures ou des jours à la main
C’est une fonction essentielle pour l’optimisation avancée des contenus, en particulier sur des sites moyens à grands ou avec un long historique éditorial.
Voyons comment configurer Screaming Frog pour profiter de cette nouvelle fonction.
D’abord, il faut utiliser l’intégration IA de SEO Spider pour vectoriser les pages.
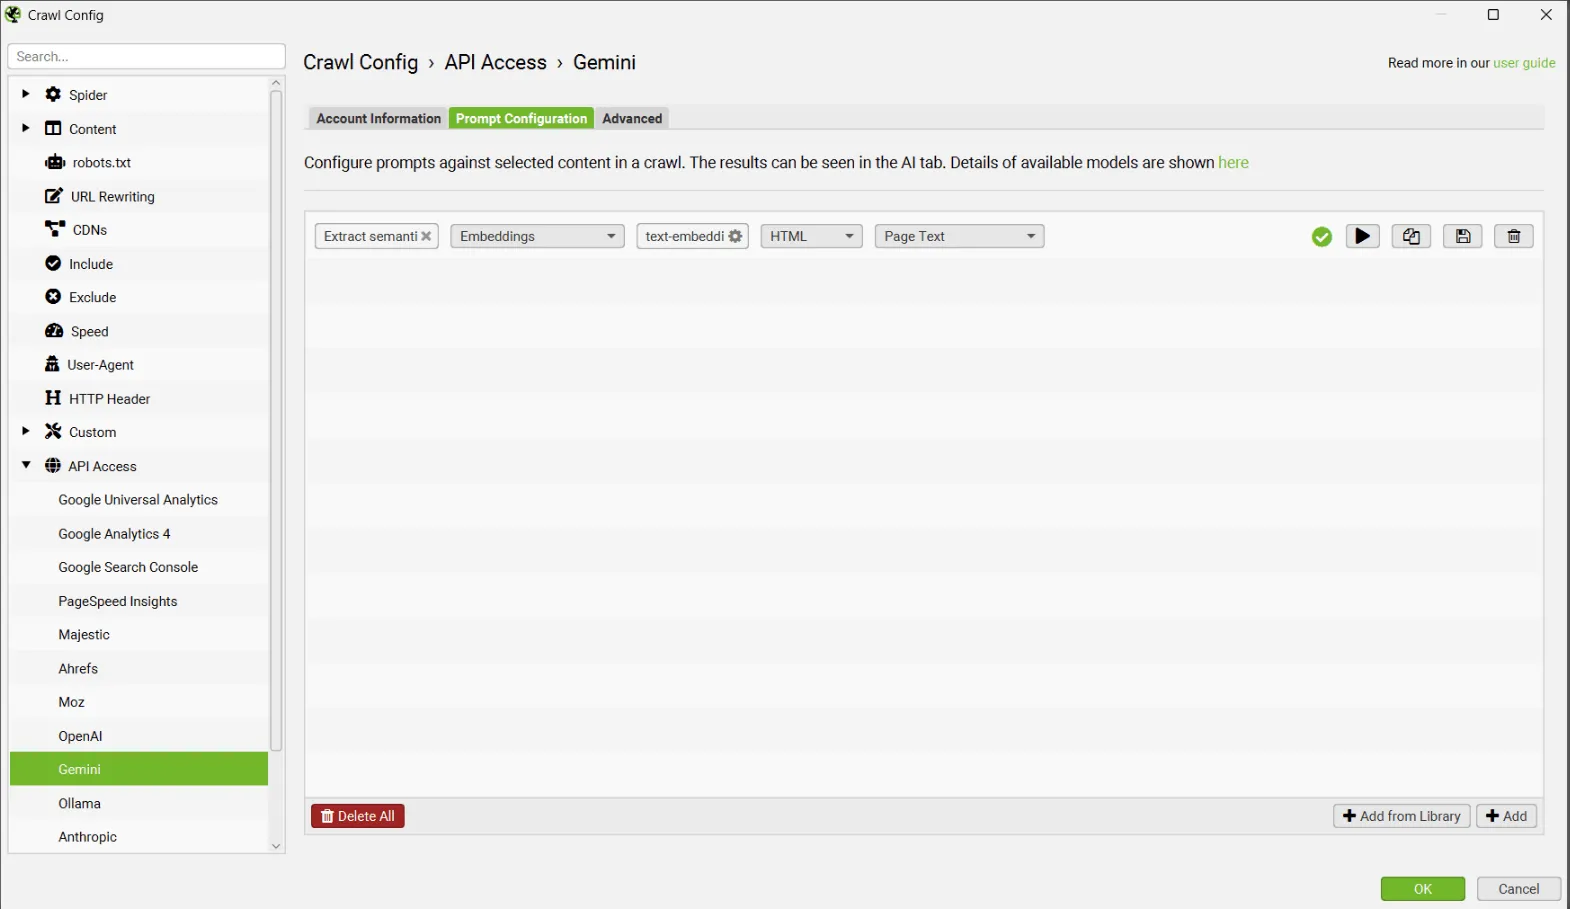
Tu peux ensuite activer l’analyse sémantique dans SEO Spider depuis 1Configuration›2Content›3Embeddings pour l’analyse sémantique des contenus, la recherche sémantique et les visualisations.
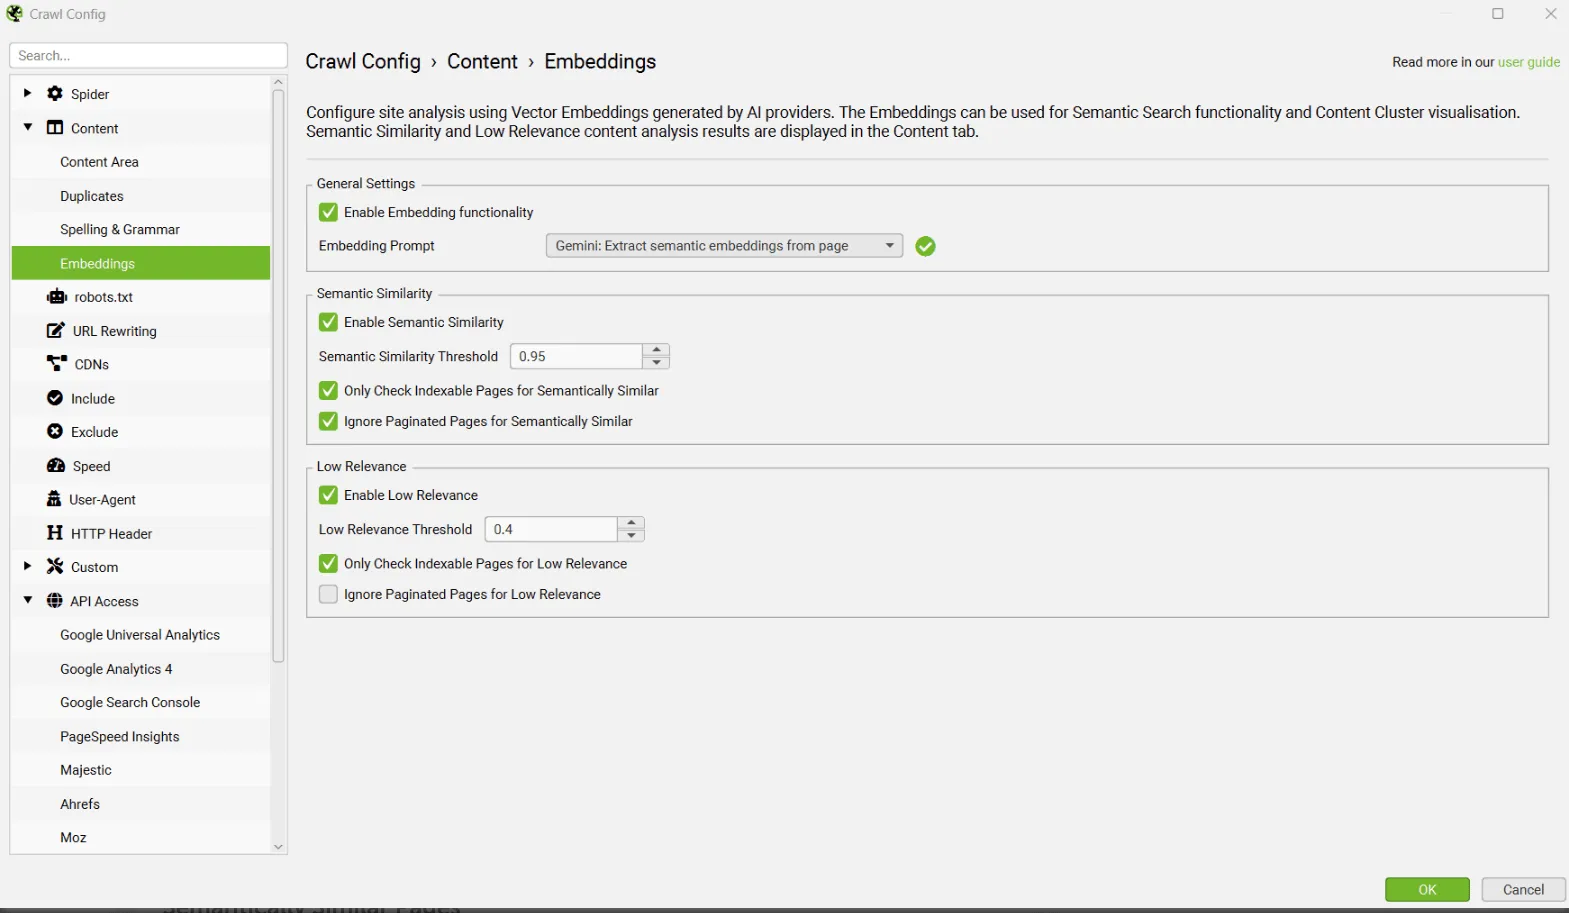
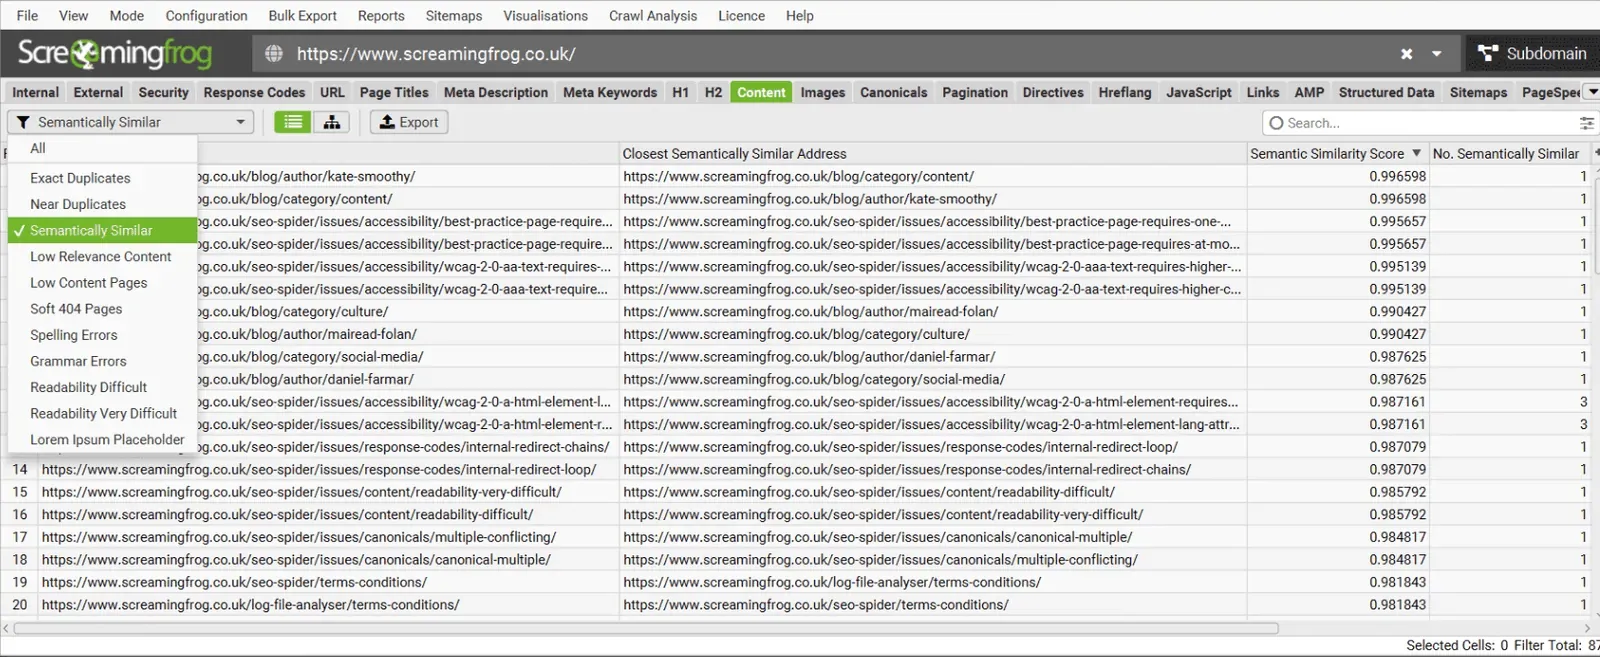
Une fois le crawl terminé et la Crawl Analysis exécutée, les filtres « Semantically Similar » et « Low Relevance Content » sont disponibles dans l’onglet Content.
Pages sémantiquement similaires
Dans l’onglet Content, tu peux filtrer par « Semantically Similar ». Les résultats montrent pour chaque URL l’adresse sémantiquement la plus proche, un score de similarité sémantique et le nombre d’URL sémantiquement similaires.
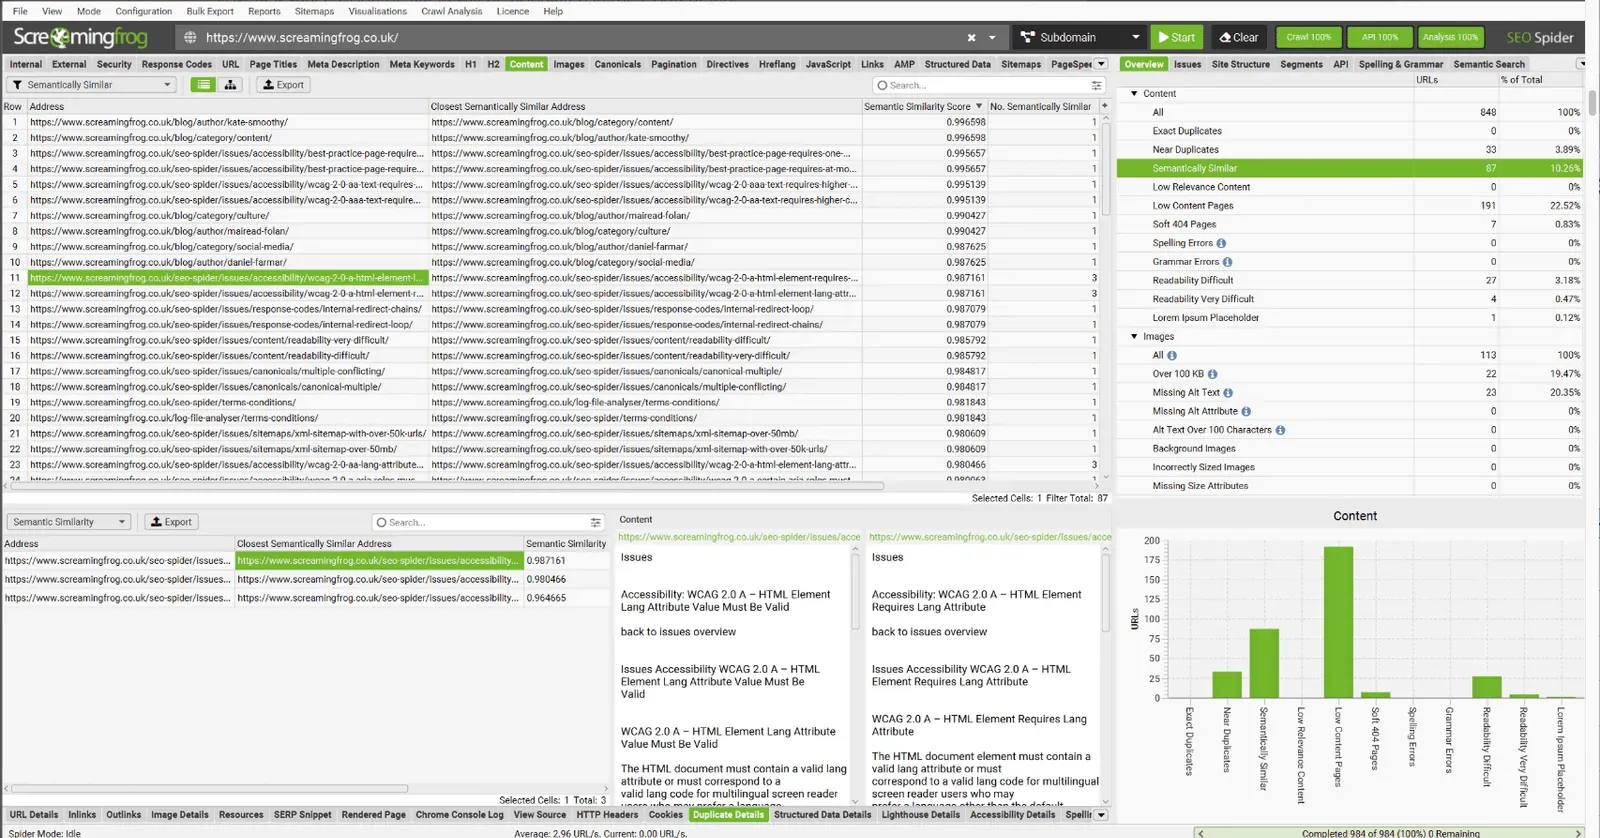
En bas de SEO Spider, l’onglet « Duplicate Details » et le filtre « Semantic Similarity » affichent toutes les URL sémantiquement similaires et le contenu analysé.
SEO Spider attribue un score de similarité sémantique compris entre 0 et 1.
Plus le score est élevé, plus la page ressemble à l’adresse sémantiquement la plus proche.
Par défaut, les pages au-dessus de 0,95 sont considérées comme sémantiquement similaires.
Pour une analyse plus fine et personnalisée, tu peux abaisser le seuil de similarité jusqu’à 0,5 dans 1Configuration›2Content›3Embeddings.
Contenus peu pertinents
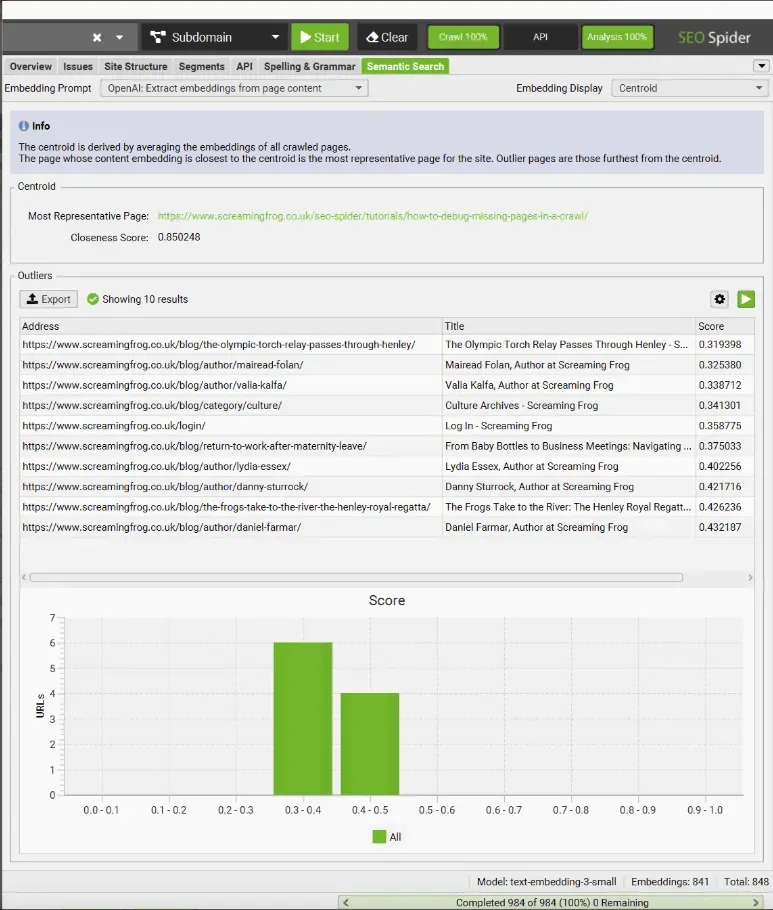
Les embeddings vectoriels (représentations numériques du sens d’un texte) servent non seulement à trouver des contenus similaires, mais aussi à repérer les pages potentiellement hors sujet par rapport à la thématique générale du site (le « centroïde »).
Mesurer l’écart entre l’embedding d’une page et celui de l’ensemble du site est une idée évoquée aussi dans la récente fuite de documents de Google. Certains SEO l’expérimentent pour repérer les contenus « anormaux » ou hors contexte.
Les pages atypiques (incohérentes avec le site) sont les plus éloignées de la moyenne et peuvent indiquer une faible pertinence : un contenu « plus hors sujet » que le reste du site.
Les pages sous le seuil apparaissent dans l’onglet « Content », filtre « Low Relevance Content ».
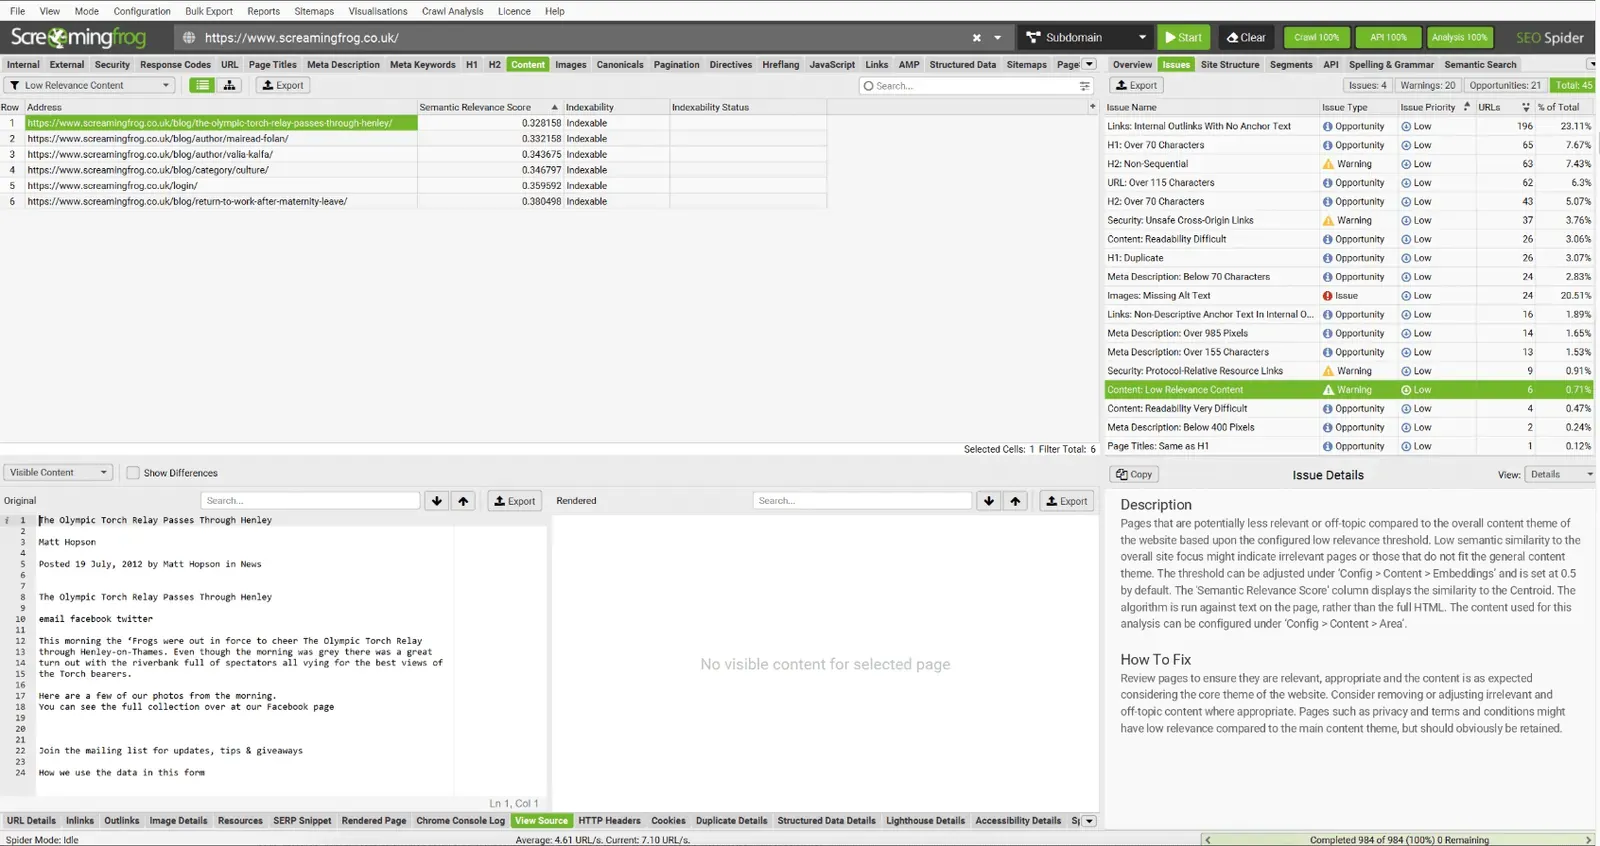
L’analyse sémantique pousse le SEO au-delà de la correspondance de mots-clés.
Elle permet de raisonner en sujets, en sens et en cohérence globale, aussi bien pour optimiser le site existant que pour aborder plus intelligemment migrations, restructurations ou enrichissements de contenus.
Ce n’est qu’un début : l’évolution de ces outils dépendra de la créativité des SEO qui les utiliseront.
Contenus sémantiques et visualisation des clusters
Deuxième nouveauté très intéressante de la version 22 de Screaming Frog : l’analyse sémantique intégrée aux visualisations de clusters.
Le diagramme des clusters de contenus est disponible dans 1Visualisations›2Content Cluster Diagram. C’est une visualisation en deux dimensions des URL du crawl, placées et regroupées selon leurs embeddings.
Il sert à repérer des schémas et des relations dans les contenus du site, les contenus sémantiquement proches étant regroupés.
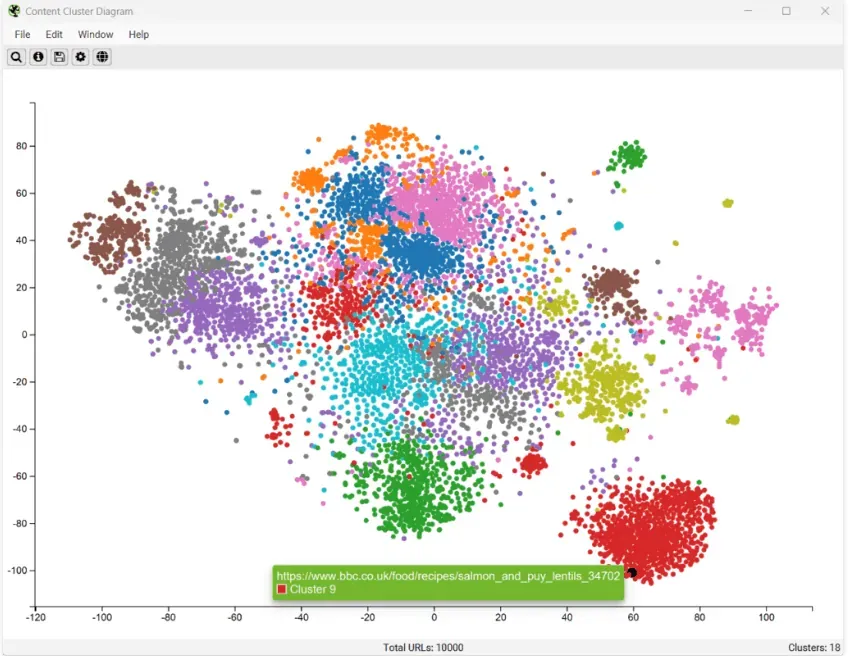
Ces diagrammes aident à visualiser l’ampleur des clusters de contenus d’un site ou à repérer des clusters thématiques sémantiquement liés mais présentés de façon éloignée pour l’utilisateur.
Recherche sémantique
Depuis la version 22 de Screaming Frog, un nouvel onglet « Semantic Search » dans la barre latérale permet de saisir une requête et d’afficher les pages les plus pertinentes d’un crawl.
Cette fonction vectorise la requête et calcule la similarité cosinus entre la requête et les pages du crawl, avec des embeddings vectoriels plutôt que des mots-clés.
Elle aide à quantifier la pertinence des contenus par rapport à une requête pour toutes les pages d’un crawl, et se rapproche davantage de la façon dont les moteurs modernes et les LLM restituent les contenus aujourd’hui que la simple présence de mots-clés dans le texte (filtre Cosine Similarity Search).
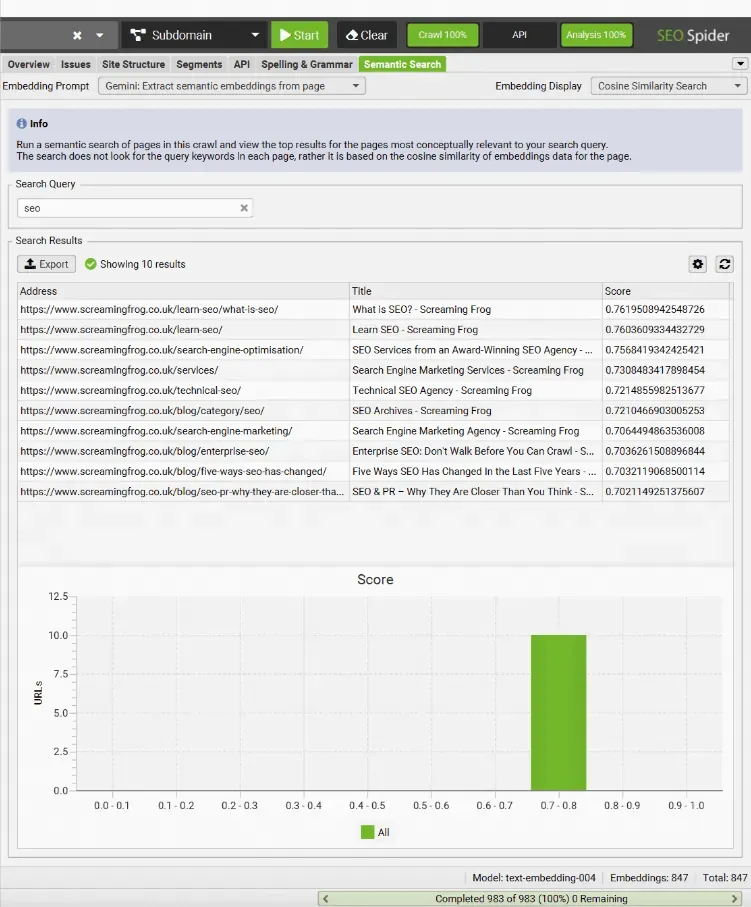
Cette fonction peut servir, par exemple, à trouver des pages pertinentes pour le mapping des mots-clés, des pages liées pour le maillage interne ou l’analyse concurrentielle sur des mots-clés.
Le filtre « Embedding Display » peut être réglé sur ‘Centroid’ pour voir plus de détails sur les pages atypiques du site et sur la « page la plus représentative », la plus proche de la moyenne des embeddings du site.
Améliorations des intégrations IA
SEO Spider apporte aussi une série d’améliorations de l’intégration IA pour la rendre plus avancée et flexible et réduire le gaspillage de crédits et de requêtes.
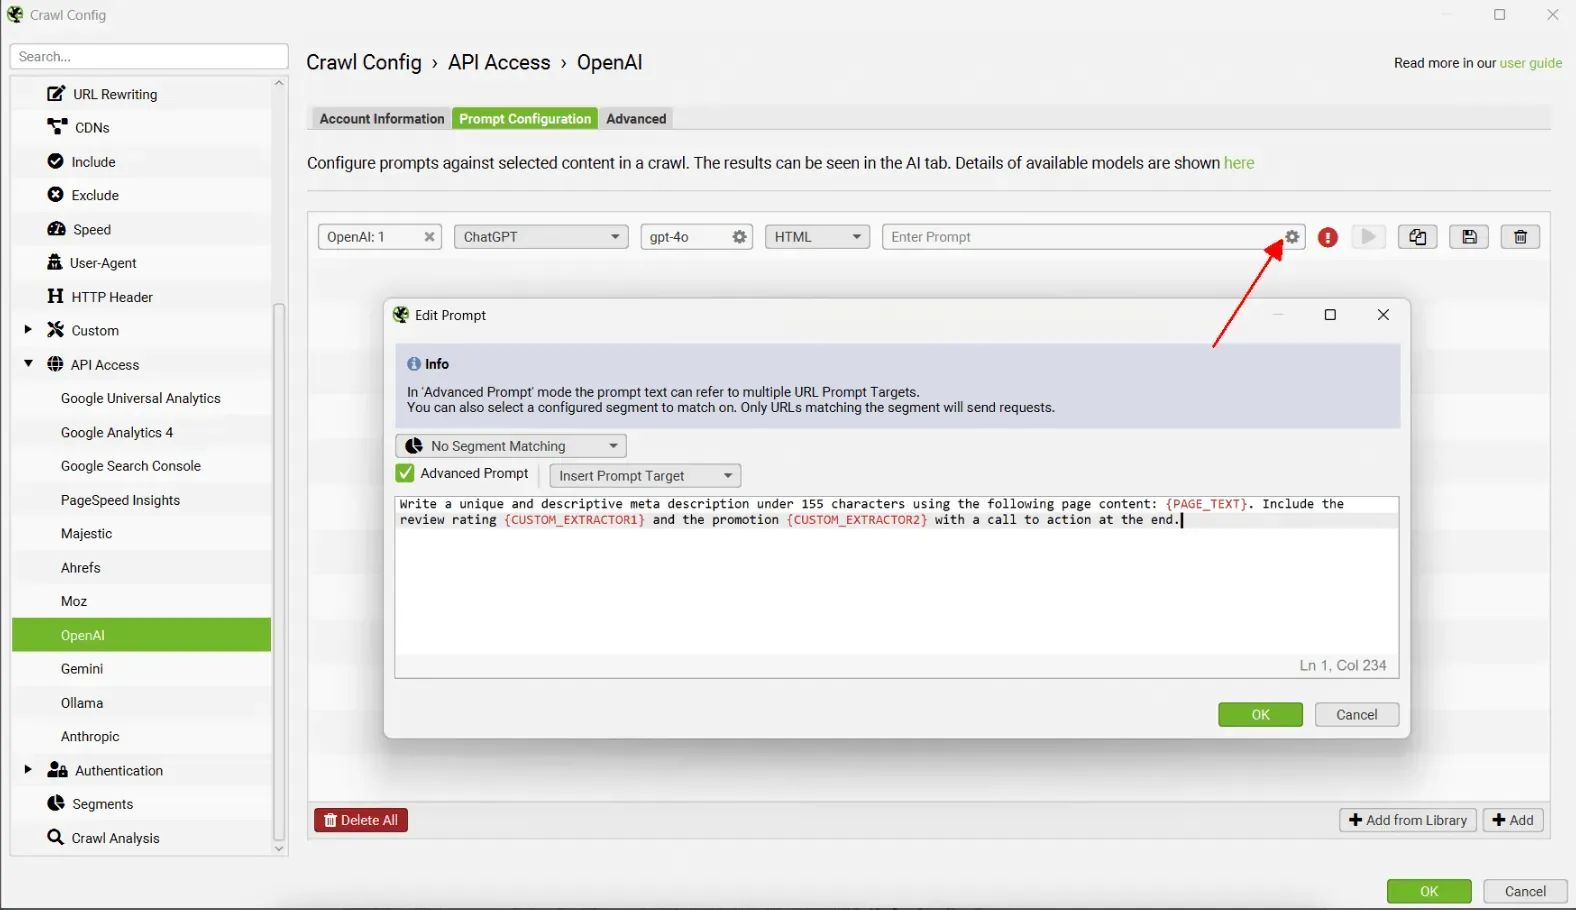
Plusieurs cibles de prompt
Tu peux maintenant cliquer sur l’engrenage à côté d’un prompt et écrire un prompt plus avancé, qui inclut plusieurs cibles.
Prompts pour des segments et problèmes précis
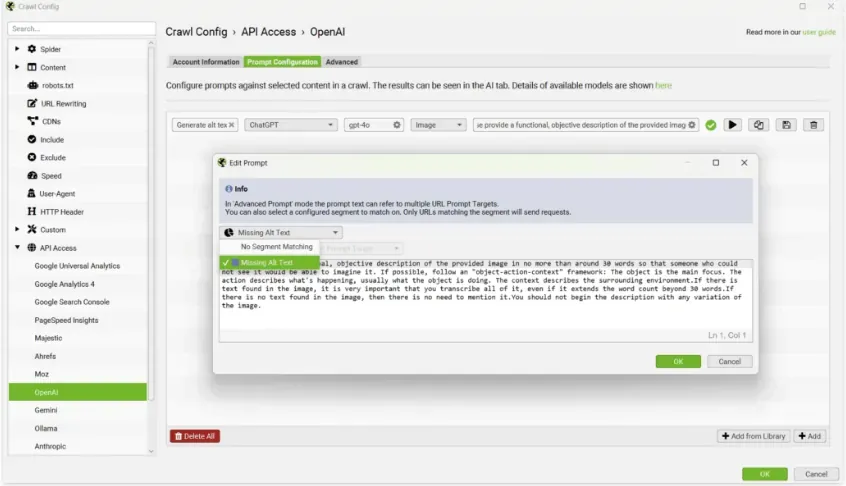
Tu peux choisir d’exécuter les prompts IA uniquement sur les URL d’un segment précis. Tu peux donc créer des segments pour les différents cas où tu veux lancer des prompts, sans gaspiller de crédits.
Dans le prompt avancé, tu peux choisir « Match segment ».
Cela permet de préserver tes crédits et de mieux gérer ton budget d’appels IA.
Par exemple, tu peux générer le texte alternatif uniquement pour les URL d’images du segment qui présente le problème « Missing Alt Text », au lieu de toutes les images.
Endpoint personnalisé
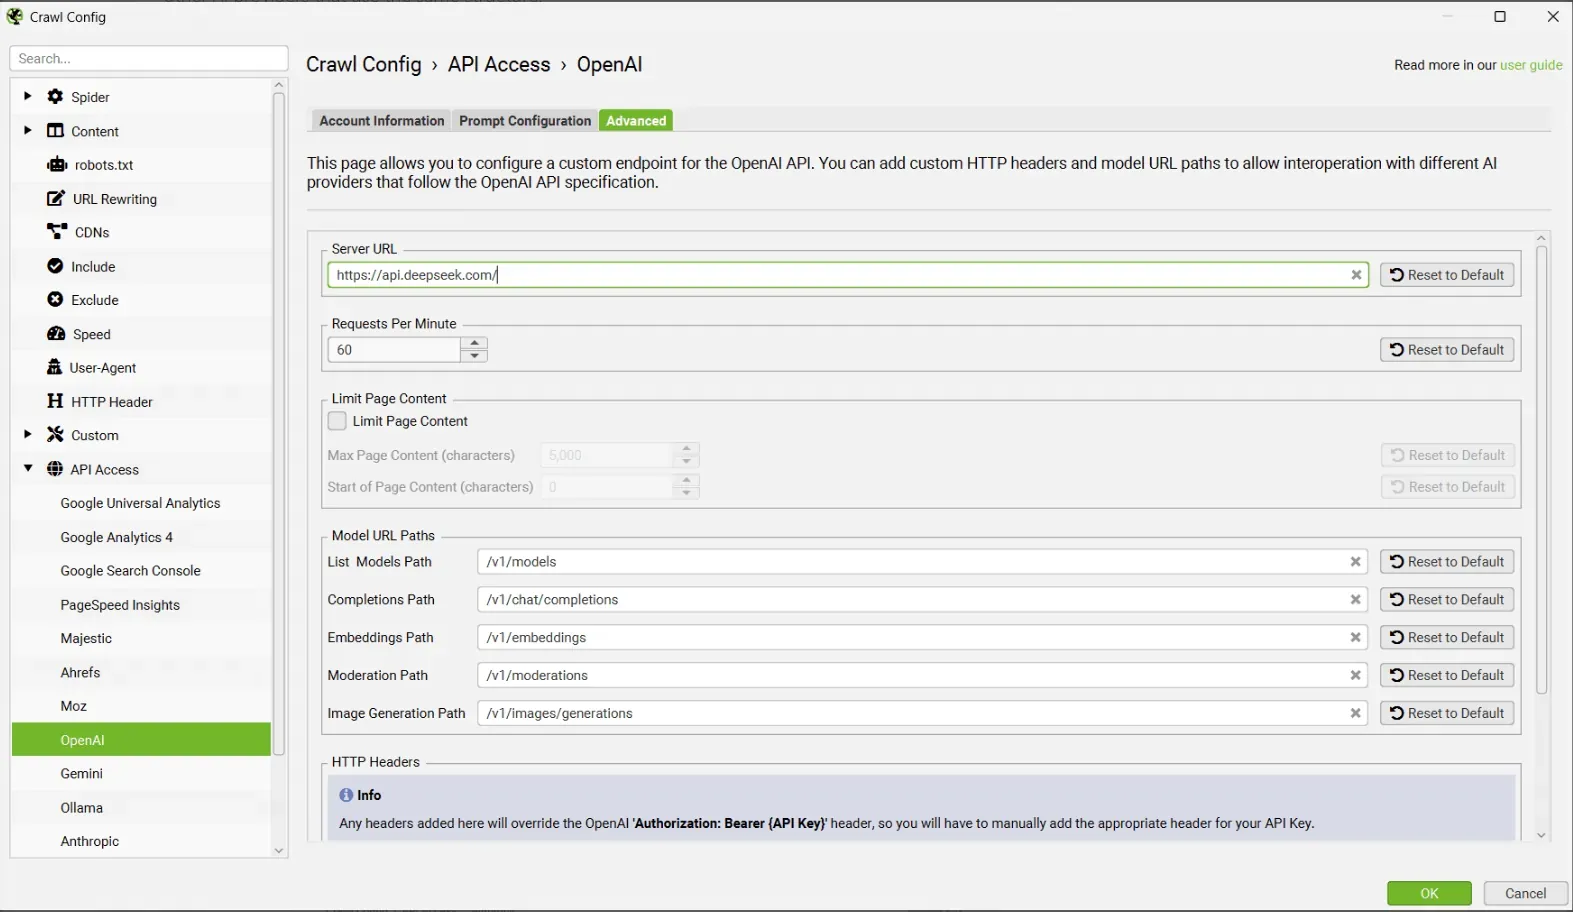
Tu peux désormais personnaliser l’endpoint OpenAI, ce qui permet d’utiliser des API de LLM privées et d’autres fournisseurs d’IA qui suivent la même structure.
Par exemple, tu peux utiliser DeepSeek, Microsoft Copilot ou Grok en personnalisant l’endpoint et en utilisant la clé API correspondante.
Tu peux aussi personnaliser les paramètres du modèle et les en-têtes, et limiter la longueur du contenu de la page pour réduire les erreurs de dépassement de tokens sur les pages longues.
Intégration d’Anthropic
Comme pour OpenAI, Gemini et Ollama, tu peux maintenant intégrer Anthropic (alias « Claude ») depuis 1Configuration›2API Access pour lancer des requêtes IA pendant le crawl.
Configurateur avancé des colonnes
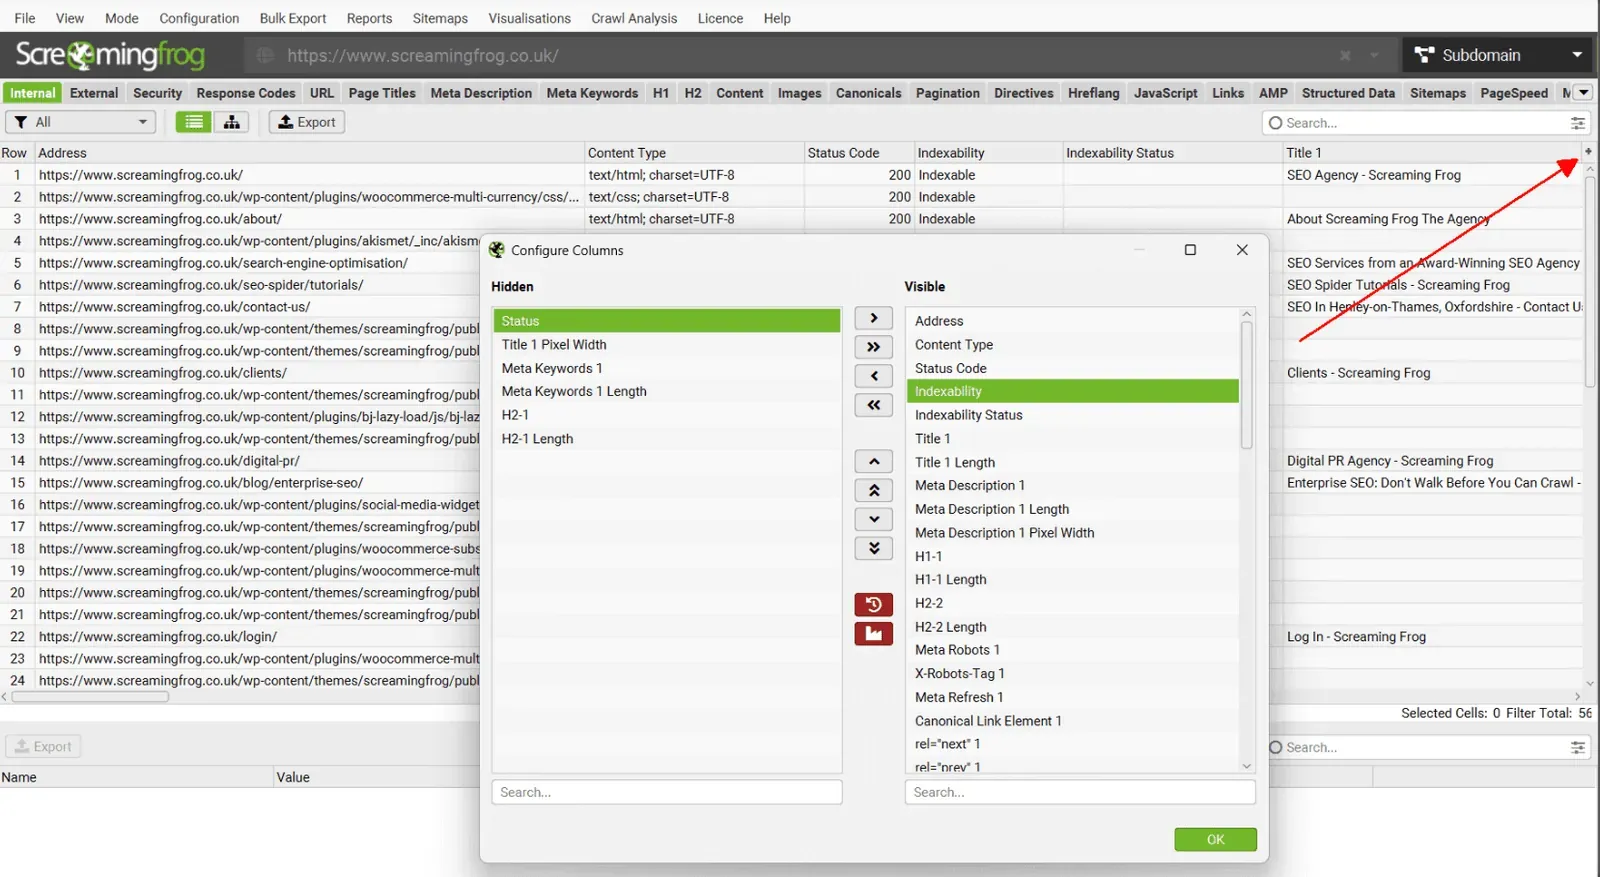
Comme pour les onglets, tu peux désormais configurer les colonnes avec un configurateur avancé qui permet de les sélectionner, masquer et réordonner en masse. Avec les fonctions « detach », tu peux ainsi organiser ton espace de travail pour garder toujours sous les yeux l’objet de ton analyse.
Nouveautés de l’export des données
Multi-Export personnalisé
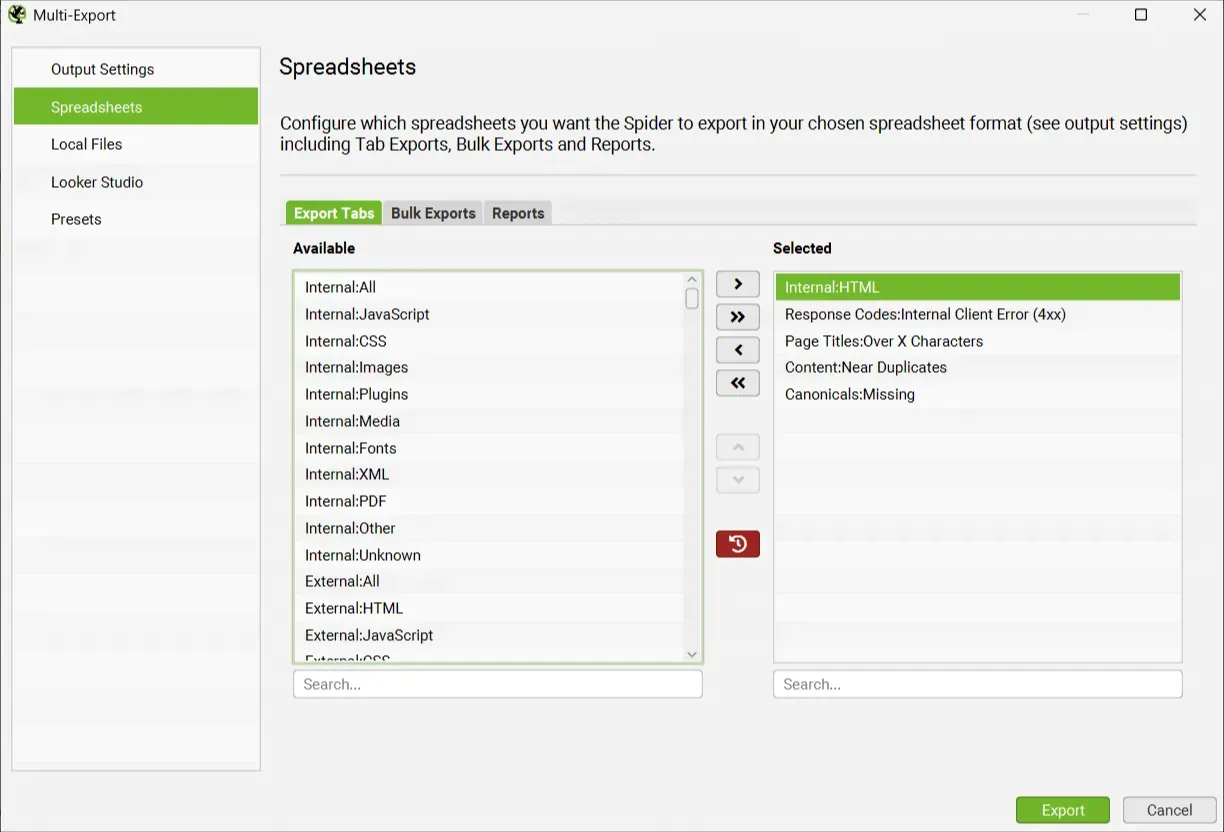
Il y a une nouvelle option « Multi-Export » dans le menu « Bulk Export ».
Elle permet de sélectionner des onglets, exports en masse ou rapports à exporter en un seul clic.
Si tu utilises un ensemble de rapports récurrent pour tes crawls, ou des exports spécifiques pour certains sites, tu peux les enregistrer comme préréglages et les utiliser au besoin, manuellement dans l’interface comme dans la planification et la CLI.
Cette nouveauté permet aussi de lancer l’Export for Looker Studio depuis un crawl manuel, et plus seulement depuis la planification.
Multi-Export dans un seul classeur
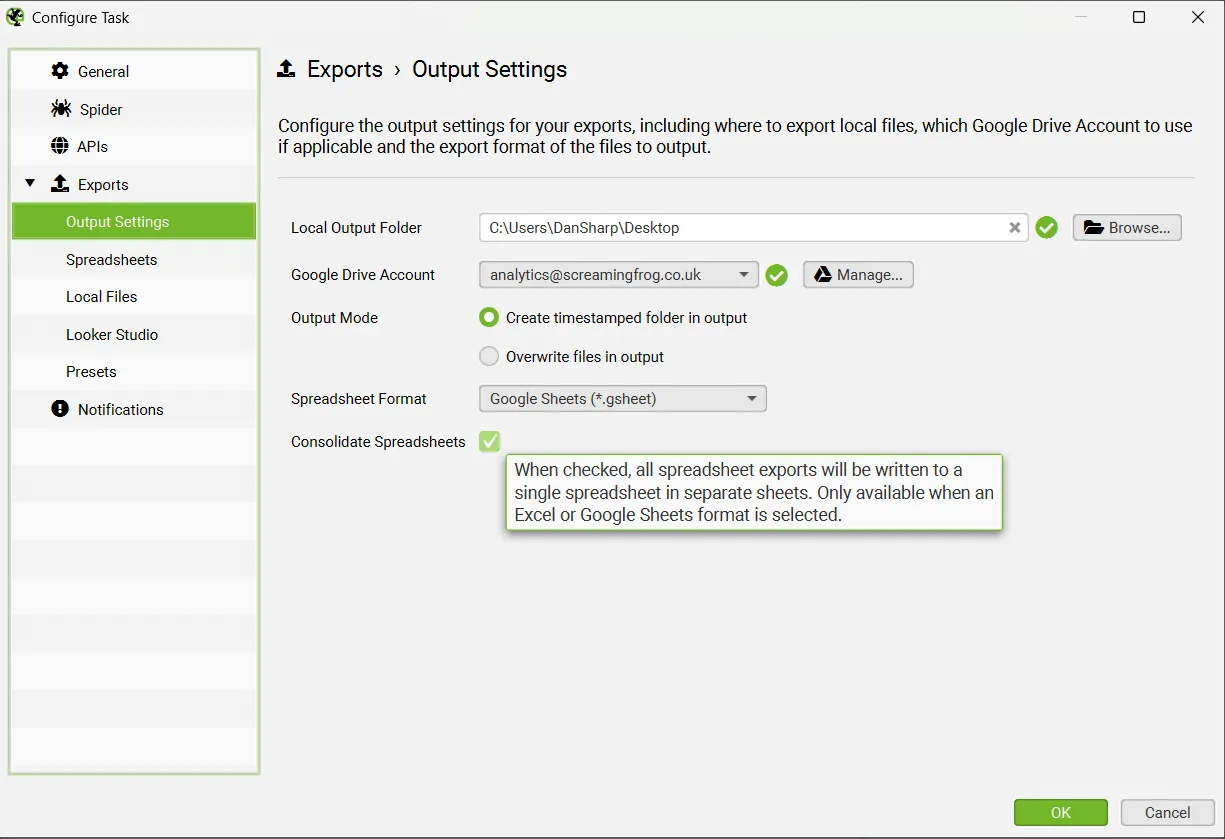
Pour les exports multiples, manuels ou planifiés, tu peux maintenant cocher « Consolidate Spreadsheets ».
Au lieu d’exporter chaque onglet, export en masse ou rapport dans un fichier séparé, tout est exporté dans des feuilles distinctes d’une même Google Sheet ou d’un même classeur.
Cette option est disponible pour Google Sheets et pour Excel.
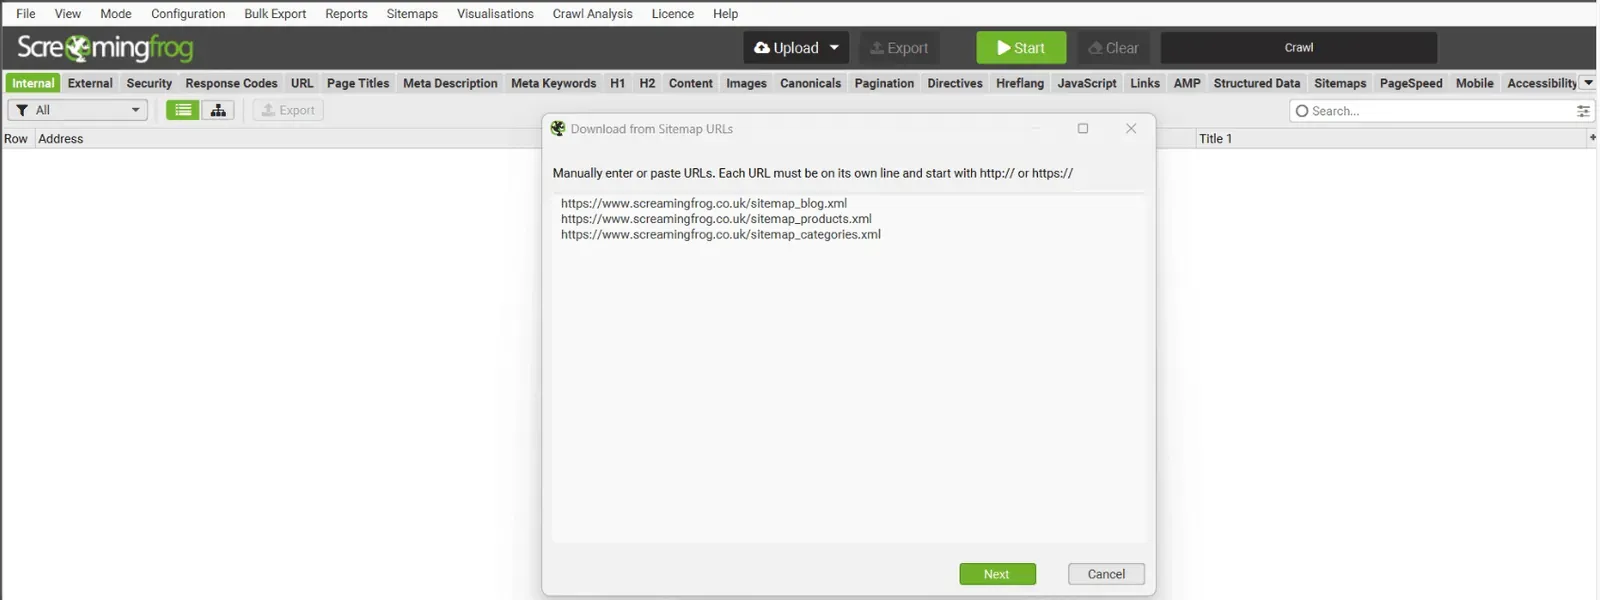
Analyse de plusieurs sitemaps
En mode List, tu peux désormais charger plusieurs sitemaps XML au lieu de passer par un fichier d’index de sitemaps, pour une analyse bien plus légère et précise.
Google Sheets comme source
En mode List, tu peux choisir comme source l’adresse d’une Google Sheet. Toutes les URL de la feuille seront chargées et crawlées.
Tu peux saisir tes informations Google Drive pour que SEO Spider accède aux Google Sheets privées.
Le potentiel d’automatisation est enthousiasmant : tu peux piloter les URL à crawler depuis Google Sheets (et ses modules complémentaires et Apps Script).
Cette fonction est aussi disponible dans la planification et la CLI.
Version 22 : conclusions
Avec la version 22.0 de Screaming Frog SEO Spider, l’analyse sémantique fondée sur les embeddings des LLM marque un tournant pour le SEO moderne. Cette mise à jour permet de :
- Dépasser la simple correspondance textuelle, avec des vecteurs sémantiques pour repérer les contenus dupliqués, redondants ou hors sujet.
- Visualiser les clusters thématiques et les pages atypiques.
- Renforcer des stratégies comme le maillage interne, le mapping des redirections, l’affinement sémantique des titles et bien plus.
- En coulisses, la recherche sémantique, la configuration IA avancée et les intégrations flexibles (Anthropic, OpenAI, Gemini, Ollama) rendent l’outil non seulement plus puissant, mais aussi plus intelligent et efficace.
🔧 Pourquoi mettre à jour maintenant ?
- Tu optimises le crawl budget en te concentrant sur les contenus stratégiques.
- Tu renforces la cohérence thématique du site en supprimant le bruit sémantique et en gagnant en pertinence.
- Tu automatises audits et migrations en appliquant la sémantique aux titles, redirections et pages.
- Tu investis dans l’avenir avec des fonctions alignées sur la logique des moteurs modernes (SERP vectorielles).
En somme, cette version fait passer Screaming Frog d’outil de crawl technique à véritable hub de SEO sémantique, parfaitement dans l’air du temps du search marketing !
Des questions sur Mise à jour Screaming Frog SEO Spider – version 22.0?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
