Actualización de Screaming Frog SEO Spider – versión 22.0.
Descubre cómo usar el análisis semántico de Screaming Frog para encontrar contenidos similares y páginas fuera de tema y mejorar el enlazado y las redirecciones en clave SEO.
Índice de la guía 11 secciones
●Brief01.Screaming Frog – versión 2202.Análisis de similitud semánticaLas novedades de la versión 22 de SEO Spider ("knee-deep"): análisis de similitud semántica con embeddings, contenido poco relevante, búsqueda semántica, nuevas integraciones de IA (también Anthropic) y nuevas opciones de exportación.
Screaming Frog – versión 22
Acaba de publicarse la versión 22.0 de Screaming Frog SEO Spider, llamada «knee-deep».
Una auténtica revolución para SEO Spider, que una vez más nos sorprende con nuevas integraciones de IA y confirma su liderazgo entre las herramientas SEO más versátiles y eficaces del mundo.
Análisis de similitud semántica
Ahora puedes analizar la similitud semántica de las páginas de un rastreo para encontrar contenido duplicado, similar o potencialmente fuera de tema y poco relevante en un sitio.
Análisis de la similitud semántica de las páginas rastreadas
- Esta función va más allá de la simple comparación de texto que se usa para detectar contenido duplicado: aprovecha los embeddings generados por modelos de lenguaje (LLM), que capturan el significado de las palabras y sus relaciones semánticas.
Así podrás identificar páginas similares aunque usen frases distintas pero traten los mismos temas, generando contenido redundante, canibalizaciones o ineficiencias en el rastreo y la indexación.
Si no conoces el concepto de embedding, te recomiendo leer el artículo de Mike King «Vector Embeddings is All You Need». Ha inspirado a muchos SEO a experimentar y crear herramientas innovadoras basadas en estas tecnologías.
Gracias a la integración con los principales proveedores de IA (OpenAI, Gemini, Ollama), disponible en 1Configuration›2API Access, podrás obtener fácilmente los embeddings vectoriales de las páginas rastreadas.
El análisis de similitud semántica en las herramientas de rastreo (como Screaming Frog) es un giro estratégico para el SEO técnico y de contenidos, por varias razones clave:
1. Va más allá de la simple detección de contenido duplicado
Tradicionalmente, las herramientas SEO se basaban en la coincidencia literal del texto para identificar contenido duplicado. Pero este enfoque no capta los matices semánticos, que pueden bastar al usuario pero los buscadores podrían considerar «duplicados».
Con los embeddings de los LLM se analiza el significado del contenido, detectando similitudes conceptuales aunque la redacción sea distinta.
✅ Ejemplo: dos páginas que hablan del mismo producto con textos diferentes ahora se pueden identificar como solapadas, lo que facilita el análisis de las «canibalizaciones».
2. Ayuda a prevenir la canibalización de contenidos
Muchos sitios, sobre todo grandes e-commerce o portales editoriales, publican con el tiempo varios contenidos sobre el mismo tema. Esto provoca:
- Competencia interna en los resultados de búsqueda (canibalización)
- Confusión para Google al elegir qué página indexar
- Desperdicio del crawl budget
Con este análisis puedes:
- Detectar páginas temáticamente redundantes
- Consolidar contenidos similares en recursos más fuertes (p. ej. con redirecciones o fusiones)
- Mejorar la claridad de la arquitectura de la información
3. Apoya la auditoría SEO con información de alto nivel
El análisis semántico permite:
- Mapear temas solapados a gran escala
- Analizar la distribución temática de las páginas
- Detectar clusters de contenido similar, incluso sin etiquetas ni categorización manual
Esto abre nuevas oportunidades estratégicas, como:
- Reestructurar un blog o una sección editorial
- Detectar huecos de contenido (topic gaps)
- Optimizar las relaciones internas con un enlazado temático más preciso
4. Lleva la IA de forma práctica al trabajo SEO
Muchos SEO hablan de IA, pero pocas herramientas la han integrado de forma útil. Esta función:
- Usa embeddings vectoriales reales, no coincidencia de palabras clave
- Aprovecha proveedores avanzados como OpenAI o Gemini
- Permite automatizar el análisis semántico a gran escala, algo que a mano llevaría horas o días
Es una función fundamental para quien quiera hacer optimización de contenido avanzada, sobre todo en sitios medianos o grandes o con un largo historial editorial.
Veamos cómo configurar Screaming Frog para aprovechar esta nueva función.
Lo primero es usar la integración de IA de SEO Spider para vectorizar las páginas.
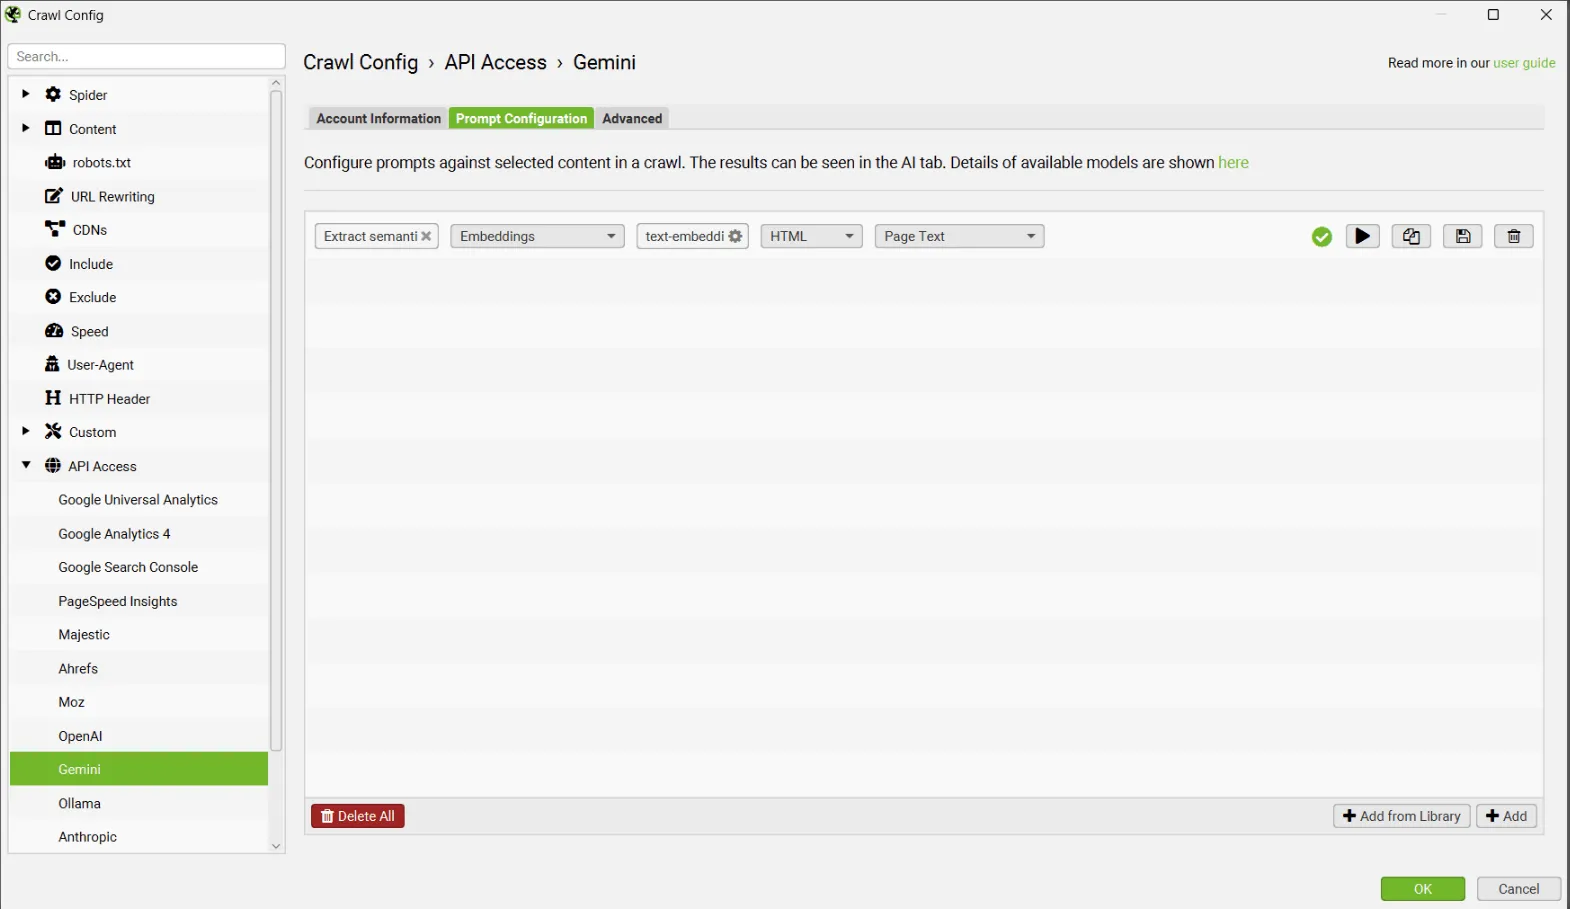
Ahora ya puedes activar el análisis semántico en SEO Spider desde 1Configuration›2Content›3Embeddings para el análisis semántico de contenidos, la búsqueda semántica y las visualizaciones.
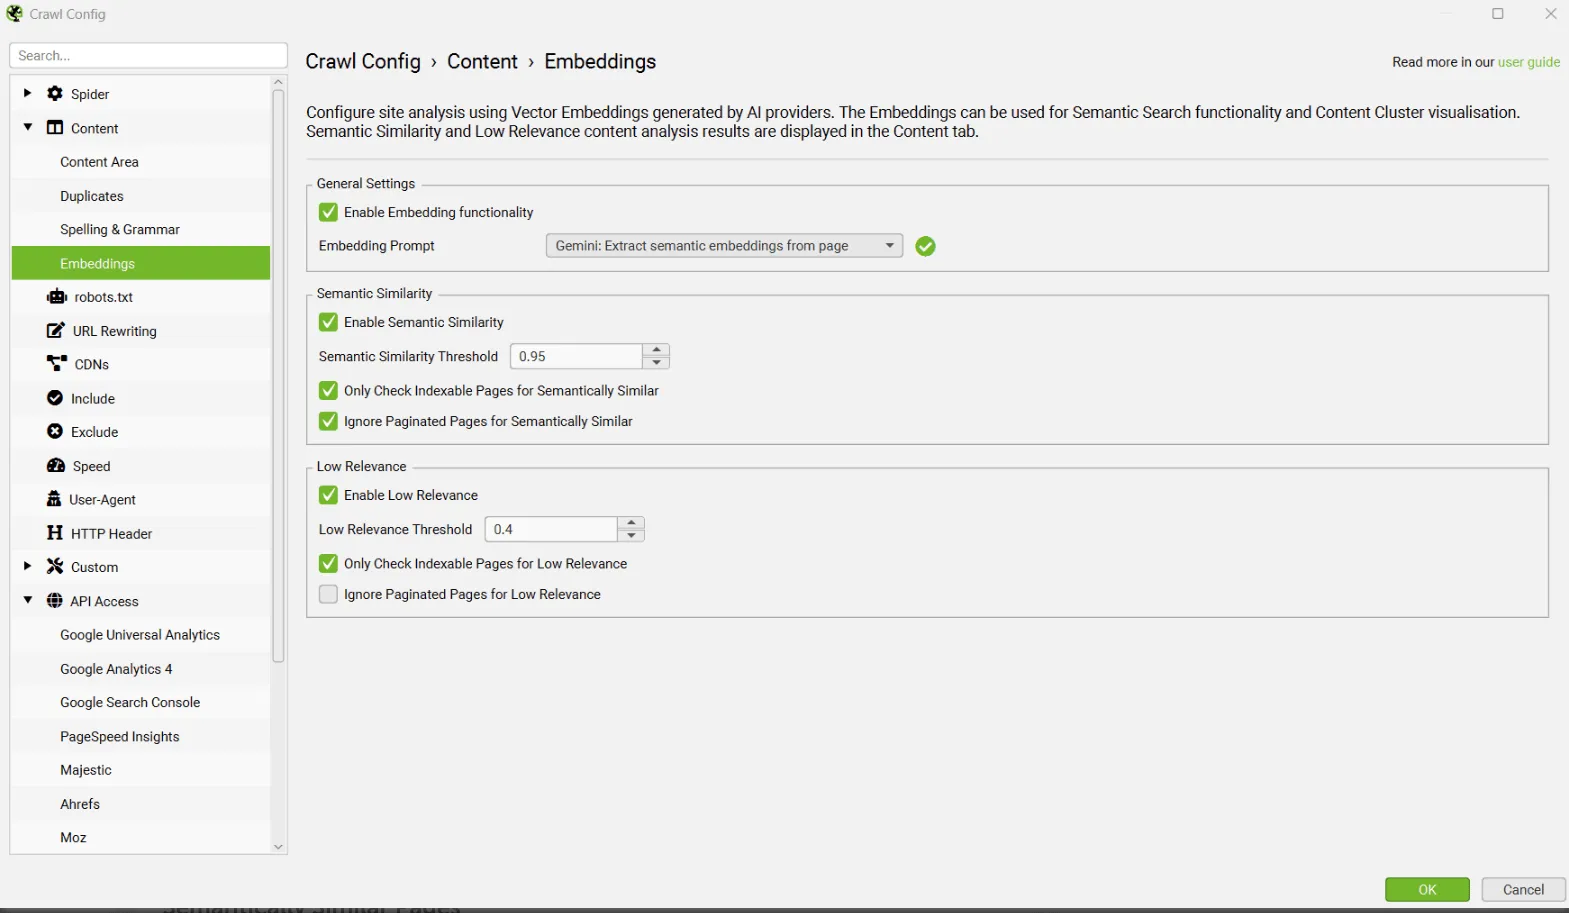
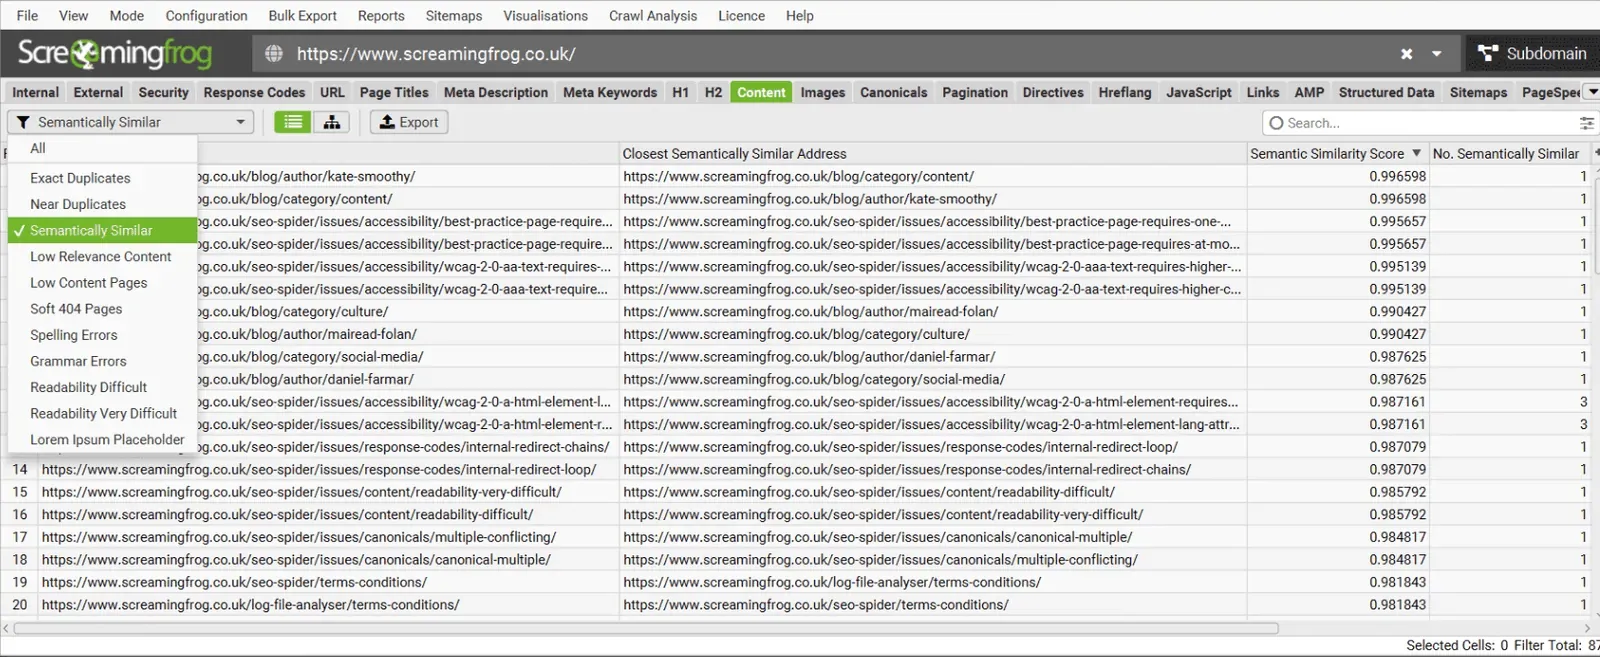
Cuando termine el rastreo y se haya ejecutado la Crawl Analysis, tendrás disponibles los filtros «Semantically Similar» y «Low Relevance Content» en la pestaña Content.
Páginas semánticamente similares
En la pestaña Content puedes filtrar por «Semantically Similar». Los resultados muestran para cada URL la dirección semánticamente más parecida, una puntuación de similitud semántica y el número de URL semánticamente similares.
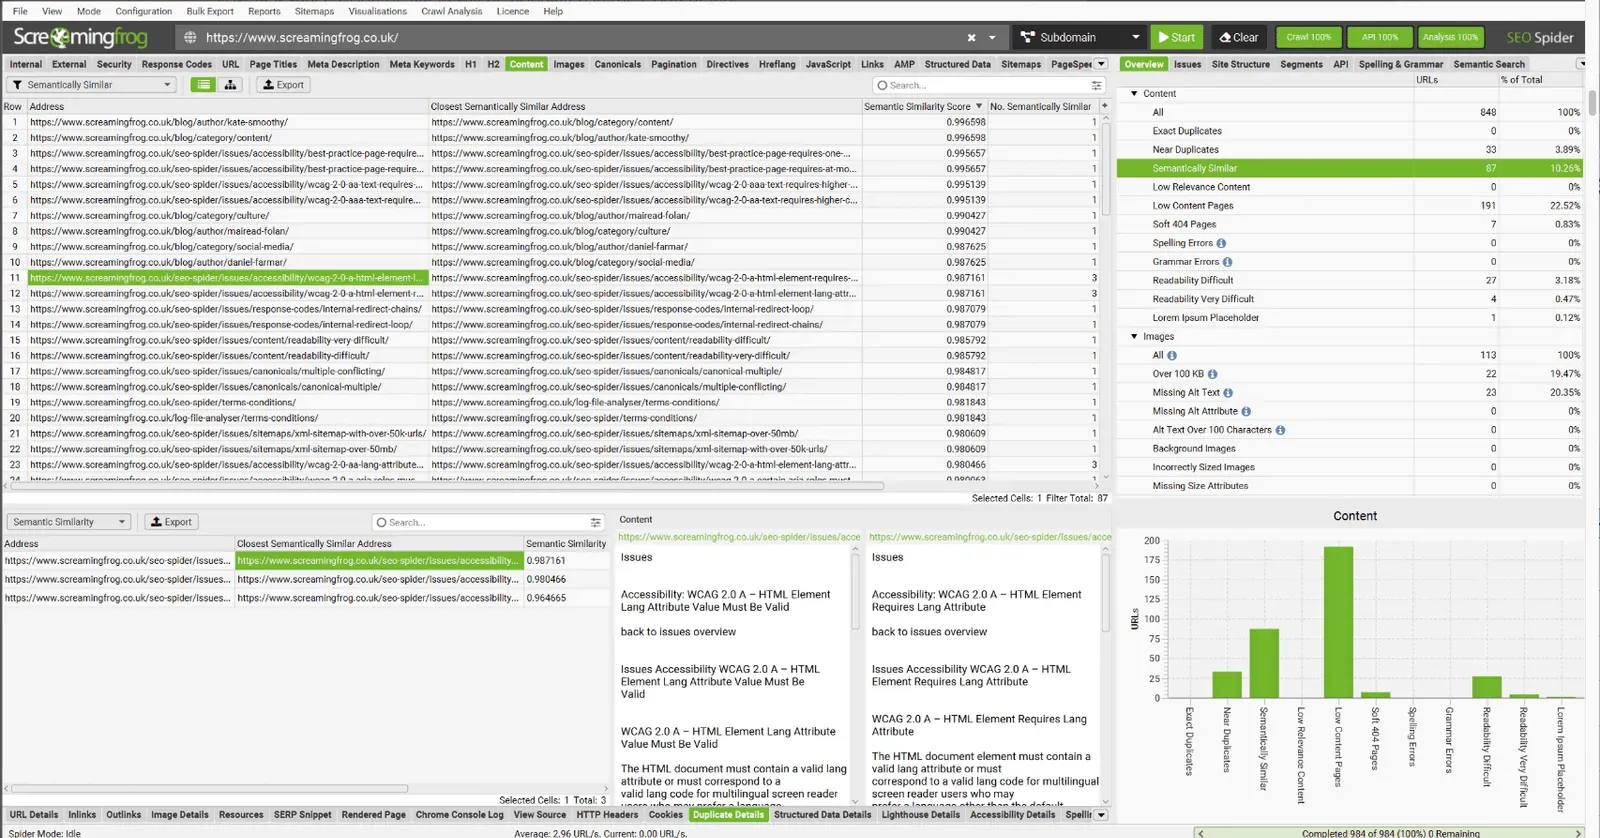
En la parte inferior de SEO Spider, la pestaña «Duplicate Details» y el filtro «Semantic Similarity» muestran todas las URL semánticamente similares y el contenido analizado.
SEO Spider asigna una puntuación de similitud semántica entre 0 y 1.
Cuanto más alta es la puntuación, más se parece la página a la dirección semánticamente más cercana.
Por defecto, las páginas con más de 0,95 se consideran semánticamente similares.
Para un análisis más fino y personalizado, puedes bajar el umbral de similitud hasta 0,5 en 1Configuration›2Content›3Embeddings.
Contenido poco relevante
Los embeddings vectoriales (representaciones numéricas del significado de un texto) no solo sirven para encontrar contenido similar, sino también para detectar páginas potencialmente fuera de tema respecto al enfoque general del sitio (el «centroide»).
Medir cuánto se aleja el embedding de una página del embedding de todo el sitio es una idea que también se mencionó en la reciente filtración de Google. Algunos SEO experimentan con ella para detectar contenido «anómalo» o fuera de contexto.
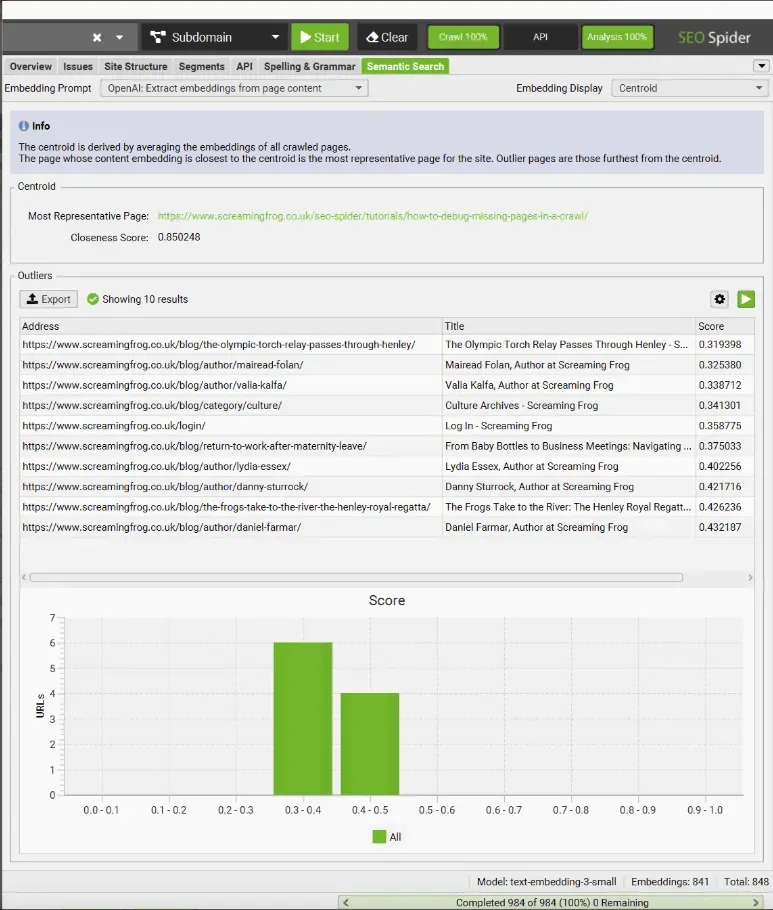
Los valores atípicos (incoherentes con el sitio) son los más alejados de la media y pueden indicar baja relevancia: un contenido «más fuera de tema» que el resto del sitio.
Las páginas por debajo del umbral se ven en la pestaña «Content», en el filtro «Low Relevance Content».
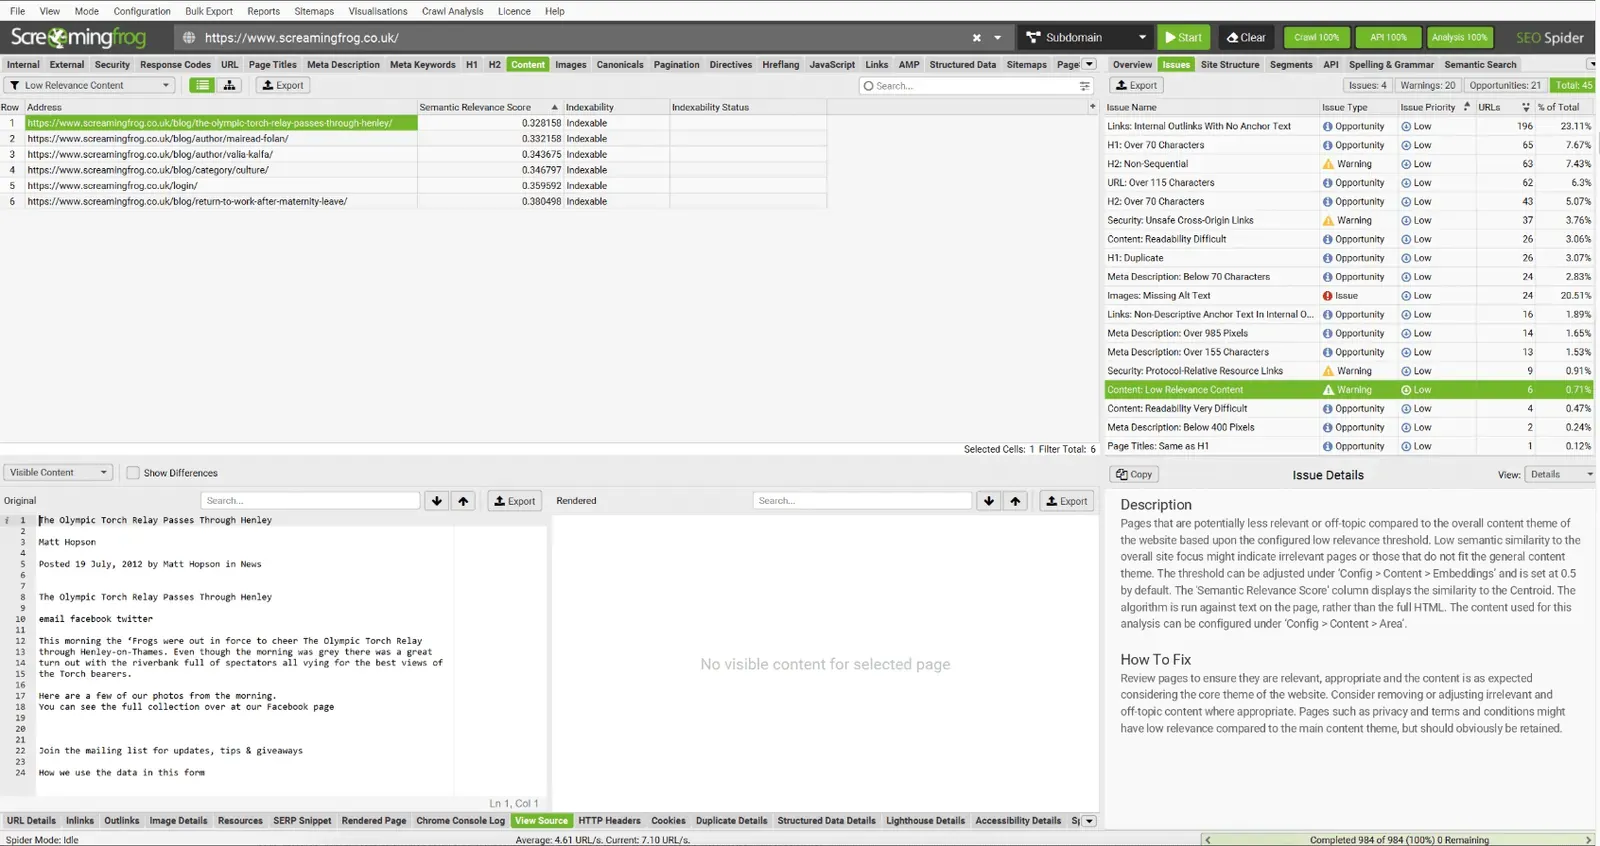
El análisis semántico lleva el SEO más allá de la coincidencia de palabras clave.
Permite razonar en términos de temas, significados y coherencia global, tanto para optimizar el sitio existente como para afrontar con más inteligencia migraciones, reestructuraciones o mejoras de contenido.
Esto es solo el principio: la evolución de estas herramientas dependerá de la creatividad con que las usen los SEO.
Contenido semántico con visualización de clusters
Una segunda función muy interesante de la versión 22 de Screaming Frog es el contenido semántico integrado en las visualizaciones de clusters.
El diagrama de clusters de contenido está en 1Visualisations›2Content Cluster Diagram. Es una visualización en dos dimensiones de las URL del rastreo, situadas y agrupadas según sus embeddings.
Sirve para detectar patrones y relaciones en los contenidos del sitio, con los contenidos semánticamente parecidos agrupados.
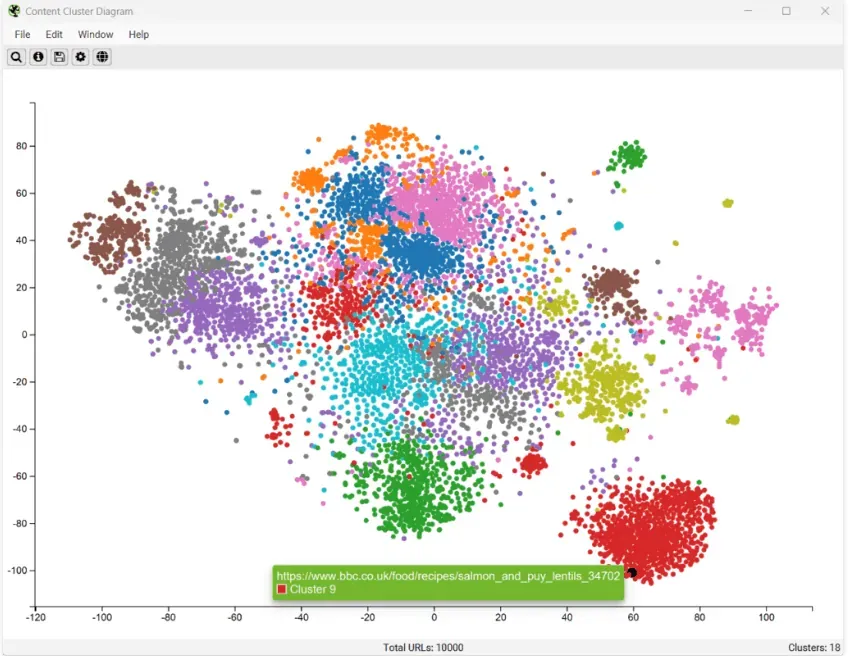
Los diagramas ayudan a ver el tamaño de los clusters de contenido de un sitio o a detectar posibles clusters temáticos semánticamente relacionados pero presentados de forma alejada para el usuario.
Búsqueda semántica
Desde la versión 22 de Screaming Frog hay una nueva pestaña «Semantic Search» en la barra lateral, que te permite introducir una consulta y ver las páginas más relevantes de un rastreo.
Esta función vectoriza la consulta y calcula la similitud del coseno entre la consulta y las páginas del rastreo, usando embeddings vectoriales en lugar de palabras clave.
Ayuda a cuantificar la relevancia de los contenidos frente a una consulta en todas las páginas de un rastreo, y se parece más a cómo los buscadores modernos y los LLM devuelven hoy los contenidos que la simple presencia y coincidencia de palabras clave en el texto (filtro Cosine Similarity Search).
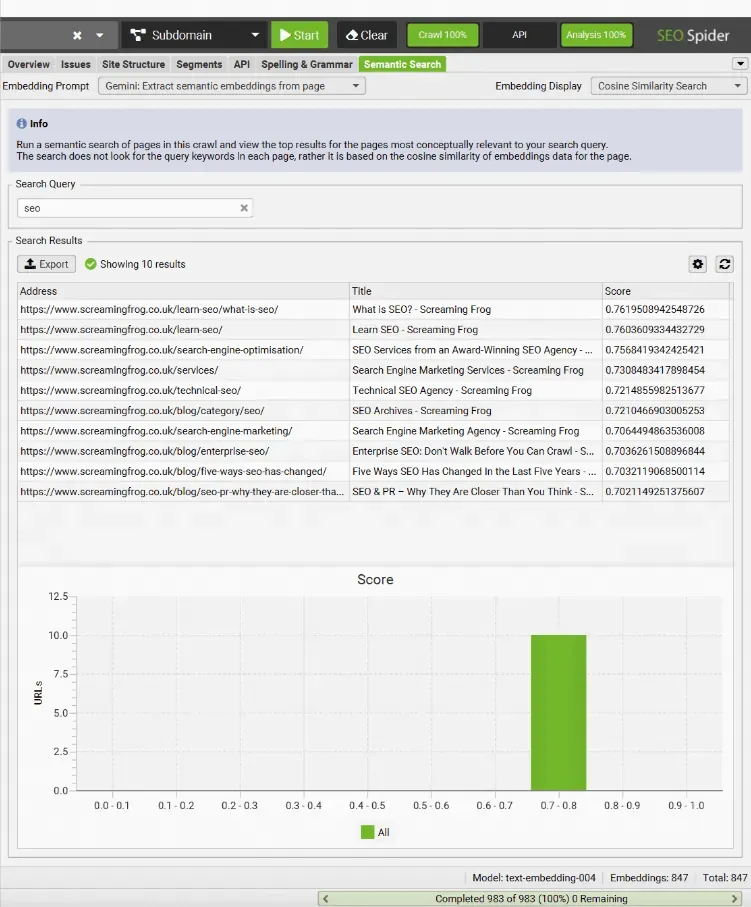
Esta función puede servir, por ejemplo, para encontrar páginas relevantes para el mapeo de palabras clave, páginas relacionadas para el enlazado interno o el análisis de la competencia por palabras clave.
El filtro «Embedding Display» se puede poner en ‘Centroid’ para ver más detalles de los valores atípicos del sitio y de la «página más representativa», la más cercana a la media de los embeddings de todo el sitio.
Mejoras en las integraciones de IA
SEO Spider también trae una serie de mejoras en la integración de IA para hacerla más avanzada y flexible y reducir el desperdicio de créditos y consultas.
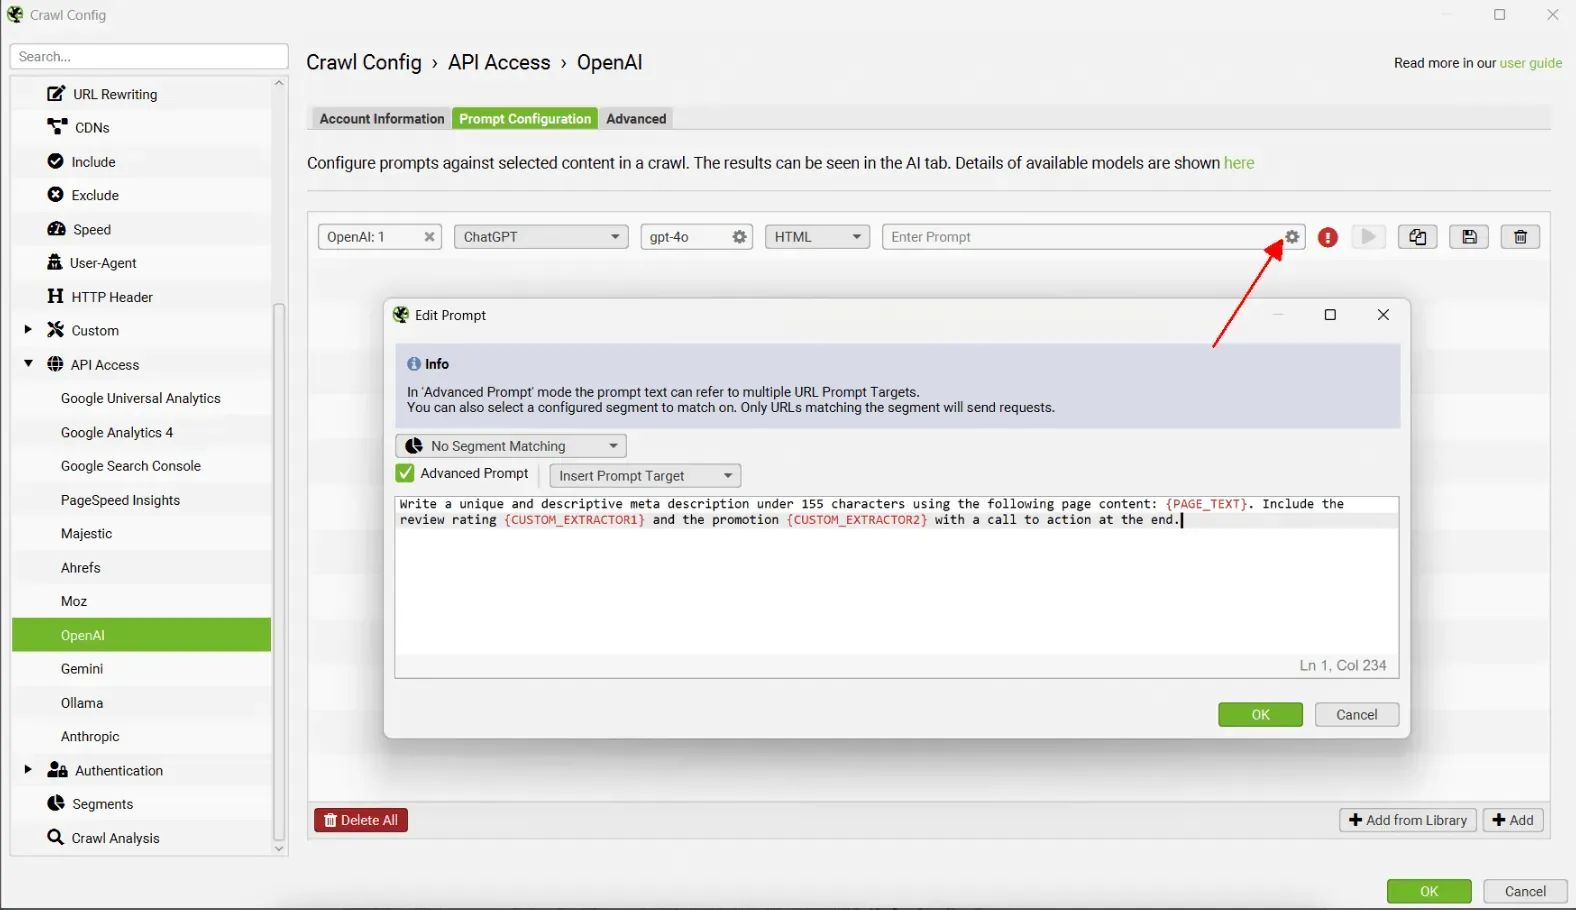
Varios objetivos de prompt
Ahora puedes hacer clic en el engranaje junto a un prompt y escribir un prompt más avanzado que incluya varios objetivos.
Prompts para segmentos y problemas concretos
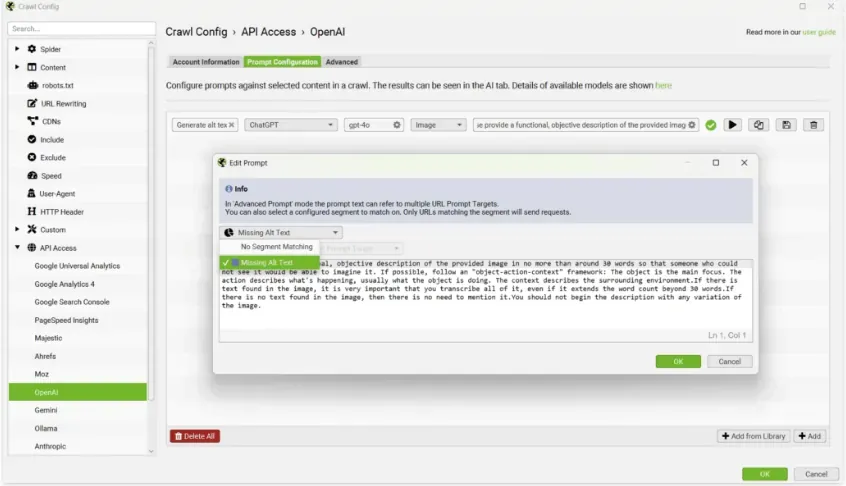
Puedes elegir ejecutar los prompts de IA solo en las URL que coincidan con un segmento concreto. Así puedes crear segmentos para los distintos casos en los que quieres que se ejecuten los prompts, sin desperdiciar créditos.
En el prompt avanzado puedes elegir «Match segment».
Esto te permite ahorrar créditos y gestionar mejor tu presupuesto de llamadas a la IA.
Por ejemplo, puedes generar el texto alternativo solo para las URL de imágenes del segmento con el problema «Missing Alt Text», en lugar de para todas las imágenes.
Endpoint personalizado
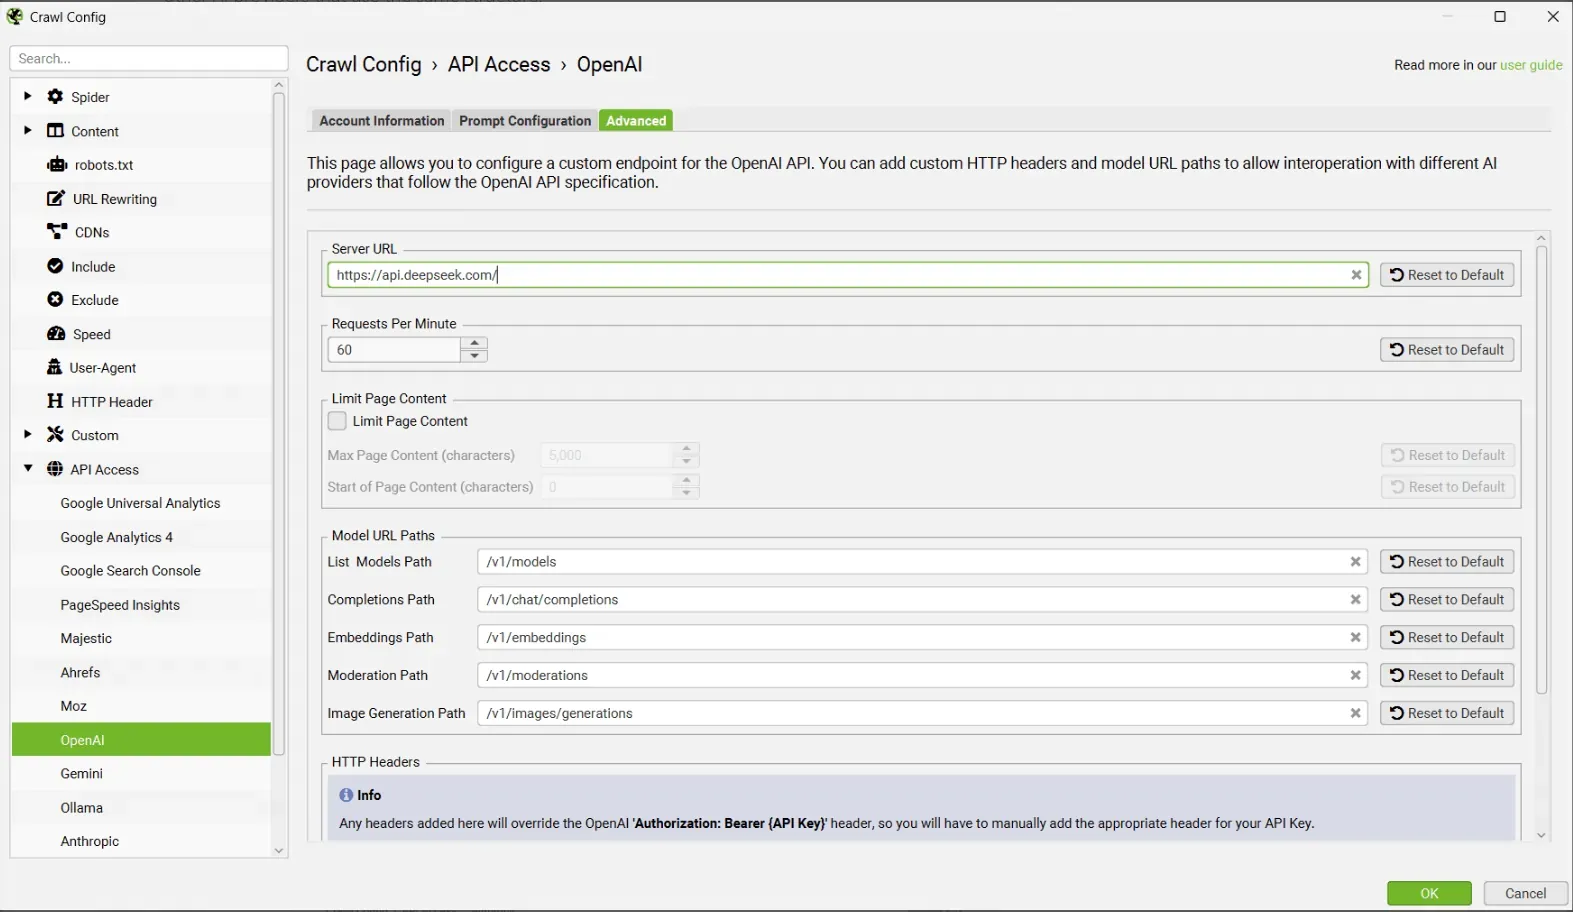
Ahora puedes personalizar el endpoint de OpenAI, lo que permite usar API de LLM privadas y otros proveedores de IA con la misma estructura.
Por ejemplo, puedes usar DeepSeek, Microsoft Copilot o Grok personalizando el endpoint y usando su clave API.
También puedes personalizar los parámetros del modelo y las cabeceras, y limitar la longitud del contenido de la página para reducir los errores por exceso de tokens en páginas largas.
Integración con Anthropic
Igual que con OpenAI, Gemini y Ollama, ahora puedes integrar Anthropic (alias «Claude») desde 1Configuration›2API Access para lanzar peticiones de IA durante el rastreo.
Configurador avanzado de columnas
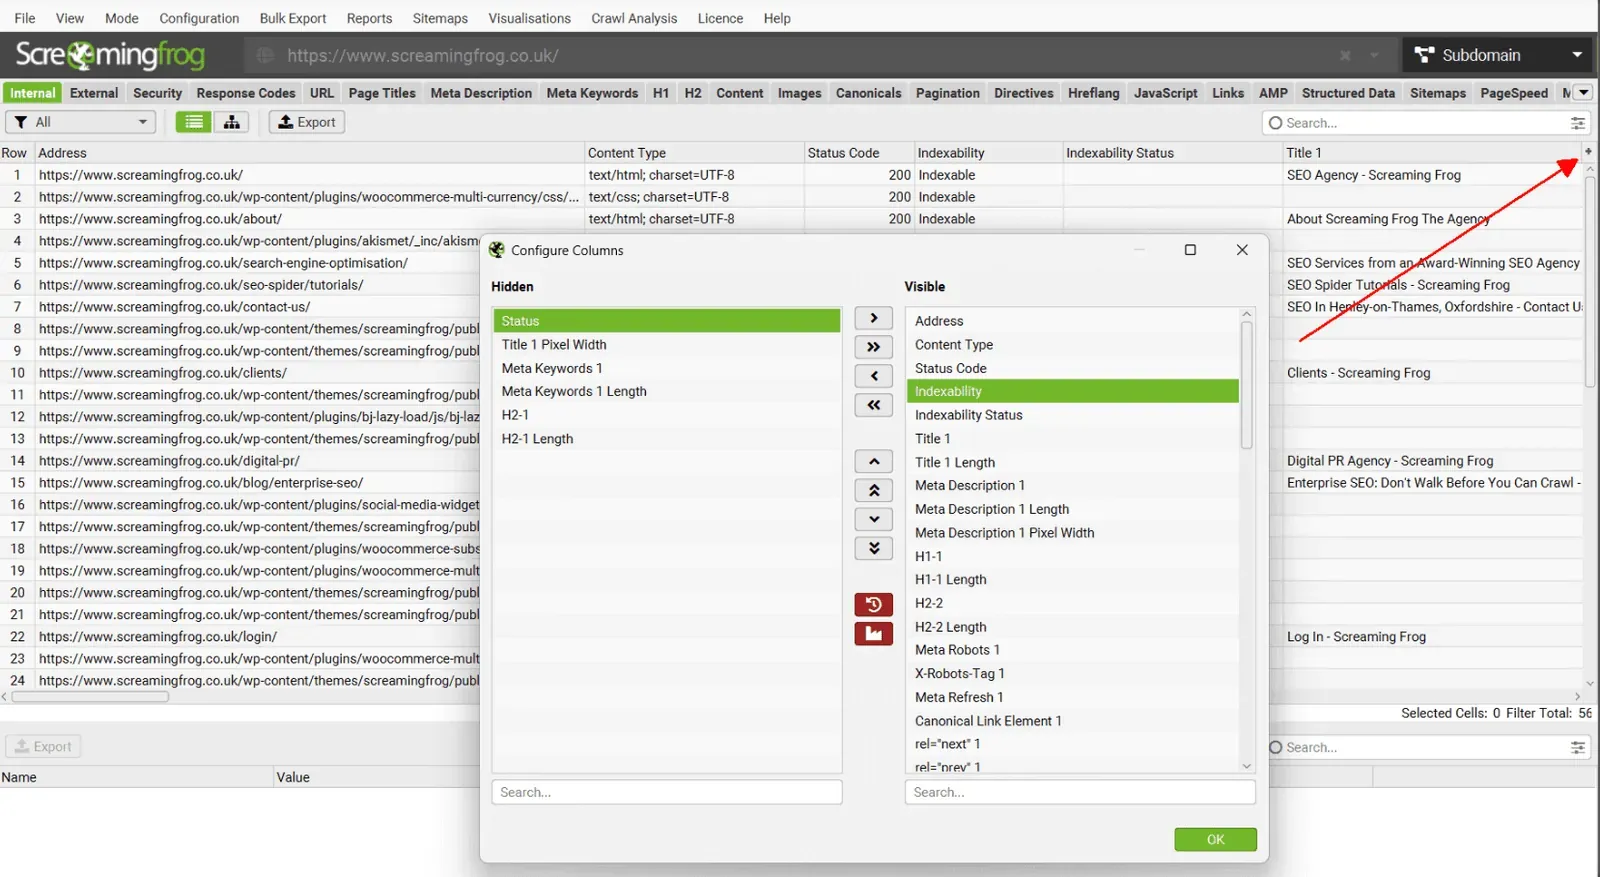
Igual que puedes personalizar las pestañas, ahora puedes configurar las columnas con un configurador avanzado que permite seleccionarlas, ocultarlas y reordenarlas en bloque. Junto con las funciones «detach», podrás organizar tu espacio de trabajo para tener siempre a la vista el foco de tu análisis.
Novedades en la exportación de datos
Multi-Export personalizado
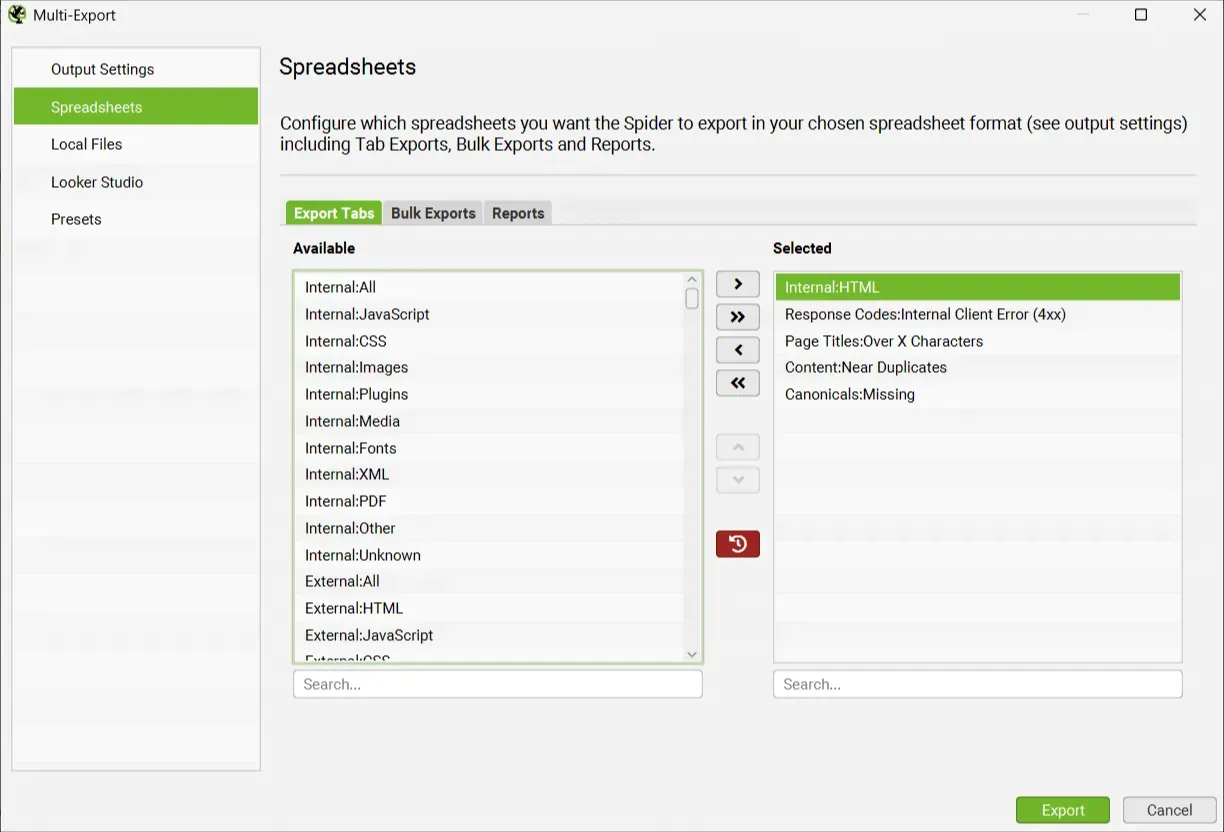
Hay una nueva opción «Multi-Export» en el menú «Bulk Export».
Permite seleccionar pestañas, exportaciones en bloque o informes que exportar con un solo clic.
Si usas un conjunto habitual de informes en tus rastreos, o quieres exportaciones concretas para algunos sitios, puedes guardarlos como preajustes y usarlos cuando quieras, a mano en la interfaz y también en la programación y en la CLI.
Esta novedad también permite lanzar Export for Looker Studio desde un rastreo manual, y no solo desde la programación.
Multi-Export en un único libro
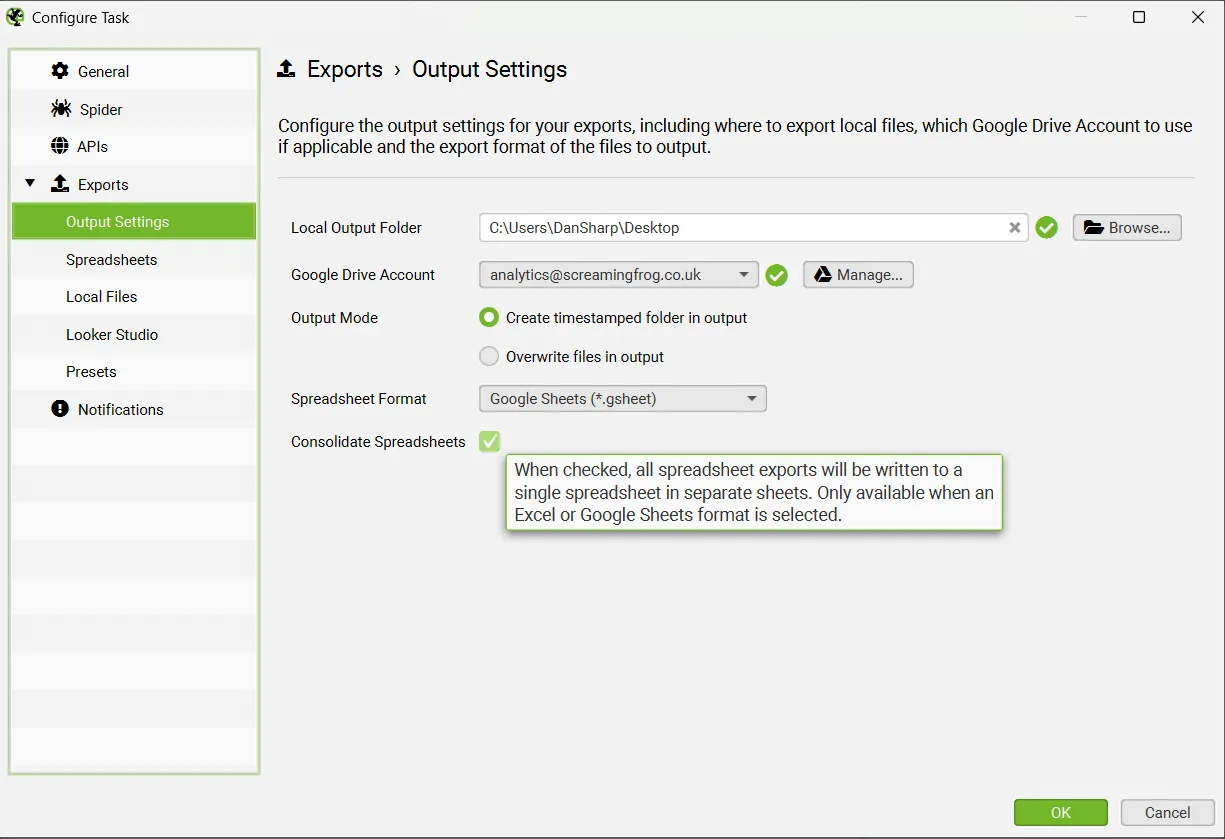
Al hacer varias exportaciones en bloque, a mano o con Scheduling, ahora puedes marcar «Consolidate Spreadsheets».
En lugar de exportar cada pestaña, exportación o informe en un archivo distinto, todo se exporta en hojas individuales dentro de la misma Google Sheet o del mismo libro.
Esta opción está disponible para Google Sheets y para Excel.
Análisis de varios sitemaps
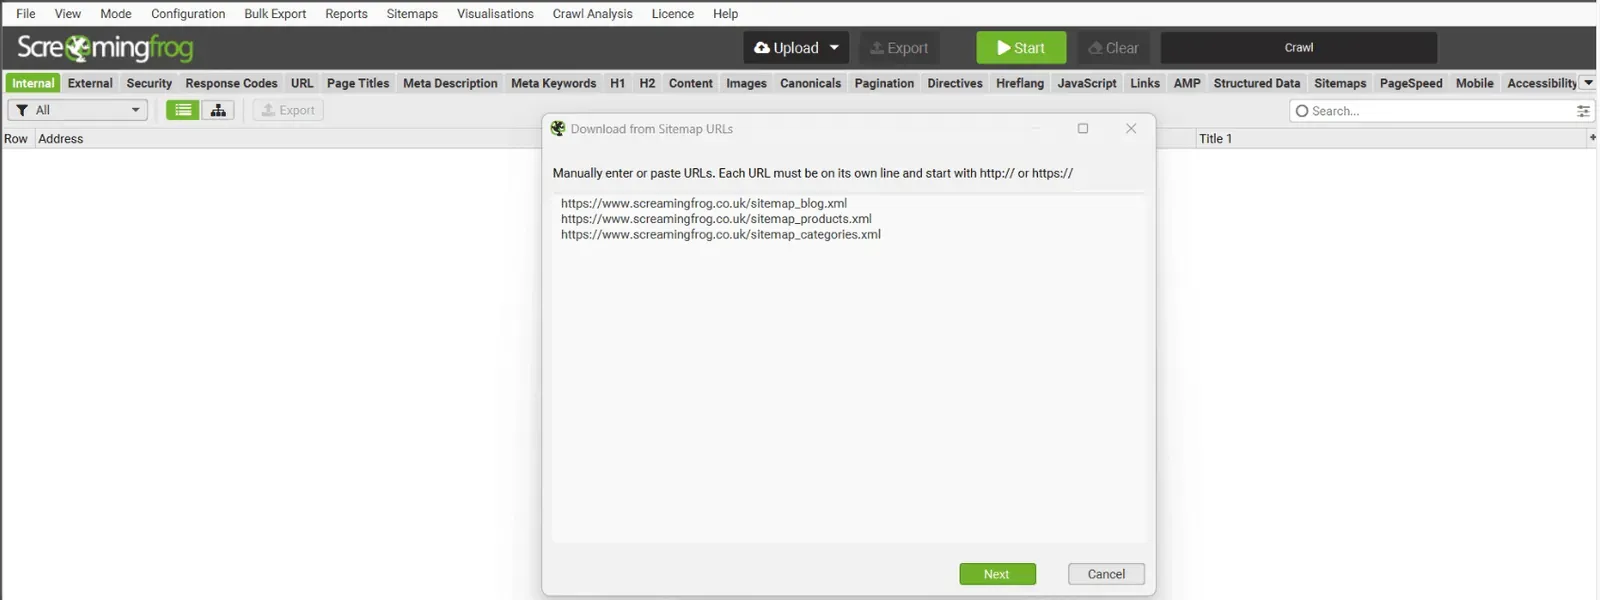
En modo List ahora puedes cargar varios sitemaps XML, en lugar de depender de un archivo de índice de sitemaps, lo que hace el análisis mucho más ágil y preciso.
Google Sheets como fuente
En modo List puedes elegir como fuente la dirección de una Google Sheet. Todas las URL de la hoja se cargarán y rastrearán.
Puedes introducir tus datos de Google Drive para que SEO Spider acceda a Google Sheets privadas.
Tiene un potencial de automatización emocionante, porque puedes decidir qué URL rastrear desde Google Sheets (y sus complementos y Apps Script).
Esta función también está disponible en la programación y en la CLI.
Versión 22: conclusiones
Con la versión 22.0 de Screaming Frog SEO Spider, el análisis semántico basado en los embeddings de los LLM marca un punto de inflexión para el SEO moderno. Esta actualización permite:
- Ir más allá de la simple coincidencia de texto, con vectores semánticos para detectar contenido duplicado, redundante o fuera de tema.
- Visualizar clusters temáticos y valores atípicos.
- Reforzar estrategias como el enlazado interno, el mapeo de redirecciones, el refinamiento semántico de los titles y mucho más.
- Entre bastidores, la búsqueda semántica, la configuración avanzada de IA y las integraciones flexibles (Anthropic, OpenAI, Gemini, Ollama) hacen que la herramienta no solo sea más potente, sino también más inteligente y eficiente.
🔧 ¿Por qué actualizar ahora?
- Optimizas el crawl budget centrándote en los contenidos estratégicos.
- Refuerzas el foco temático del sitio, eliminando ruido semántico y ganando relevancia.
- Automatizas auditorías y migraciones aplicando la semántica a titles, redirecciones y páginas.
- Inviertes en el futuro con funciones alineadas con la lógica de los buscadores modernos (SERP basadas en vectores).
En definitiva, esta versión convierte Screaming Frog de herramienta de rastreo técnico en un centro de SEO semántico, totalmente en línea con las tendencias del search marketing.
¿Dudas sobre Actualización de Screaming Frog SEO Spider – versión 22.0?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
