

Bloccato dal Robots.txt?.
Scopri come analizzare gli effetti delle direttive del robots.txt
Come scoprire quali URL e risorse sono bloccati dal robots.txt, un errore frequente nelle migrazioni. Usi il filtro Blocked by Robots.txt e la colonna Matched Robots.txt Line per risalire alla direttiva esatta che blocca il crawl.
Il robots.txt e la SEO
Il file robots.txt è cruciale per la SEO in quanto consente di indicare ai Motori di Ricerca quali pagine del sito devono essere escluse dall’indicizzazione, ottimizzando la visibilità dei contenuti più rilevanti. Una corretta configurazione del robots.txt può influenzare direttamente il posizionamento del sito nei risultati di ricerca, consentendo un migliore controllo sull’indicizzazione e sul crawling dei Motori di Ricerca. Tuttavia, un’impropria gestione di questo file potrebbe comportare l’esclusione accidentale di pagine importanti, compromettendo il posizionamento complessivo del sito. Questo scenario è molto frequente durante le migrazioni SEO: alla pubblicazione, il robots.txt dello staging resta ancora troppo spesso completamente chiuso e blocca in toto la scansione dello Spider.
User-agent: *
Disallow: /Analizzare il robots.txt con Screaming Frog
Configurare il robots.txt nel SEO Spider
Come abbiamo già visto con le nostre guide, Screaming Frog permette di verificare in modo certosino il robots.txt e testare i singoli percorsi direttamente dalla console, in 1Configuration›2robots.txt.
Da qui puoi rispettare il file (Respect robots.txt) o ignorarlo (Ignore robots.txt) durante il crawl, in base all’obiettivo dell’analisi, e scrivere un robots.txt personalizzato da usare nella scansione.
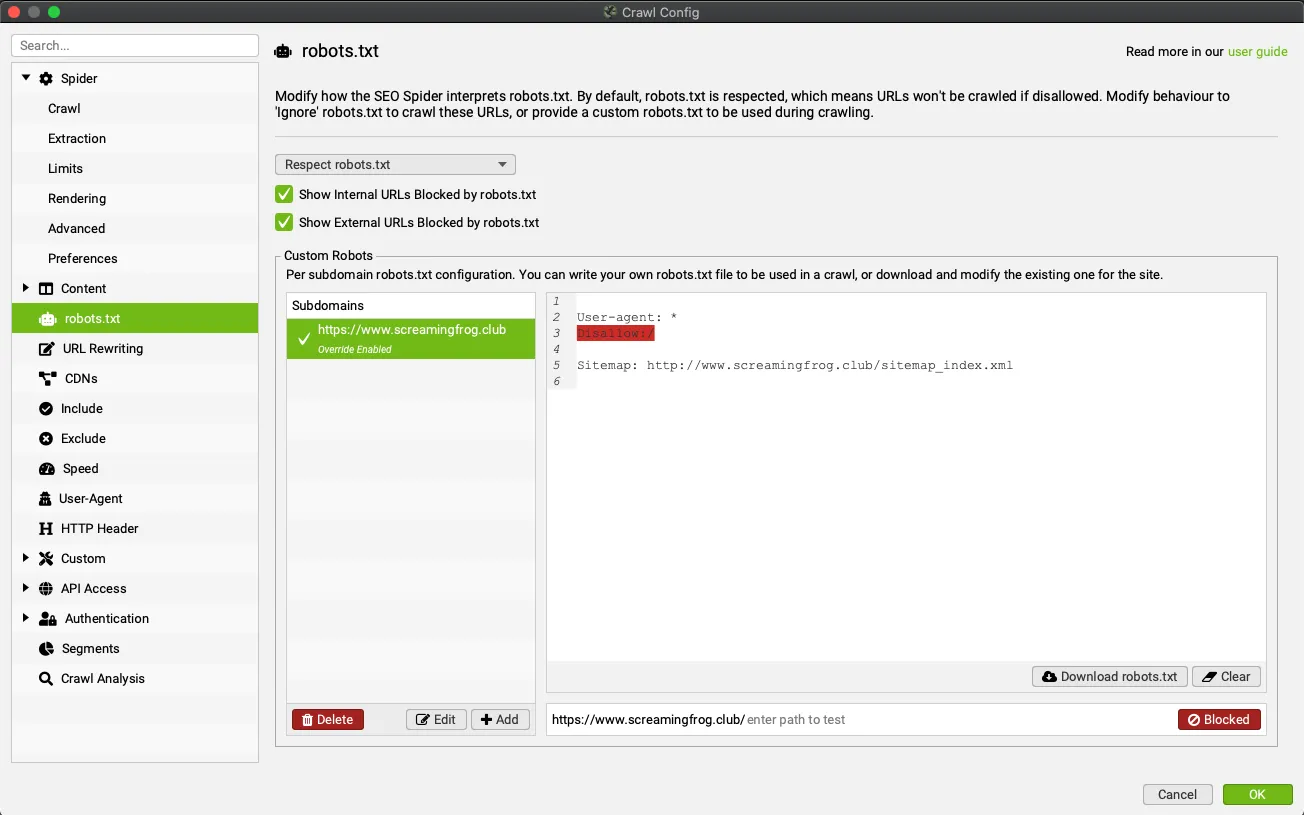
Con questa funzione puoi controllare singolarmente cartelle e percorsi, ma non fare un’analisi in blocco, e questo è molto riduttivo.
Il filtro Blocked by Robots.txt
Con il filtro Blocked by Robots.txt della tab 1Response Codes Screaming Frog mostra tutti gli URL bloccati dal file; con Export scarichi l’elenco per i tuoi controlli.
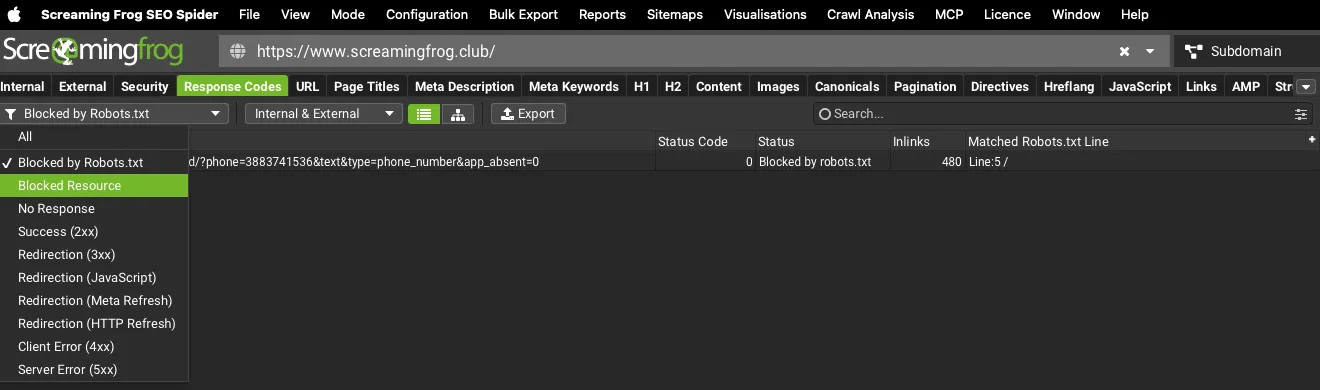
Probabilmente questo filtro lo conoscevi già, ma forse non hai mai considerato una delle colonne a disposizione: Matched Robots.txt Line.
La colonna Matched Robots.txt Line
Nell’analisi del file robots.txt se tutto è configurato correttamente, con il filtro precedente troverai solamente le risorse che realmente volevi bloccare, ma cosa succede se sono comprese pagine importanti che diversamente volevi indicizzare? Ma soprattutto come puoi districarti in un e-commerce da centinaia di migliaia di URL per trovare l’errore nel robots.txt?
In tuo aiuto c’è la colonna Matched Robots.txt Line, che per ogni URL indica la regola (la riga della direttiva nel file) che ne blocca la scansione.
Per una visione molto semplificata potrai cliccare sull’intestazione della colonna e ordinare tutto in base alla linea di riferimento cosicché anche nell’analisi di siti web o e-commerce di grandi dimensioni la risoluzione di eventuali configurazioni potrà essere estremamente semplificata.
ApprofondimentoTab Response Codes.Tutte le colonne e i filtri della tab dei codici di risposta: URL bloccati, redirect, errori 4xx e 5xx.Leggi la panoramica ApprofondimentoProblemi di scansione.Cosa fare quando SEO Spider scansiona una sola pagina o si blocca: robots.txt, DNS, timeout ed errori del server.Leggi la guidaHai domande su Bloccato dal Robots.txt?
Le guide nascono dai progetti di tutti i giorni. Se qualcosa non torna nel tuo crawl, o vuoi applicare questa procedura al tuo sito, scrivimi.
 Autore.Raffaele Visintin.Search & Strategic Marketing Advisor
