

Bloqué par le robots.txt ?.
Découvre comment analyser les effets des directives du robots.txt
Comment découvrir quelles URL et ressources sont bloquées par le robots.txt, une erreur fréquente lors des migrations. Utilise le filtre Blocked by Robots.txt et la colonne Matched Robots.txt Line pour remonter à la directive exacte qui bloque le crawl.
Le robots.txt et le SEO
Le fichier robots.txt est crucial pour le SEO car il indique aux moteurs de recherche quelles parties du site ne doivent pas être crawlées, pour concentrer leur attention sur les contenus les plus pertinents. Une bonne configuration du robots.txt peut influencer directement le positionnement du site, avec un meilleur contrôle sur le crawl et l’indexation. Une mauvaise gestion de ce fichier peut en revanche exclure par accident des pages importantes et compromettre le positionnement global du site. C’est très fréquent lors des migrations SEO : à la mise en ligne, le robots.txt de la préproduction reste encore trop souvent complètement fermé et bloque entièrement le crawl.
User-agent: *
Disallow: /Analyser le robots.txt avec Screaming Frog
Configurer le robots.txt dans SEO Spider
Comme nous l’avons vu dans nos guides, Screaming Frog permet de vérifier minutieusement le robots.txt et de tester chaque chemin directement depuis l’application, dans 1Configuration›2robots.txt.
De là, tu peux respecter le fichier (Respect robots.txt) ou l’ignorer (Ignore robots.txt) pendant le crawl, selon l’objectif de l’analyse, et écrire un robots.txt personnalisé à utiliser pour le crawl.
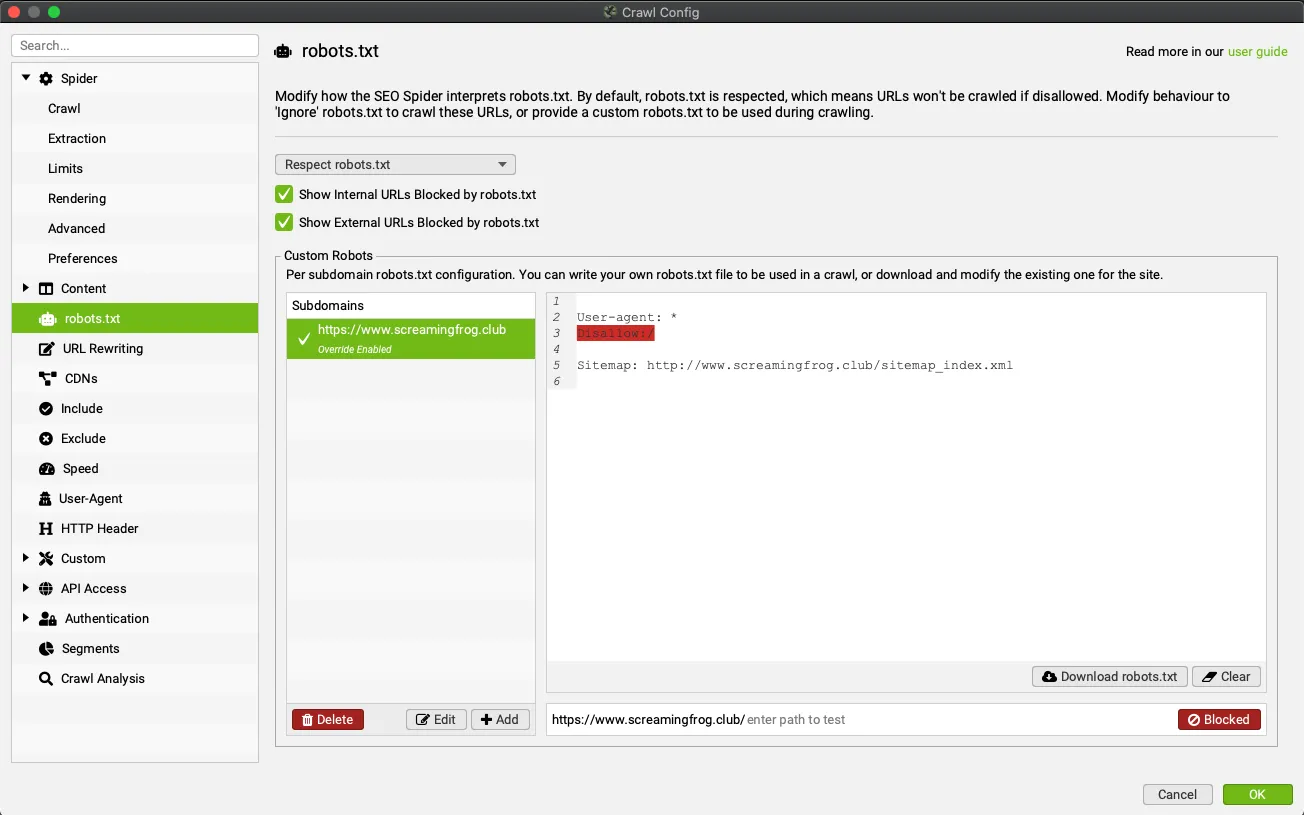
Cette fonction permet de contrôler les dossiers et les chemins un par un, mais pas en masse, ce qui est très limitant.
Le filtre Blocked by Robots.txt
Avec le filtre Blocked by Robots.txt de l’onglet 1Response Codes, Screaming Frog affiche toutes les URL bloquées par le fichier ; avec Export, tu télécharges la liste pour tes contrôles.
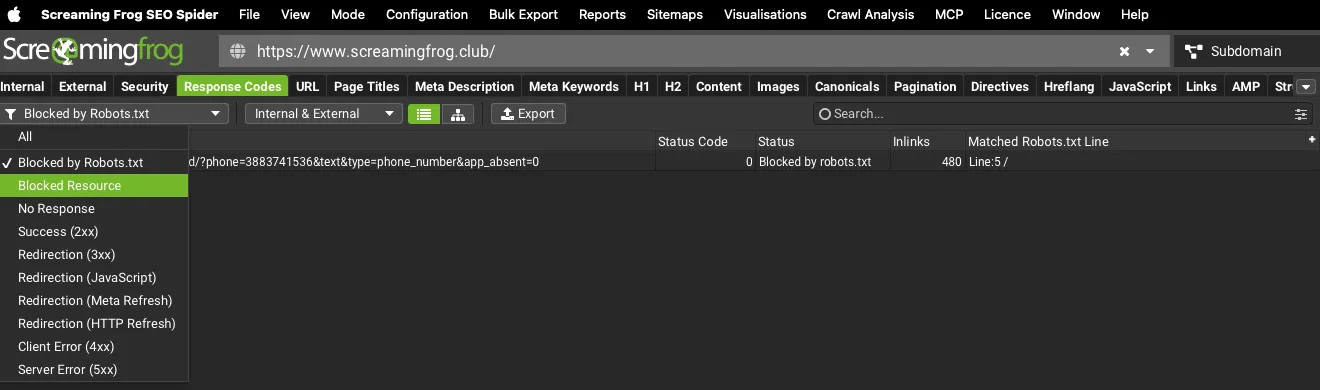
Tu connaissais sans doute déjà ce filtre, mais tu n’as peut-être jamais prêté attention à l’une de ses colonnes : Matched Robots.txt Line.
La colonne Matched Robots.txt Line
Si le robots.txt est bien configuré, le filtre précédent ne montrera que les ressources que tu voulais vraiment bloquer. Mais que se passe-t-il s’il contient des pages importantes que tu voulais indexer ? Et surtout, comment trouver l’erreur du robots.txt dans un e-commerce de plusieurs centaines de milliers d’URL ?
La colonne Matched Robots.txt Line vient à ton secours : pour chaque URL, elle indique la règle (la ligne de la directive dans le fichier) qui en bloque le crawl.
Pour une vue bien plus simple, clique sur l’en-tête de la colonne et trie tout selon la ligne concernée : même sur de grands sites ou e-commerce, corriger une mauvaise configuration devient beaucoup plus facile.
Pour aller plus loinOnglet Response Codes.Toutes les colonnes et tous les filtres de l’onglet des codes de réponse : URL bloquées, redirections, erreurs 4xx et 5xx.Lire la présentation Pour aller plus loinProblèmes de crawl.Que faire quand SEO Spider ne crawle qu’une seule page ou se bloque : robots.txt, DNS, délais d’attente et erreurs serveur.Lire le guideDes questions sur Bloqué par le robots.txt ?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
