

Analyse du contenu dupliqué.
Analyse et bonnes pratiques pour éviter le contenu dupliqué et ne pas perdre de positions dans les moteurs de recherche.
Comment trouver avec Screaming Frog les doublons exacts et les contenus quasi dupliqués qui risquent de cannibaliser les requêtes. Tu règles le seuil de similarité, lis les filtres de l’onglet Content et exportes en masse les URL à corriger.
Contenu dupliqué
Comme Google l’a déclaré à plusieurs reprises, le contenu est l’un des éléments les plus importants pour le classement, et la gestion des duplications fait partie des tâches à prévoir dans toute optimisation SEO.
Le contenu dupliqué est l’un des problèmes qui coupent le plus souvent les ailes d’un projet : il faut le réduire au minimum pour ne pas gaspiller le Crawl Budget.
L’objectif d’un spécialiste SEO ne doit pas se limiter à comprendre et optimiser les pages identiques : il faut aussi travailler sur les contenus « similaires » qui pourraient provoquer une « cannibalisation des requêtes » et rendre l’exploration du moteur totalement inefficace.
Dans ce tutoriel, on voit comment Screaming Frog permet de repérer à la fois les contenus dupliqués exacts (avec le même hash) et les contenus similaires qui pourraient sembler avoir la même « intention de recherche » aux yeux de Google.
-
- Activer ‘Near Duplicates’ via 1Configuration›2Content›3Duplicates.
Par défaut, Screaming Frog identifie automatiquement les pages en double exact (elles ont le même « Hash »), tandis que pour les contenus similaires tu dois activer l’option « Enable Near Duplicates ». Une fois activée, SEO Spider considère comme « similaire » tout document qui présente une correspondance d’au moins 90 %.
Tu peux aussi ajuster ce seuil selon ce qui convient le mieux à ton projet.
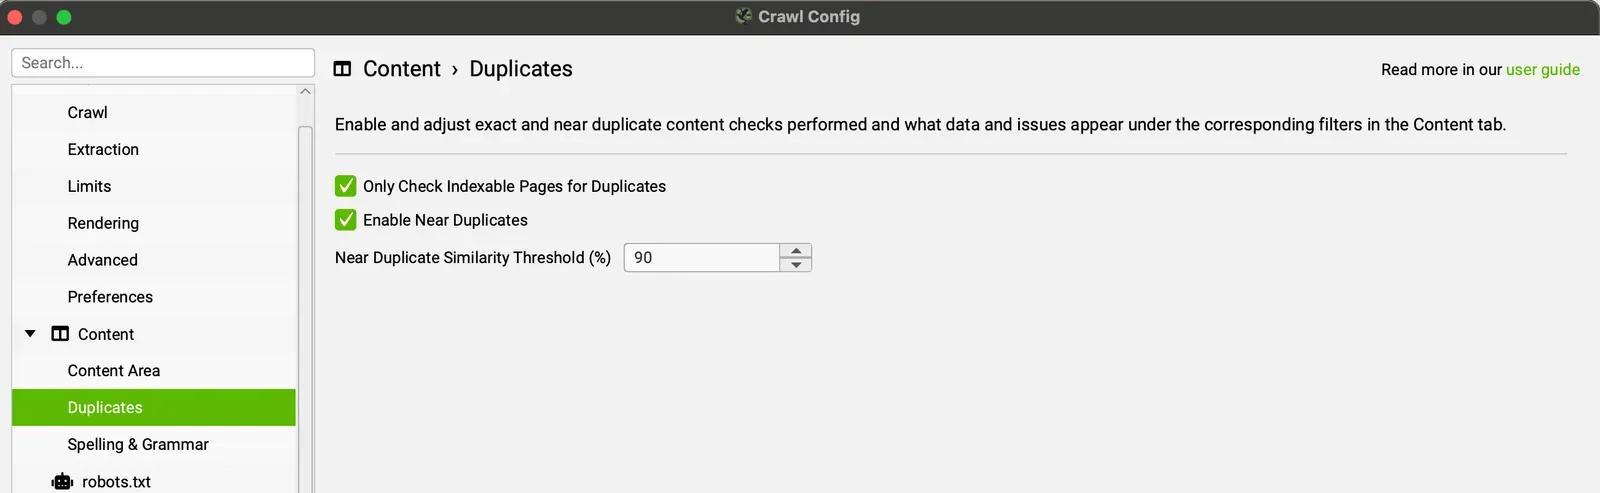
Par défaut, SEO Spider ne contrôle les pages similaires ou dupliquées que si elles sont « indexables » et non « canonicalisées » ; je te conseille de décocher l’option ‘Only Check Indexable Pages For Duplicates’, car cela peut t’aider à trouver des zones de gaspillage potentiel du Crawl Budget.
À noter : en général, pour les nouveaux projets où tu gères toute la recherche de mots-clés, je conseille un seuil de 50–60 %, et pour les projets avec un certain historique au moins 70 %, pour être sûr que l’intention de recherche soit toujours unique et bien marquée.
Avec la Search Console, tu peux contrôler régulièrement la relation requête–page d’atterrissage et, en cas de cannibalisation, choisir la page la plus adaptée à cette intention de recherche (en vérifiant aussi les données de GA), puis renouveler le contenu des pages secondaires ou, dans certains cas, les supprimer.
-
- Définir la zone de contenu à analyser
Pour cette tâche aussi, Screaming Frog est très flexible et te permet de choisir où porter ton attention dans la recherche de contenus dupliqués ou similaires.
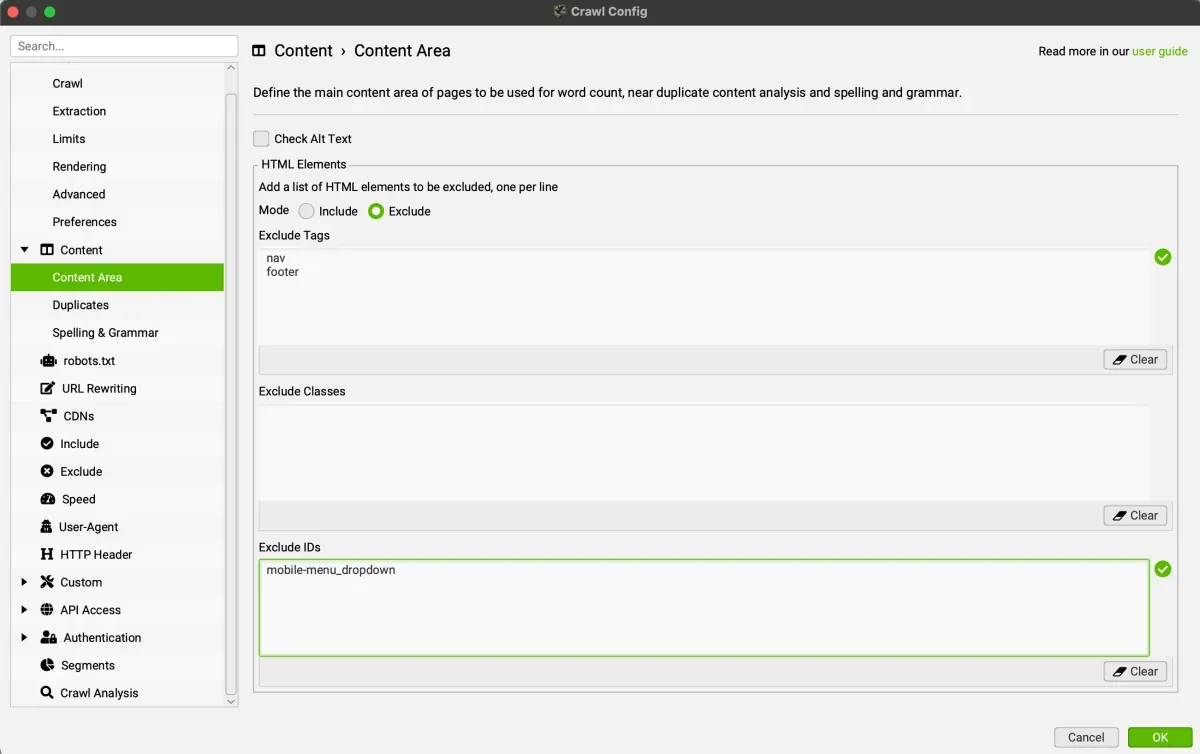
Par défaut, SEO Spider exclut automatiquement les éléments <nav> et
<footer> pour se concentrer sur le contenu principal. Mais tous les sites ne sont pas construits avec ces éléments HTML5 : SEO Spider te permet donc d’« inclure » ou d’« exclure » certains tags HTML, classes ou ID de l’analyse.
Par exemple, si tu crawles le site de Screaming Frog, tu remarqueras un menu mobile en dehors de l’élément « nav » qui, par défaut, est quand même inclus dans l’analyse du contenu. Dans ce cas, tu peux indiquer la classe du menu (‘mobile-menu__dropdown’) et l’exclure pour mieux te concentrer sur le contenu principal.
-
- Lance le crawl du site.
-
- Affiche les doublons dans l’onglet « Content »
L’onglet « Content » propose deux filtres :
- ‘exact duplicates’ (contenu identique).
- ‘near duplicates’ (contenu similaire).
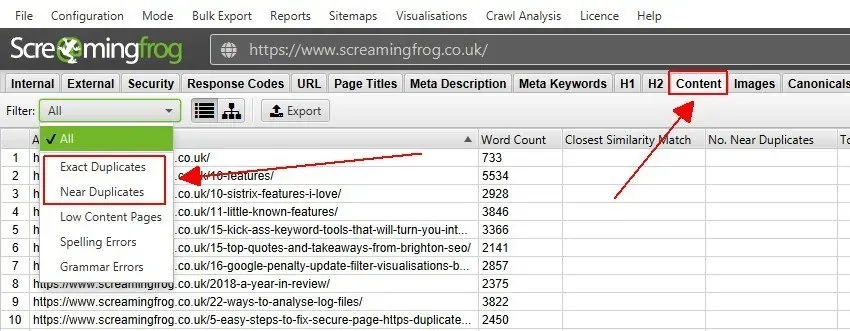
Pendant le crawl, cet onglet se remplit au fur et à mesure, mais n’affiche que les « doublons exacts ».
-
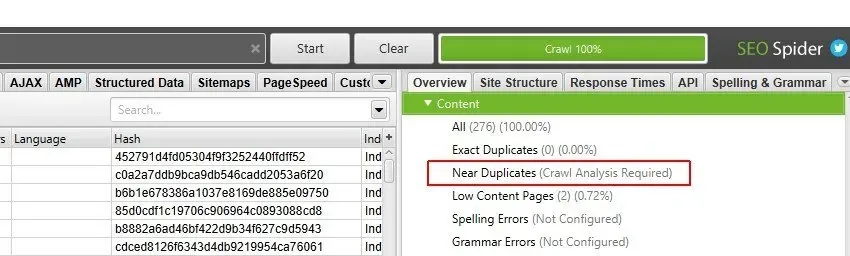
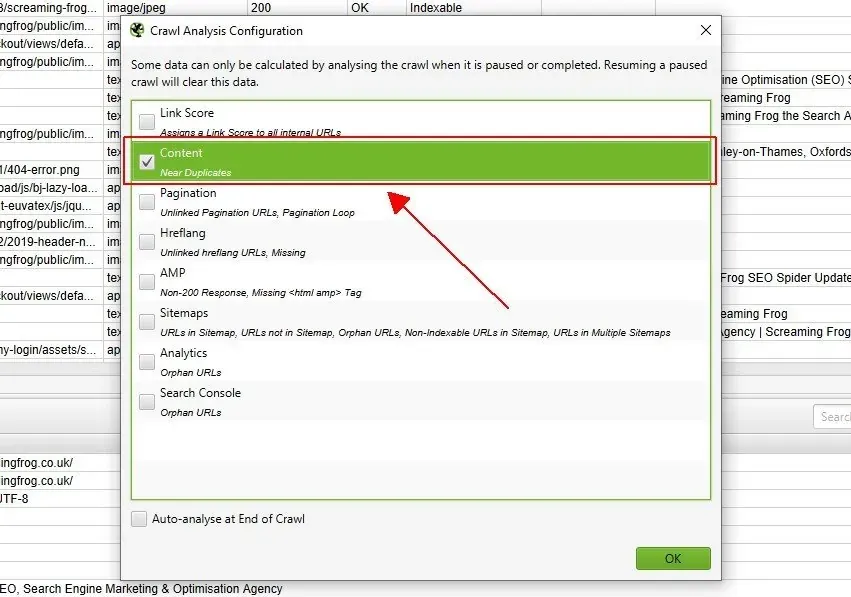
- Configurer la Crawl Analysis
Pour remplir le filtre ‘Near Duplicates’ et les colonnes « Closest Similarity Match » et « No. Near Duplicates », tu dois configurer et lancer la Crawl Analysis.
-
- Affiche l’onglet ‘Content’ et les filtres « Exact » et « Near »
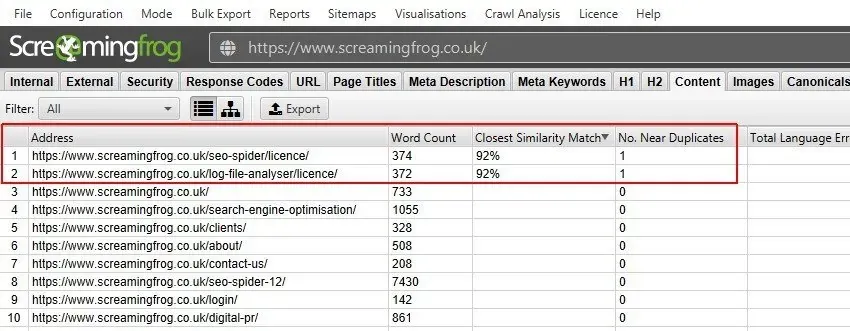
Après l’analyse post-crawl, le filtre « Near Duplicates » et les colonnes « Closest Similarity Match » et « No. Near Duplicates » sont remplis.
Seules les URL dont le contenu dépasse le seuil de similarité choisi contiennent des données ; les autres restent vides.
Dans le cas ci-dessous, le site de Screaming Frog ne présente que deux ressources à 92 % qu’il faudra optimiser.
Pour une évaluation plus précise, tu peux trier les données selon les deux filtres :
- Exact Duplicates : identifie les pages au « hash » identique.
Très utile pour gérer les pages principales et les pages à « canonicaliser ». - Near Duplicates : identifie les pages dont la « similarité » dépasse 90 %, ou un autre seuil si tu l’as modifié via « Config > Content > Duplicates ».
En résumé, la colonne « Closest Similarity Match » affiche le pourcentage de similarité et « No. Near Duplicates » le nombre de pages concernées.
-
- Afficher les URL dupliquées dans l’onglet ‘Duplicate Details’
Pour les « doublons exacts », il suffit d’aller sur la colonne « hash » et de la trier en cliquant sur l’en-tête pour trouver toutes les correspondances.
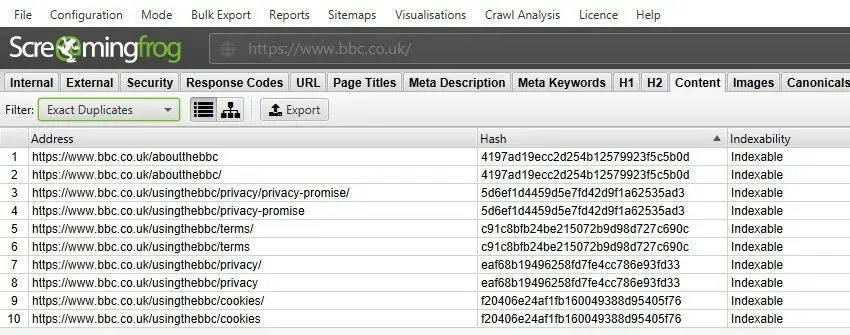
Dans l’exemple du site de la BBC, chaque URL a un doublon exact car elle existe en deux versions, une avec le « / » et une sans.
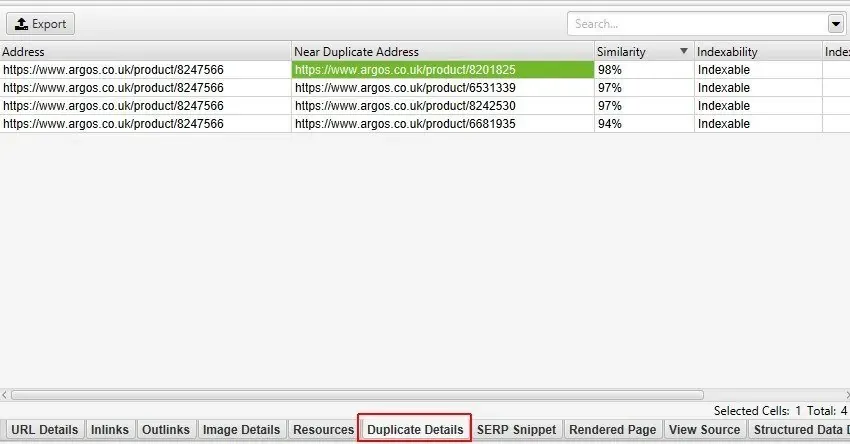
Pour trouver les « quasi-doublons (similaires) », il suffit de cliquer sur l’onglet « Duplicate Details » dans la fenêtre du bas.
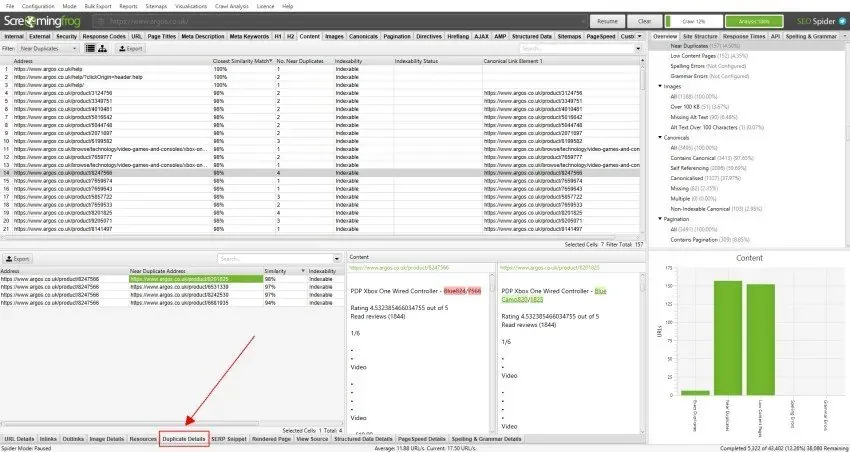
Dans le cas ci-dessus, en cliquant sur une URL de la fenêtre supérieure, on voit 4 pages qui dépassent le seuil de 90 % de similarité.
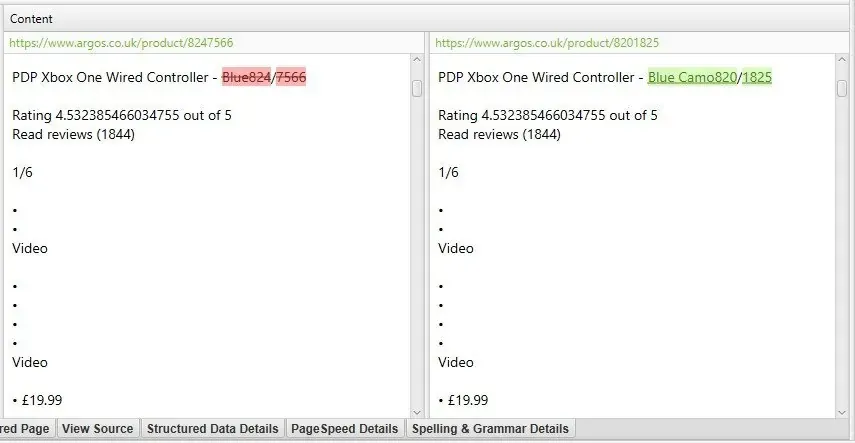
SEO Spider propose aussi un aperçu des contenus quasi dupliqués dans l’onglet « Duplicate Details », avec une vue très intuitive des parties de texte qui diffèrent entre les pages examinées.
-
- Export en masse des URL dupliquées
Les doublons exacts comme les quasi-doublons peuvent être exportés en masse.
1Bulk Export›2Content›3Exact Duplicates / Near Duplicates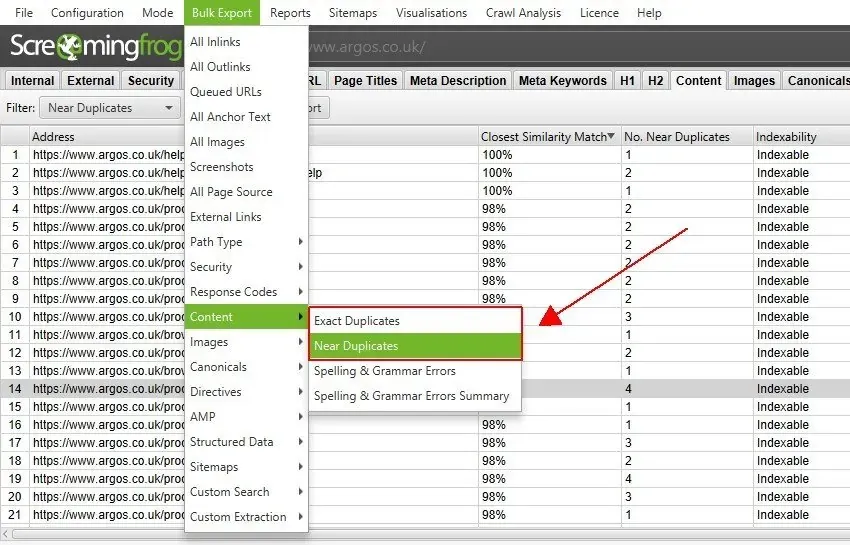
Onglets associés : Content | Barre latérale | Rapports
Vidéo sur l’analyse du contenu dupliqué (en italien)
Cannibalisation des requêtes (en italien)
Des questions sur Analyse du contenu dupliqué?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
