

Análisis de contenido duplicado.
Análisis y buenas prácticas para evitar el contenido duplicado y no perder posiciones en los buscadores.
Cómo encontrar con Screaming Frog tanto los duplicados exactos como los contenidos casi duplicados que pueden canibalizar las consultas. Configuras el umbral de similitud, lees los filtros de la pestaña Content y exportas en bloque las URL que corregir.
Contenido duplicado
Como Google ha dicho muchas veces, el contenido es uno de los elementos más importantes para el posicionamiento, y gestionar las duplicaciones es una de las tareas a tener en cuenta en cualquier optimización SEO.
El contenido duplicado es uno de los problemas que más a menudo le cortan las alas a un proyecto, y hay que reducirlo al mínimo para no malgastar el Crawl Budget.
El objetivo de un especialista SEO no debe limitarse a entender y optimizar las páginas idénticas: también debe trabajar los contenidos «similares» que podrían provocar «canibalización de consultas», volviendo totalmente ineficiente el rastreo del buscador.
En este tutorial vemos cómo Screaming Frog te permite encontrar tanto el contenido duplicado exacto (con el mismo hash) como contenidos similares que, a ojos de Google, podrían tener la misma «intención de búsqueda».
-
- Activar ‘Near Duplicates’ en 1Configuration›2Content›3Duplicates.
Por defecto, Screaming Frog identifica automáticamente las páginas duplicadas exactas (tienen el mismo «Hash»), mientras que para los contenidos similares debes activar la opción «Enable Near Duplicates». Una vez activada, SEO Spider considera «similar» todo documento con una coincidencia mínima del 90 %.
También puedes ajustar este umbral a lo que mejor encaje con tu proyecto.
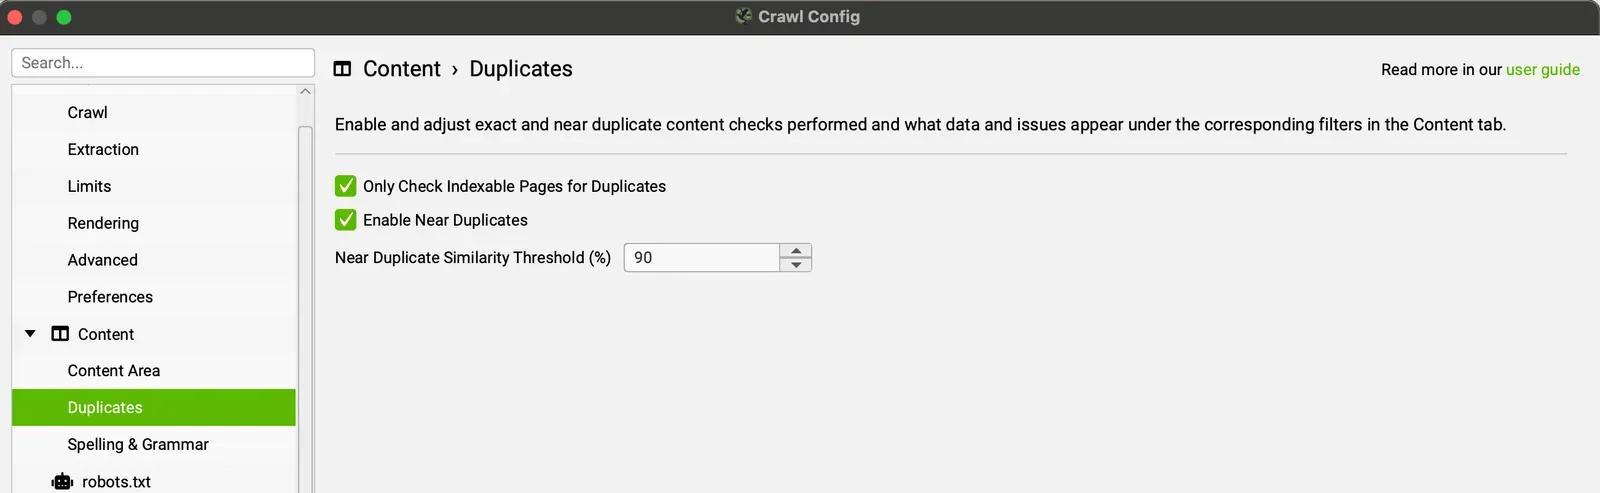
Por defecto, SEO Spider solo comprueba páginas similares o duplicadas si son «indexables» y no están «canonicalizadas»; te aconsejo desmarcar la opción ‘Only Check Indexable Pages For Duplicates’, porque puede ayudarte a encontrar zonas de posible desperdicio del Crawl Budget.
Nota: por norma, en proyectos nuevos en los que gestionas toda la investigación de palabras clave, te recomiendo un umbral del 50–60 %, y en proyectos con cierto historial un mínimo del 70 %, para asegurarte de que la intención de búsqueda sea siempre única y bien definida.
Con Search Console puedes revisar periódicamente la relación consulta–landing page y, en caso de canibalización, elegir la landing más adecuada para esa intención de búsqueda (comprobando también los datos de GA), y renovar el contenido de las páginas secundarias o, en algunos casos, eliminarlas.
-
- Definir el área de contenido que analizar
También en esta tarea Screaming Frog es muy flexible y te permite elegir dónde centrar la atención al buscar contenidos duplicados o similares.
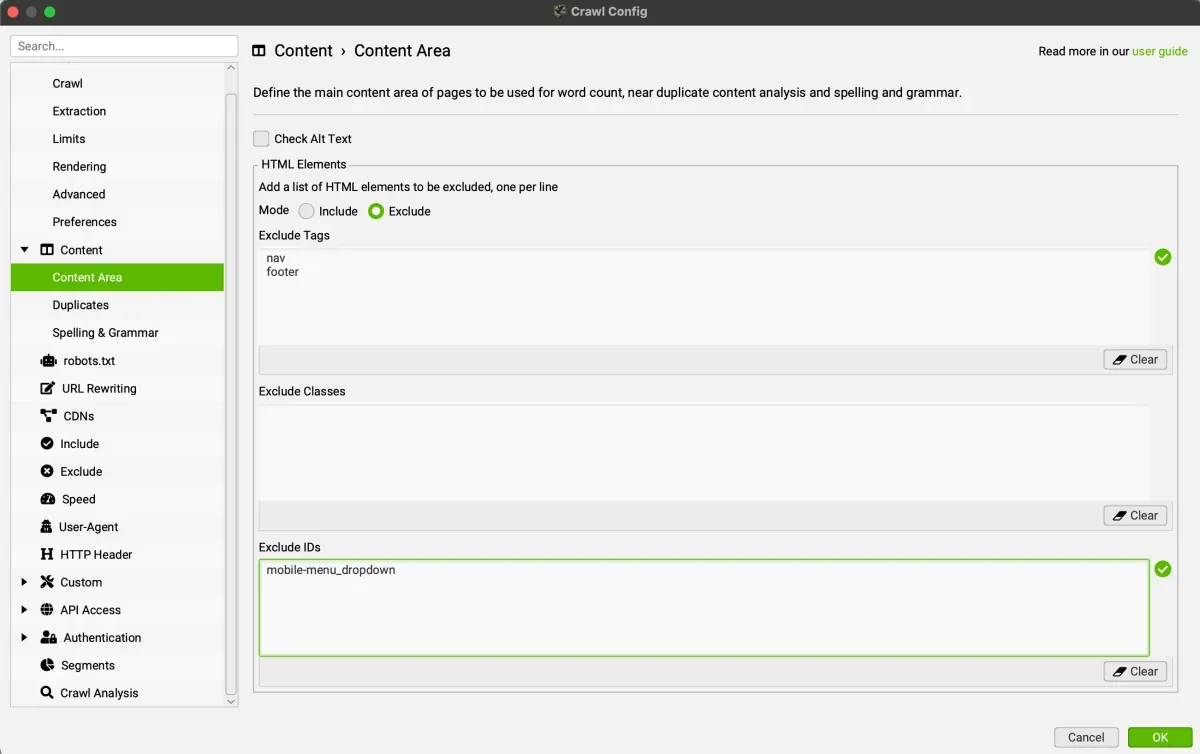
Por defecto, SEO Spider excluye automáticamente los elementos <nav> y
<footer> para centrarse en el contenido principal. Sin embargo, no todos los sitios se construyen con estos elementos HTML5, así que SEO Spider te permite «incluir» o «excluir» del análisis determinadas etiquetas HTML, clases o ID.
Por ejemplo, si rastreas el sitio de Screaming Frog verás que tiene un menú móvil fuera del elemento «nav» que, por defecto, se incluye igualmente en el análisis del contenido. En este caso podrías indicar la clase del menú (‘mobile-menu__dropdown’) y excluirla para centrarte más en el contenido principal.
-
- Rastrea el sitio web.
-
- Consulta los duplicados en la pestaña «Content»
En la pestaña «Content» tienes dos filtros:
- ‘exact duplicates’ (contenido idéntico).
- ‘near duplicates’ (contenido similar).
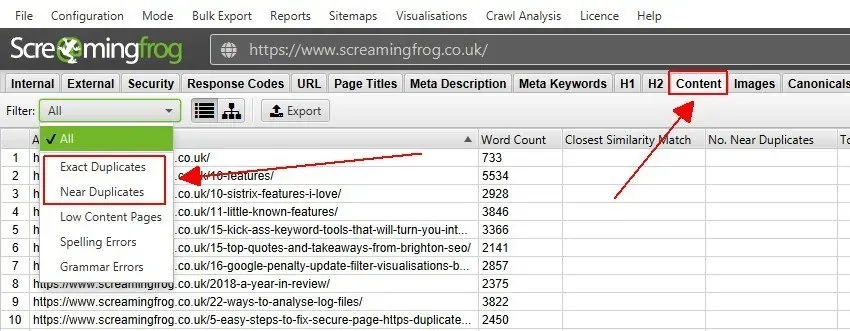
Durante el rastreo esta pestaña se va llenando de datos a medida que avanza, pero solo muestra los «duplicados exactos».
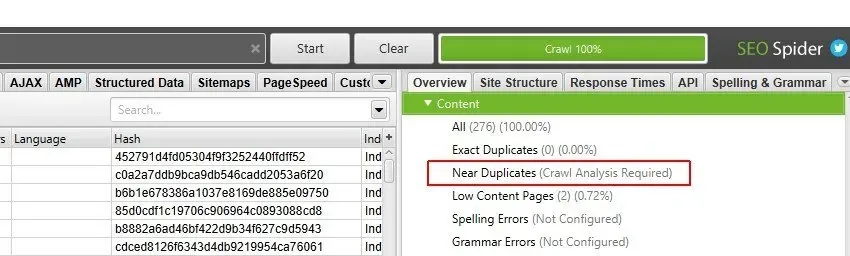
-
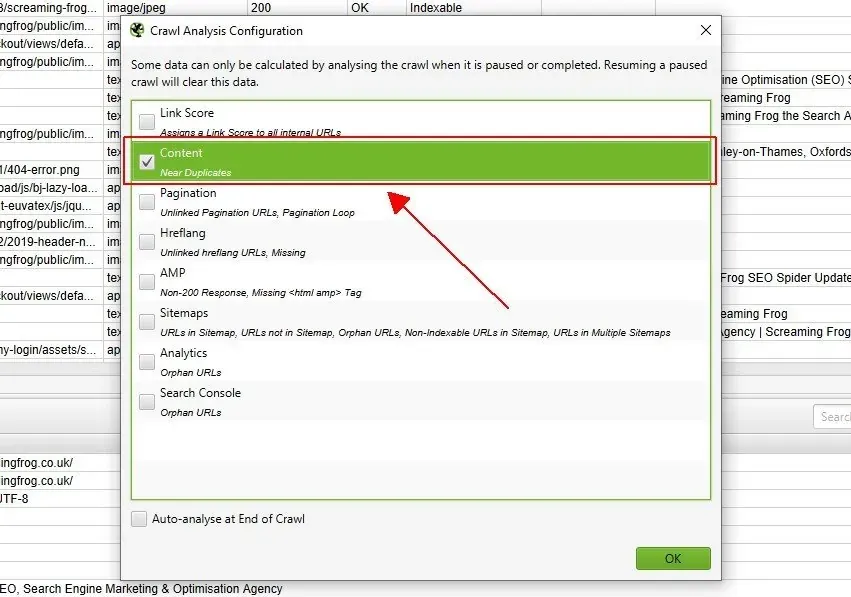
- Configurar la Crawl Analysis
Para rellenar el filtro ‘Near Duplicates’ y las columnas «Closest Similarity Match» y «No. Near Duplicates», debes configurar y ejecutar la Crawl Analysis.
-
- Consulta la pestaña ‘Content’ y los filtros «Exact» y «Near»
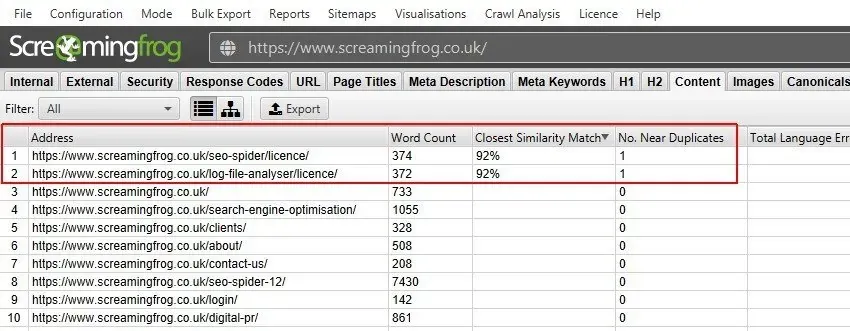
Tras ejecutar el análisis posterior al rastreo, se rellenan el filtro «Near Duplicates» y las columnas «Closest Similarity Match» y «No. Near Duplicates».
Solo las URL con contenido por encima del umbral de similitud elegido tendrán datos; las demás quedarán vacías.
En el caso de abajo, el sitio de Screaming Frog solo tiene dos recursos con un 92 % que habrá que optimizar.
Para una valoración más precisa, puedes ordenar los datos según los dos filtros:
- Exact Duplicates: identifica las páginas con un «hash» idéntico.
Muy útil para gestionar las páginas principales y las que hay que «canonicalizar». - Near Duplicates: identifica las páginas con una «similitud» superior al 90 %, u otro valor si lo has cambiado en «Config > Content > Duplicates».
En resumen, la columna «Closest Similarity Match» muestra el porcentaje de similitud y «No. Near Duplicates» el número de páginas afectadas.
-
- Ver las URL duplicadas en la pestaña ‘Duplicate Details’
Para los «duplicados exactos» basta con ir a la columna «hash» y ordenarla haciendo clic en el encabezado para encontrar todas las coincidencias.
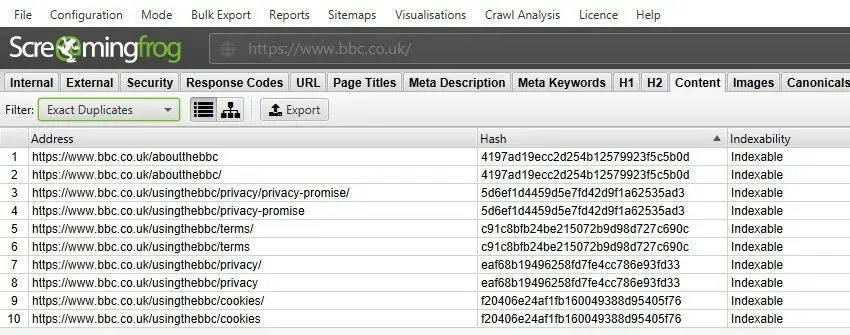
En el ejemplo del sitio de la BBC, cada URL tiene un duplicado exacto porque existe en dos versiones, una con «/» y otra sin.
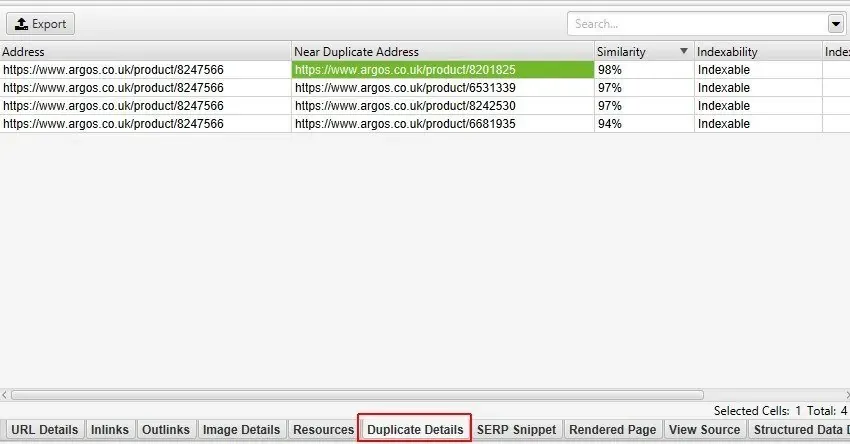
Para encontrar los «casi duplicados (similares)», basta con hacer clic en la pestaña «Duplicate Details» de la ventana inferior.
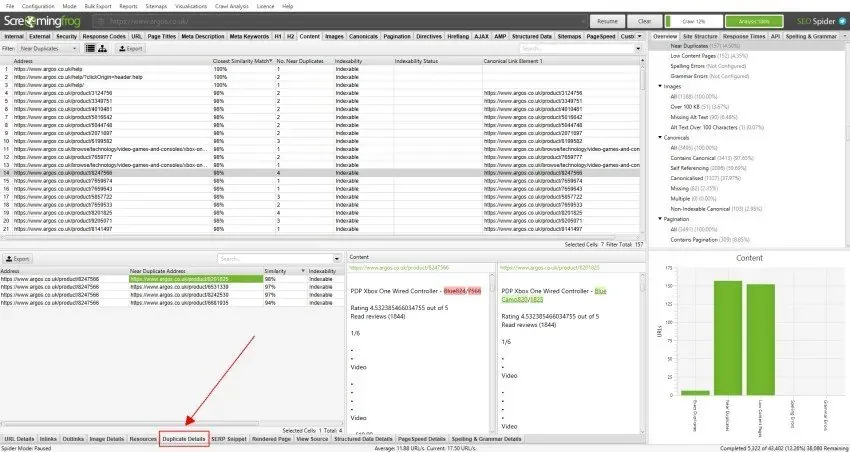
En el caso de arriba, al hacer clic en una URL de la ventana superior aparecen 4 páginas que superan el umbral del 90 % de similitud.
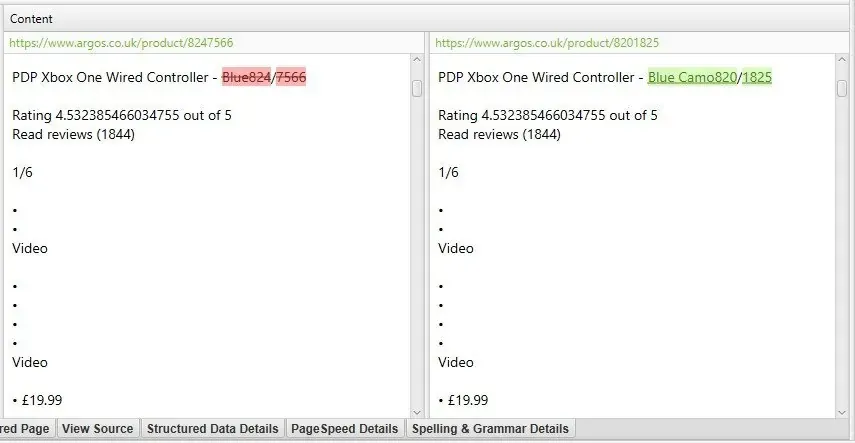
SEO Spider también ofrece una vista previa de los contenidos casi duplicados en la pestaña «Duplicate Details», con una visión muy intuitiva de las partes de texto que diferencian las páginas analizadas.
-
- Exportación en bloque de las URL duplicadas
Tanto los duplicados exactos como los casi duplicados se pueden exportar en bloque.
1Bulk Export›2Content›3Exact Duplicates / Near Duplicates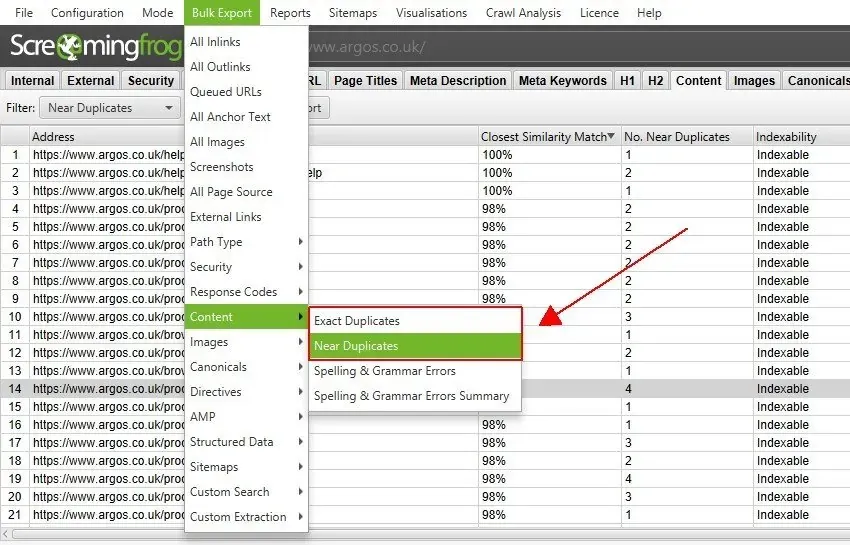
Pestañas relacionadas: Content | Barra lateral | Informes
Vídeo sobre el análisis de contenido duplicado (en italiano)
Canibalización de consultas (en italiano)
¿Dudas sobre Análisis de contenido duplicado?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
