

ONGLET CONTENT.
Contrôle des problèmes de contenus dupliqués, de pages similaires et d’éléments de faible valeur.
Sommaire du guide 4 sections
●Brief01.Présentation de l’onglet Content02.Filtres de l’onglet Content03.Tutoriel vidéoCe que tu trouves dans l’onglet Content de SEO Spider : nombre de mots, doublons exacts et quasi-doublons, pages au contenu faible, fautes d’orthographe et de grammaire.
Présentation de l’onglet Content
L’onglet « Content » affiche les données sur le contenu des URL découvertes pendant le crawl : nombre de mots, doublons exacts et quasi-doublons, fautes d’orthographe et de grammaire.
-
Address : l’adresse de l’URL.
-
Word Count : le nombre total de « mots » crawlés dans la balise body, hors balisage HTML.
Le décompte se base sur la zone de contenu définie par SEO Spider, que tu peux personnaliser dans 1Configuration›2Content›3Content Area.
Par défaut, les éléments <nav> et <footer> sont exclus.
Pour une analyse plus fine, tu peux inclure ou exclure des éléments HTML, des classes et des ID. Les valeurs de Screaming Frog peuvent différer d’un comptage manuel, car le parser corrige certaines choses quand il rencontre du HTML invalide. Tes réglages de rendu peuvent aussi influencer le HTML pris en compte. Screaming Frog compte les mots en découpant le texte sur les espaces, sans tenir compte de la visibilité du contenu (comme un texte dans un div masqué). -
Closest Similarity Match : indique le degré de similarité entre pages pour éviter les duplications. Avec le seuil par défaut, SEO Spider considère un contenu comme « quasi-doublon » à partir de 90 % de correspondance. Tu peux personnaliser ce seuil dans 1Configuration›2Content›3Duplicates en activant Enable Near Duplicates et en réglant Near Duplicate Similarity Threshold. Pour remplir cette colonne, il faut lancer la Crawl Analysis. Seules les URL au-dessus du seuil auront des données, les autres restent vides. Bref, par défaut, cette colonne ne contient des données que pour les URL similaires à 90 % ou plus.
-
No. Near Duplicates : le nombre d’URL quasi-doublons trouvées qui atteignent ou dépassent le « Near Duplicate Similarity Threshold », 90 % par défaut. Réglable dans 1Configuration›2Content›3Duplicates. Pour remplir cette colonne, active les quasi-doublons et lance la Crawl Analysis.
-
Total Language Errors : le nombre total de fautes d’orthographe et de grammaire d’une URL. Pour remplir cette colonne, sélectionne « Enable Spell Check » et/ou « Enable Grammar Check » dans 1Configuration›2Content›3Spelling & Grammar.
-
Spelling Errors : le nombre total de fautes d’orthographe d’une URL. Il faut activer « Enable Spell Check ».
-
Grammar Errors : le nombre total de fautes de grammaire d’une URL. Il faut activer « Enable Grammar Check ». Dans les réglages, tu peux définir la langue, les règles de grammaire et le dictionnaire de référence.
Pour consulter les fautes dans l’onglet inférieur de SEO Spider, sélectionne simplement les URL dans la colonne dédiée de l’onglet « Internal » (fenêtre supérieure).
Une excellente fonction pour les rédacteurs, qui repère fautes de frappe et erreurs de grammaire. En plus de la liste, elle propose des corrections et montre où les fautes se trouvent sur le site, avec un aperçu. Pour les langues autres que l’anglais, les suggestions peuvent être moins fiables, mais le dictionnaire reste très utile pour les fautes de frappe. -
Language : la langue choisie pour les contrôles d’orthographe et de grammaire. Elle se base sur l’attribut de langue défini dans le HTML et peut aussi être réglée dans 1Configuration›2Content›3Spelling & Grammar.
-
Hash : la valeur de hachage MD5 de l’URL. C’est un contrôle des doublons exacts, à la différence de « Closest Similarity Match » qui utilise un seuil de similarité. Si deux hachages sont identiques, les pages ont exactement le même contenu. S’il y a ne serait-ce qu’un caractère de différence, les hachages diffèrent et les pages ne sont pas signalées comme doublons. Les doublons exacts se trouvent dans « URL > Duplicate ».
-
Sentence Count, Average Words per Sentence, Flesch Reading Ease et Readability : le nombre de phrases, la moyenne de mots par phrase, l’indice de lisibilité Flesch et son classement (de Easy à Very Hard). L’indice Flesch est conçu pour l’anglais : sur les textes en d’autres langues, interprète-le avec prudence.
-
Indexability : si l’URL est indexable ou non indexable.
-
Indexability Status : la raison pour laquelle une URL n’est pas indexable, par exemple canonicalisée vers une autre URL ou en « noindex ».
Filtres de l’onglet Content
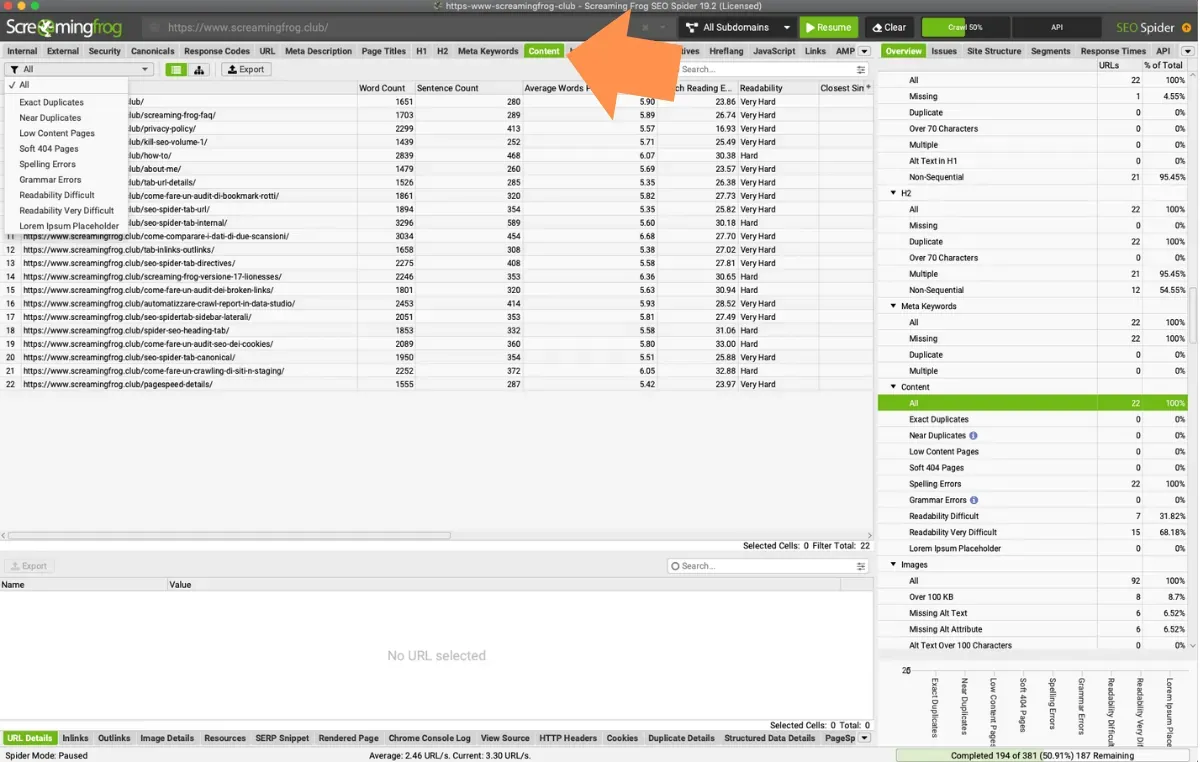
Les filtres disponibles :
- Exact Duplicates : toutes les pages qui ont le même hachage et que les moteurs pourraient considérer comme dupliquées, au détriment du PageRank.
Ce filtre permet d’isoler les pages dupliquées et de les corriger en définissant correctement les versions canonique et canonicalisée. - Near Duplicates : toutes les pages similaires (pas identiques !) selon un seuil de similarité de 90 % par défaut, personnalisable dans les réglages.
La colonne « Closest Similarity Match » indique le plus haut pourcentage de similarité avec une autre page.
La colonne « No. Near Duplicates » indique combien de pages sont similaires selon le seuil. L’algorithme s’exécute sur le texte de la page, et non sur tout le HTML comme pour les doublons exacts.
Le contenu utilisé pour cette analyse se configure dans 1Configuration›2Content›3Content Area.
N’oublie pas que des pages peuvent afficher 100 % de similarité tout en n’étant que des « quasi-doublons », à cause de l’arrondi : 99,5 % ou plus s’affiche comme 100 %.
Pour remplir cette colonne, active « Enable Near Duplicates » dans 1Configuration›2Content›3Duplicates et lance la Crawl Analysis.
- Low Content Pages : toutes les pages de moins de 200 mots. Le décompte se base sur la zone de contenu, configurable dans 1Configuration›2Content›3Content Area.
Les moteurs n’ont jamais indiqué de nombre minimal de mots pour qu’un contenu soit jugé valable mais, comme on dit, « content is king » : le contenu descriptif est l’un des éléments les plus importants pour le référencement naturel.
Une analyse que je te conseille : comparer les impressions dans la Search Console avec le filtre « Low Content Pages », pour voir si les pages pauvres sont pénalisées et si leur contenu doit être enrichi. Bien sûr, cela dépend du site : un e-commerce n’a pas forcément besoin de longs textes et peut bien performer avec des contenus plus courts.
Tu peux régler le seuil avec Low Content Word Count dans 1Configuration›2Spider›3Preferences.
- Soft 404 Pages : les pages qui répondent 200 mais dont le contenu évoque une page introuvable (par exemple « page introuvable » ou « 0 produit »).
- Spelling Errors : toutes les pages HTML avec des fautes d’orthographe.
- Grammar Errors : toutes les pages HTML avec des fautes de grammaire.
- Readability Difficult et Readability Very Difficult : les pages dont le texte est difficile ou très difficile à lire selon l’indice Flesch.
- Lorem Ipsum Placeholder : les pages qui contiennent encore le texte de remplissage « lorem ipsum ».
Tutoriel vidéo
Des questions sur ONGLET CONTENT?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
