

PESTAÑA CONTENT.
Control de los problemas de contenido duplicado, páginas similares y elementos de poco valor.
Índice de la guía 4 secciones
●Brief01.Panorámica de la pestaña Content02.Filtros de la pestaña Content03.VideotutorialQué encuentras en la pestaña Content de SEO Spider: recuento de palabras, duplicados exactos y casi duplicados, páginas con poco contenido, errores de ortografía y gramática.
Panorámica de la pestaña Content
La pestaña «Content» muestra los datos sobre el contenido de las URL descubiertas durante el rastreo: número de palabras, duplicados exactos y casi duplicados, y errores de ortografía y gramática.
-
Address: la dirección de la URL.
-
Word Count: la suma de todas las «palabras» rastreadas dentro de la etiqueta body, sin contar el marcado HTML.
El recuento se basa en el área de contenido definida por SEO Spider, que puedes personalizar en 1Configuration›2Content›3Content Area.
Por defecto se excluyen los elementos <nav> y <footer>.
Para un análisis más fino puedes incluir o excluir elementos HTML, clases e ID. Los valores de Screaming Frog pueden diferir de un recuento manual, porque el parser hace algunas correcciones cuando encuentra HTML no válido. También pueden influir tus ajustes de renderizado. Screaming Frog cuenta las palabras dividiendo el texto por espacios, sin tener en cuenta si el contenido es visible (como un texto dentro de un div oculto). -
Closest Similarity Match: muestra el grado de similitud entre páginas para evitar duplicaciones. Con el umbral por defecto, SEO Spider considera «casi duplicado» un contenido a partir del 90 % de coincidencia. Puedes personalizar el umbral en 1Configuration›2Content›3Duplicates activando Enable Near Duplicates y ajustando Near Duplicate Similarity Threshold. Para rellenar esta columna hay que ejecutar la Crawl Analysis. Solo las URL por encima del umbral tendrán datos; las demás quedan vacías. En resumen, por defecto esta columna solo tendrá datos para las URL con un 90 % o más de similitud.
-
No. Near Duplicates: el número de URL casi duplicadas que alcanzan o superan el «Near Duplicate Similarity Threshold», un 90 % por defecto. Se ajusta en 1Configuration›2Content›3Duplicates. Para rellenar esta columna, activa los casi duplicados y ejecuta la Crawl Analysis.
-
Total Language Errors: el número total de errores de ortografía y gramática de una URL. Para rellenarla, selecciona «Enable Spell Check» y/o «Enable Grammar Check» en 1Configuration›2Content›3Spelling & Grammar.
-
Spelling Errors: el número total de errores ortográficos de una URL. Hay que activar «Enable Spell Check».
-
Grammar Errors: el número total de errores gramaticales de una URL. Hay que activar «Enable Grammar Check». En los ajustes puedes definir el idioma, las reglas gramaticales y el diccionario de referencia.
Para consultar los errores en la pestaña inferior de SEO Spider, basta con seleccionar las URL en la columna correspondiente de la pestaña «Internal» (ventana superior).
Una función excelente para los redactores, que detecta erratas y errores gramaticales. Además de la lista, propone correcciones y muestra en qué parte del sitio se encontraron, con vista previa. En idiomas distintos del inglés las sugerencias pueden ser menos fiables, pero el diccionario es muy útil para las erratas. -
Language: el idioma elegido para los controles ortográficos y gramaticales. Se basa en el atributo de idioma definido en el HTML y también se puede fijar en 1Configuration›2Content›3Spelling & Grammar.
-
Hash: el valor hash MD5 de la URL. Es un control de duplicados exactos, a diferencia de «Closest Similarity Match», que usa un umbral de similitud. Si dos valores hash coinciden, las páginas tienen exactamente el mismo contenido. Si difieren aunque sea en un carácter, tienen hash distintos y no se marcan como duplicadas. Los duplicados exactos se ven en «URL > Duplicate».
-
Sentence Count, Average Words per Sentence, Flesch Reading Ease y Readability: el número de frases, las palabras medias por frase, el índice de legibilidad Flesch y su clasificación (de Easy a Very Hard). El índice Flesch está pensado para el inglés, así que en textos de otros idiomas hay que leerlo con cautela.
-
Indexability: si la URL es indexable o no indexable.
-
Indexability Status: el motivo por el que una URL no es indexable, por ejemplo canonicalizada hacia otra URL o con «noindex».
Filtros de la pestaña Content
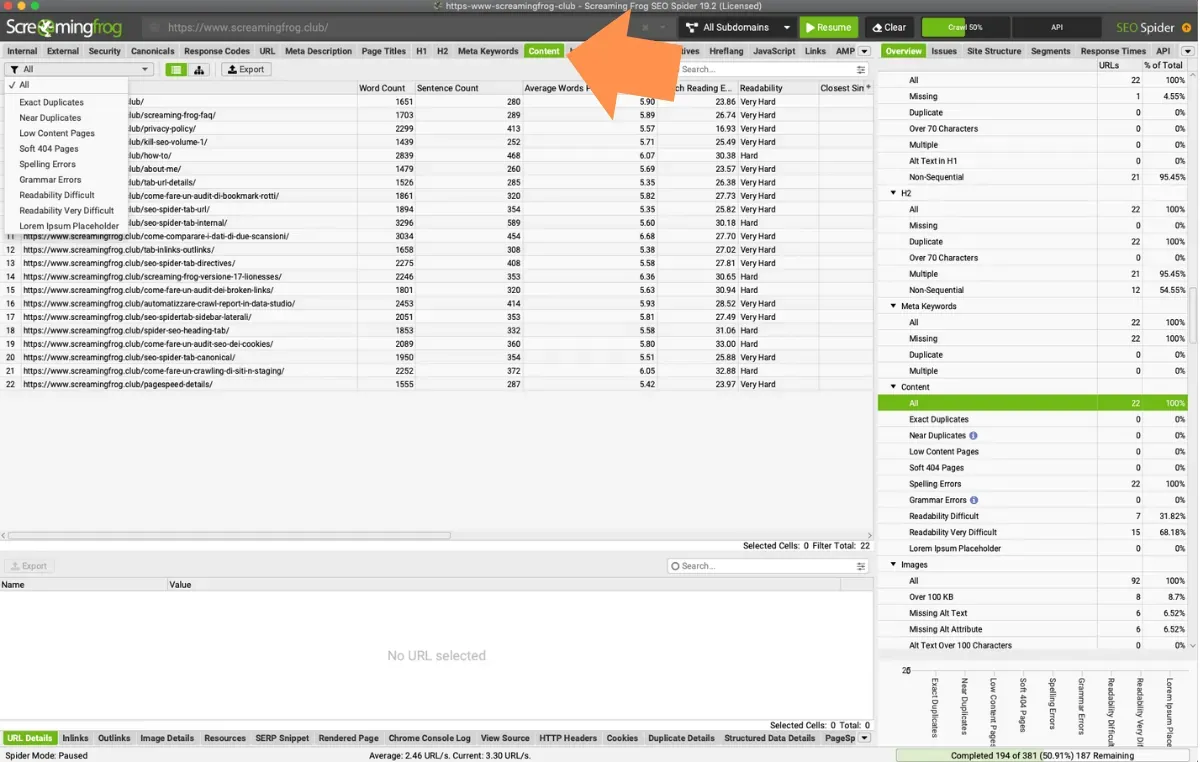
Estos son los filtros disponibles:
- Exact Duplicates: todas las páginas con el mismo hash, que los buscadores podrían considerar duplicadas, en perjuicio del PageRank.
Este filtro te permite aislar las páginas duplicadas y corregirlas definiendo bien la versión canónica y la canonicalizada. - Near Duplicates: todas las páginas similares (¡no idénticas!) según un umbral de similitud que por defecto es del 90 % y se puede personalizar en los ajustes.
La columna «Closest Similarity Match» muestra el mayor porcentaje de similitud con otra página.
La columna «No. Near Duplicates» muestra cuántas páginas son similares según el umbral. El algoritmo se ejecuta sobre el texto de la página y no sobre todo el HTML, como en los duplicados exactos.
El contenido usado para este análisis se configura en 1Configuration›2Content›3Content Area.
Recuerda que algunas páginas pueden mostrar un 100 % de similitud y ser solo «casi duplicadas» por el redondeo: un 99,5 % o más se muestra como 100 %.
Para rellenar esta columna, activa «Enable Near Duplicates» en 1Configuration›2Content›3Duplicates y ejecuta la Crawl Analysis.
- Low Content Pages: todas las páginas con menos de 200 palabras. El recuento se basa en el área de contenido, configurable en 1Configuration›2Content›3Content Area.
Los buscadores nunca han indicado un número mínimo de palabras para que un contenido se considere válido pero, como dice la frase, «content is king»: el contenido descriptivo es uno de los elementos más importantes para el posicionamiento orgánico.
Un análisis que te recomiendo es comparar las impresiones de Search Console con el filtro «Low Content Pages», para ver si las páginas con poco contenido salen penalizadas y conviene ampliarlas. Depende del sitio, claro: un ecommerce puede no necesitar textos largos y funcionar bien con contenidos más breves.
El umbral se ajusta con Low Content Word Count en 1Configuration›2Spider›3Preferences.
- Soft 404 Pages: las páginas que responden 200 pero cuyo contenido sugiere una página no encontrada (por ejemplo «página no encontrada» o «0 productos»).
- Spelling Errors: todas las páginas HTML con errores ortográficos.
- Grammar Errors: todas las páginas HTML con errores gramaticales.
- Readability Difficult y Readability Very Difficult: las páginas con un texto difícil o muy difícil de leer según el índice Flesch.
- Lorem Ipsum Placeholder: las páginas que todavía contienen el texto de relleno «lorem ipsum».
Videotutorial
¿Dudas sobre PESTAÑA CONTENT?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
