

Problemi scansione del Seo Spider.
Scopri come gestire potenziali problemi di scansione del Seo Spider.
Indice della guida 5 sezioni
●Brief01.Intro02.Status Code 0: nessuna risposta03.Status Code HTTP04.Errore 429 e ShopifyCosa fare quando SEO Spider scansiona una sola pagina o si blocca: le cause più frequenti (robots.txt, DNS, timeout, connessione rifiutata, errori 4xx e 5xx) e, per ognuna, come risolvere. Con un focus sull'errore 429 nei negozi Shopify e le signature per i crawler.
Intro
A volte può capitare che Screaming Frog esegua il crawl di una sola pagina o non scansioni come previsto.
In quel caso le prime cose da controllare sono lo Status e lo Status Code delle risorse restituite, per identificare il problema e risolverlo.
Status Code 0: nessuna risposta
Blocked by Robots.txt
Il filtro mostra tutti gli URL bloccati dal robots.txt del sito, che non permette allo Spider di scansionare quelle risorse e, di conseguenza, di farle indicizzare dai Motori di Ricerca.
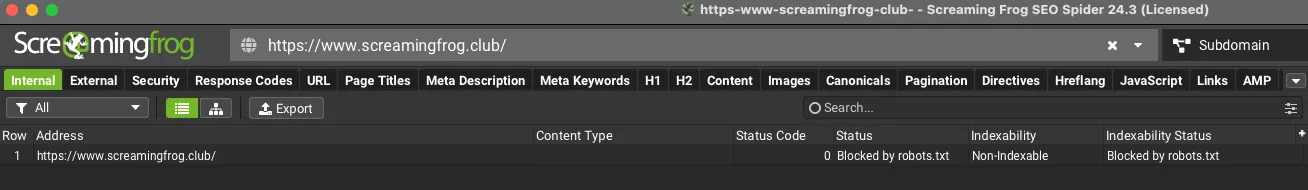
Ogni “0” nella colonna Status Code indica la mancanza di una risposta HTTP del server, mentre la colonna Status ne indica il motivo. Nell’esempio lo user agent dello Spider è stato bloccato dal robots.txt con la direttiva “disallow” e, essendo bloccato, non può vedere la risposta HTTP.
Cosa fare
Puoi impostare il SEO Spider per ignorare il robots.txt da 1Configuration›2robots.txt scegliendo Ignore robots.txt, oppure personalizzarlo con un robots.txt custom. Di default Screaming Frog segue le indicazioni “disallow” del file robots.txt.
ApprofondimentoCrawling siti in staging.Robots.txt, autenticazione, noindex e nofollow: come scansionare un sito protetto prima della messa online.Leggi la guidaDNS Lookup Failed
Indica che il sito non è stato trovato, per un errore nell’inserimento del dominio o per una mancanza di connessione alla rete.

Cosa fare
Controlla che il dominio sia scritto correttamente e che il sito sia visibile nel tuo browser. Se non riesci a visualizzarlo nemmeno dal browser potrebbero esserci problemi di connettività; se invece il sito si apre correttamente, controlla se un antivirus o un firewall stanno bloccando il SEO Spider.
Connection Timeout
Indica che Screaming Frog ha richiesto la risposta HTTP al server ma non l’ha ricevuta entro 20 secondi. Per ovviare al problema puoi aumentare il Response Timeout nelle configurazioni o ridurre la velocità dello Spider, per non sovraccaricare il server e dargli più tempo per rispondere.

Cosa fare
- Controlla i tempi di caricamento del sito nel browser: se sono molto lunghi, aumenta il timeout da 1Configuration›2Spider›3Advanced e riduci la velocità del crawler da 1Configuration›2Speed per alleggerire il server.
- Controlla se riesci a scansionare altri siti con Screaming Frog. Se il problema è diffuso potrebbe dipendere da antivirus o firewall: prova a creare un’eccezione per Screaming Frog.
- Se nemmeno questo risolve, probabilmente c’è un problema di rete o locale. Controlla ad esempio se il proxy è abilitato in 1File›2Settings›3Proxy: se lo è, prova a disabilitarlo e riavvia il crawl.
Connection Refused
Viene restituito quando il tentativo di connessione del SEO Spider è stato rifiutato in qualche punto tra la tua macchina e il sito web.

Cosa fare
- Riesci a scansionare altri siti web? Se sì, controlla antivirus e firewall e crea un’eccezione per lo Spider; se il problema è comune ad altri siti, verifica che non ci sia un problema di rete o del tuo computer.
- Riesci a vedere la pagina nel browser o restituisce un errore simile? Se la pagina si vede, cambia lo user agent in Chrome da 1Configuration›2User-Agent.
No Response
Il SEO Spider ha problemi a creare connessioni o a ricevere risposte. Una causa comune è il proxy.

Cosa fare
Il primo controllo riguarda il proxy (1File›2Settings›3Proxy): prova a disabilitarlo. Se non è impostato correttamente il SEO Spider potrebbe non riuscire a inviare o ricevere le richieste.
Status Code HTTP
Success (2xx)
L’URL richiesto è stato ricevuto, compreso, accettato ed elaborato con successo. Se il crawl si ferma comunque alla prima pagina, ecco i controlli che ti suggerisco.
Cosa fare
- La pagina ha la direttiva meta robots “nofollow” (o nell’intestazione HTTP), oppure tutti i link della pagina hanno l’attributo rel=“nofollow”? In questo caso imposta il SEO Spider per seguire i link Internal/External nofollow da 1Configuration›2Spider›3Crawl: di default Screaming Frog rispetta i “nofollow”.
- Il sito ha link in JavaScript? Prova a disabilitare JavaScript e a visualizzare le pagine nel browser. Se i link spariscono, abilita il rendering JavaScript da 1Configuration›2Spider›3Rendering. Per impostazione predefinita il SEO Spider scansiona solo i link
<a href="">,<img src="">e<link rel="canonical">nel codice sorgente HTML e non legge il DOM. - Controlla la sezione 1Configuration›2Spider›3Limits, in particolare “Limit Crawl Depth” e “Limit Crawl Total”: se sono impostati a 0 o 1, il SEO Spider scansiona un solo URL.
- Il sito richiede i cookie? Prova a visualizzare la pagina con i cookie disabilitati nel browser: al SEO Spider potrebbe essere servita una pagina diversa, senza link. Per risolvere imposta Cookie Storage su “Session Only” in 1Configuration›2Spider›3Advanced.
- Cosa c’è nella colonna Content Type? Se è vuota, abilita il rendering JavaScript e riavvia il crawl. Succede quando l’intestazione HTTP non specifica il tipo di contenuto e il SEO Spider non sa se l’URL è un’immagine, un PDF o una pagina HTML, quindi non la analizza per cercare altri link. Con il rendering attivo il tool controlla anche se nell’
<head>è presente un<meta http-equiv>. - Ci sono restrizioni legate all’età? Prova a impostare lo user agent su Googlebot (1Configuration›2User-Agent): il server potrebbe servire l’HTML ai bot dei motori di ricerca senza chiedere l’età.
Redirection (3xx)
È stato rilevato un reindirizzamento, come un 301 o un 302. Idealmente ogni link interno dovrebbe puntare a una risposta 200 ed evitare passaggi in più per lo Spider, a tutela del Crawl Budget.

Cosa fare
- Controlla la destinazione del reindirizzamento negli outlink dell’URL. Se trovi un loop il SEO Spider non riesce a completare la scansione.
- Tab External: il SEO Spider tratta i sottodomini come esterni e di default non li scansiona. Per includerli attiva Crawl All Subdomains in 1Configuration›2Spider›3Crawl.
- Il sito richiede i cookie? Prova a disabilitarli nel browser: se riscontri il problema, imposta Cookie Storage su “Session Only” in 1Configuration›2Spider›3Advanced. Succede quando il SEO Spider viene reindirizzato a un URL che imposta un cookie, ma il cookie non viene accettato.
Client Error (4xx)
Il server non riesce o non vuole elaborare la richiesta e nega al SEO Spider l’URL richiesto.

Cosa fare
- 403 Forbidden: se la pagina si vede nel browser, prova a impostare Chrome come user agent (1Configuration›2User-Agent). Probabilmente il sito nega la pagina al SEO Spider per motivi di sicurezza.

- 404 Not Found: il server indica che la pagina non esiste. Se anche con lo user agent Chrome la situazione non cambia, il problema è probabilmente del sito. Se invece con Chrome la pagina viene restituita (o la vedi nel browser) e il crawl parte, il server stava bloccando il nostro user agent per motivi di sicurezza.
- 429 Too Many Requests: sono state fatte troppe richieste al server in un determinato periodo di tempo. Riesci a vedere il sito nel browser o mostra un errore simile? Riduci la velocità di crawl e/o prova un user agent diverso, come Chrome o Googlebot. Se il sito è su Shopify, leggi la sezione successiva.
Errore Server (5xx)
Il server non è riuscito a soddisfare una richiesta apparentemente valida. Rientrano qui risposte comuni come 500 Internal Server Error, 502 Bad Gateway e 503 Service Unavailable.

Cosa fare
- Riesci a vedere il sito nel browser o è down? Se la pagina si vede, cambia lo user agent in Chrome (1Configuration›2User-Agent).
Errore 429 e Shopify
Se scansioni un negozio Shopify, soprattutto un tema in staging o un negozio non ancora pubblicato, è facile vedere comparire dopo poche decine di URL una lunga serie di 429 Too Many Requests. Shopify applica un rate limiting molto aggressivo ai crawler che non riconosce, e ridurre la velocità del SEO Spider spesso non basta: il crawl diventa lentissimo e i dati restano incompleti.
La soluzione ufficiale sono le signature per i crawler (crawler access). Shopify ti permette di generare delle firme crittografiche che autenticano il tuo crawler sul negozio: quando il SEO Spider le invia, Shopify lo riconosce come uno strumento autorizzato e non lo limita. Secondo la documentazione di Shopify, se il crawler riceve errori di rate limiting significa che la signature non è valida.
Creare la signature su Shopify
- Nell’admin di Shopify vai in Online Store › Preferences.
- Nella sezione Crawler access clicca su Create signature.
- Dai un nome descrittivo alla signature, per esempio “Screaming Frog staging”.
- Seleziona il dominio collegato su cui la userai: ogni signature vale per un solo dominio.
- Scegli la scadenza (al massimo tre mesi) e clicca su Create.
- Copia i valori di Signature-Input e Signature.
Le caratteristiche principali delle signature, secondo Shopify, sono:
- Autenticazione sicura: le firme sono crittografiche e non si possono falsificare.
- Scadenza controllata: scadono automaticamente dopo il periodo scelto, al massimo tre mesi, e non si possono rinnovare né prolungare. Per una nuova data crei una nuova signature e aggiorni lo strumento; la vecchia funziona fino alla sua scadenza originale.
- Gestione centralizzata: le trovi tutte in Crawler access, dove puoi anche ricopiare i valori se li hai persi.
- Nome personalizzato: ti aiuta a ricordare per quale strumento o progetto l’hai creata.
- Legata al dominio: funziona solo sul dominio associato.
Le signature non danno accesso al Checkout e non servono a motori di ricerca e LLM, che indicizzano il negozio anche senza.
Impostare gli HTTP Header in Screaming Frog
Ogni richiesta del SEO Spider deve contenere tre intestazioni HTTP. Vai in 1Configuration›2HTTP Header, clicca su Add per ognuna e inserisci nome e valore:
- Signature-Input: il valore copiato dall’admin di Shopify.
- Signature: il valore copiato dall’admin di Shopify.
- Signature-Agent:
"https://shopify.com", virgolette comprese.
Il risultato è simile a questo. I valori di Signature-Input e Signature qui sono solo indicativi: usa sempre quelli generati per il tuo negozio.
Signature-Input: sig1=("@authority" "signature-agent");created=1760600000;expires=1768376000;keyid="…";alg="ed25519";tag="web-bot-auth"
Signature: sig1=:…valore-base64-copiato-da-shopify…:
Signature-Agent: "https://shopify.com"
Se continui a ricevere errori 429, Shopify suggerisce di controllare che:
- il formato delle intestazioni sia corretto, senza spazi o caratteri persi nel copia e incolla;
- tutte e tre le intestazioni siano inviate con ogni richiesta;
- la signature non sia scaduta (la data è in Crawler access);
- stai scansionando proprio il dominio associato alla signature, non un altro dominio o il dominio myshopify.com.
Hai domande su Problemi scansione del Seo Spider?
Le guide nascono dai progetti di tutti i giorni. Se qualcosa non torna nel tuo crawl, o vuoi applicare questa procedura al tuo sito, scrivimi.
 Autore.Raffaele Visintin.Search & Strategic Marketing Advisor
