

Problèmes de crawl de SEO Spider.
Découvre comment gérer les éventuels problèmes de crawl de SEO Spider.
Sommaire du guide 5 sections
●Brief01.Intro02.Status Code 0 : aucune réponse03.Codes de statut HTTP04.L’erreur 429 et ShopifyQue faire quand SEO Spider ne crawle qu’une seule page ou se bloque : les causes les plus fréquentes (robots.txt, DNS, timeout, connexion refusée, erreurs 4xx et 5xx) et, pour chacune, comment la résoudre. Avec un focus sur l’erreur 429 des boutiques Shopify et les signatures pour les crawlers.
Intro
Il arrive parfois que Screaming Frog ne crawle qu’une seule page ou ne crawle pas comme prévu.
Dans ce cas, les premières choses à vérifier sont le Status et le Status Code des ressources renvoyées, pour identifier le problème et le résoudre.
Status Code 0 : aucune réponse
Blocked by Robots.txt
Ce filtre affiche toutes les URL bloquées par le robots.txt du site, qui empêche le Spider de crawler ces ressources et, par conséquent, de les faire indexer par les moteurs de recherche.
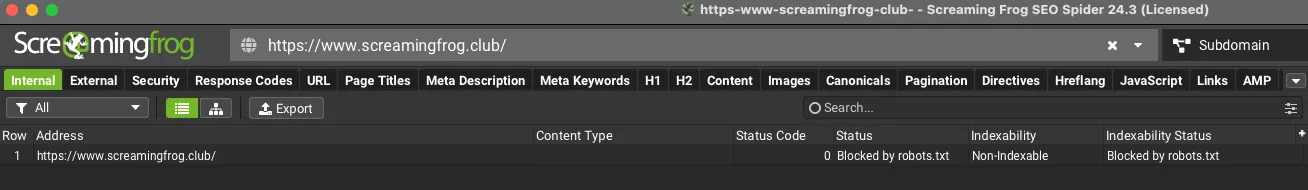
Chaque « 0 » dans la colonne Status Code indique l’absence de réponse HTTP du serveur, tandis que la colonne Status en donne la raison. Dans l’exemple, le user agent du Spider a été bloqué par le robots.txt avec la directive « disallow » et, étant bloqué, il ne peut pas voir la réponse HTTP.
Que faire
Tu peux régler SEO Spider pour ignorer le robots.txt depuis 1Configuration›2robots.txt en choisissant Ignore robots.txt, ou utiliser un robots.txt personnalisé. Par défaut, Screaming Frog suit les règles « disallow » du fichier robots.txt.
Pour aller plus loinCrawler des sites en staging.Robots.txt, authentification, noindex et nofollow : comment crawler un site protégé avant sa mise en ligne.Lire le guideDNS Lookup Failed
Le site n’a pas été trouvé, à cause d’une faute dans le domaine ou d’une absence de connexion réseau.

Que faire
Vérifie que le domaine est bien écrit et que le site s’affiche dans ton navigateur. S’il ne s’affiche pas non plus dans le navigateur, il peut y avoir un problème de connexion ; s’il s’ouvre correctement, vérifie si un antivirus ou un pare-feu bloque SEO Spider.
Connection Timeout
Screaming Frog a demandé la réponse HTTP au serveur mais ne l’a pas reçue dans les 20 secondes. Pour contourner le problème, tu peux augmenter le Response Timeout dans la configuration ou réduire la vitesse du Spider, pour ne pas surcharger le serveur et lui laisser plus de temps pour répondre.

Que faire
- Vérifie les temps de chargement du site dans le navigateur : s’ils sont très longs, augmente le timeout dans 1Configuration›2Spider›3Advanced et réduis la vitesse du crawler dans 1Configuration›2Speed pour soulager le serveur.
- Vérifie si tu peux crawler d’autres sites avec Screaming Frog. Si le problème est général, il peut venir de l’antivirus ou du pare-feu : essaie de créer une exception pour Screaming Frog.
- Si ça ne suffit pas, il y a sans doute un problème réseau ou local. Vérifie par exemple si le proxy est activé dans 1File›2Settings›3Proxy : si oui, désactive-le et relance le crawl.
Connection Refused
Renvoyé quand la tentative de connexion de SEO Spider a été refusée quelque part entre ta machine et le site.

Que faire
- Arrives-tu à crawler d’autres sites ? Si oui, vérifie l’antivirus et le pare-feu et crée une exception pour le Spider ; si le problème touche d’autres sites, vérifie qu’il n’y a pas de souci de réseau ou d’ordinateur.
- Vois-tu la page dans le navigateur, ou renvoie-t-elle une erreur similaire ? Si la page s’affiche, passe le user agent sur Chrome dans 1Configuration›2User-Agent.
No Response
SEO Spider a du mal à créer des connexions ou à recevoir des réponses. Une cause fréquente est le proxy.

Que faire
Le premier contrôle concerne le proxy (1File›2Settings›3Proxy) : essaie de le désactiver. S’il n’est pas bien configuré, SEO Spider peut ne pas réussir à envoyer ou recevoir les requêtes.
Codes de statut HTTP
Success (2xx)
L’URL demandée a été reçue, comprise, acceptée et traitée avec succès. Si le crawl s’arrête quand même à la première page, voici les contrôles que je te conseille.
Que faire
- La page a-t-elle une directive meta robots « nofollow » (ou dans l’en-tête HTTP), ou tous ses liens ont-ils l’attribut rel=“nofollow” ? Dans ce cas, règle SEO Spider pour suivre les liens Internal/External nofollow dans 1Configuration›2Spider›3Crawl : par défaut, Screaming Frog respecte les « nofollow ».
- Le site a-t-il des liens en JavaScript ? Désactive JavaScript et affiche les pages dans le navigateur. Si les liens disparaissent, active le rendu JavaScript dans 1Configuration›2Spider›3Rendering. Par défaut, SEO Spider ne crawle que les liens
<a href="">,<img src="">et<link rel="canonical">du code source HTML et ne lit pas le DOM. - Vérifie la section 1Configuration›2Spider›3Limits, en particulier « Limit Crawl Depth » et « Limit Crawl Total » : s’ils sont réglés sur 0 ou 1, SEO Spider ne crawle qu’une URL.
- Le site exige-t-il des cookies ? Affiche la page avec les cookies désactivés dans le navigateur : SEO Spider reçoit peut-être une page différente, sans liens. Pour résoudre, règle Cookie Storage sur « Session Only » dans 1Configuration›2Spider›3Advanced.
- Que contient la colonne Content Type ? Si elle est vide, active le rendu JavaScript et relance le crawl. Cela arrive quand l’en-tête HTTP ne précise pas le type de contenu : SEO Spider ne sait pas si l’URL est une image, un PDF ou une page HTML, et ne l’analyse donc pas pour chercher d’autres liens. Avec le rendu activé, l’outil vérifie aussi la présence d’un
<meta http-equiv>dans le<head>. - Y a-t-il des restrictions d’âge ? Essaie de régler le user agent sur Googlebot (1Configuration›2User-Agent) : le serveur sert peut-être le HTML aux robots des moteurs sans demander l’âge.
Redirection (3xx)
Une redirection a été détectée, comme une 301 ou une 302. Idéalement, chaque lien interne devrait pointer vers une réponse 200 et éviter des étapes en plus au Spider, pour préserver le Crawl Budget.

Que faire
- Vérifie la destination de la redirection dans les outlinks de l’URL. En cas de boucle, SEO Spider ne peut pas terminer le crawl.
- Onglet External : SEO Spider traite les sous-domaines comme externes et ne les crawle pas par défaut. Pour les inclure, active Crawl All Subdomains dans 1Configuration›2Spider›3Crawl.
- Le site exige-t-il des cookies ? Désactive-les dans le navigateur : si le problème apparaît, règle Cookie Storage sur « Session Only » dans 1Configuration›2Spider›3Advanced. Cela arrive quand SEO Spider est redirigé vers une URL qui pose un cookie, mais que le cookie n’est pas accepté.
Client Error (4xx)
Le serveur ne peut pas ou ne veut pas traiter la requête et refuse l’URL demandée à SEO Spider.

Que faire
- 403 Forbidden : si la page s’affiche dans le navigateur, essaie de choisir Chrome comme user agent (1Configuration›2User-Agent). Le site refuse probablement la page à SEO Spider pour des raisons de sécurité.

- 404 Not Found : le serveur indique que la page n’existe pas. Si rien ne change avec le user agent Chrome, le problème vient probablement du site. Si au contraire, avec Chrome, la page est renvoyée (ou tu la vois dans le navigateur) et le crawl démarre, le serveur bloquait notre user agent pour des raisons de sécurité.
- 429 Too Many Requests : trop de requêtes ont été envoyées au serveur sur une période donnée. Vois-tu le site dans le navigateur, ou affiche-t-il une erreur similaire ? Réduis la vitesse de crawl et/ou essaie un autre user agent, comme Chrome ou Googlebot. Si le site est sur Shopify, lis la section suivante.
Erreur serveur (5xx)
Le serveur n’a pas pu satisfaire une requête apparemment valide. On y trouve des réponses courantes comme 500 Internal Server Error, 502 Bad Gateway et 503 Service Unavailable.

Que faire
- Vois-tu le site dans le navigateur, ou est-il hors ligne ? Si la page s’affiche, passe le user agent sur Chrome (1Configuration›2User-Agent).
L’erreur 429 et Shopify
Si tu crawles une boutique Shopify, surtout un thème en staging ou une boutique pas encore publiée, il est fréquent de voir apparaître après quelques dizaines d’URL une longue série de 429 Too Many Requests. Shopify applique un rate limiting très agressif aux crawlers qu’il ne reconnaît pas, et réduire la vitesse de SEO Spider ne suffit souvent pas : le crawl devient très lent et les données restent incomplètes.
La solution officielle, ce sont les signatures pour les crawlers (crawler access). Shopify te permet de générer des signatures cryptographiques qui authentifient ton crawler sur la boutique : quand SEO Spider les envoie, Shopify le reconnaît comme un outil autorisé et ne le limite pas. Selon la documentation de Shopify, si le crawler reçoit des erreurs de rate limiting, c’est que la signature n’est pas valide.
Créer la signature sur Shopify
- Dans l’admin Shopify, va dans Online Store › Preferences.
- Dans la section Crawler access, clique sur Create signature.
- Donne à la signature un nom descriptif, par exemple « Screaming Frog staging ».
- Sélectionne le domaine connecté sur lequel tu l’utiliseras : chaque signature ne vaut que pour un domaine.
- Choisis l’expiration (trois mois maximum) et clique sur Create.
- Copie les valeurs de Signature-Input et Signature.
Selon Shopify, les principales caractéristiques des signatures sont :
- Authentification sécurisée : les signatures sont cryptographiques et ne peuvent pas être falsifiées.
- Expiration contrôlée : elles expirent automatiquement après la période choisie, trois mois maximum, et ne peuvent être ni renouvelées ni prolongées. Pour une nouvelle date, tu crées une nouvelle signature et mets à jour l’outil ; l’ancienne fonctionne jusqu’à son expiration d’origine.
- Gestion centralisée : tu les retrouves toutes dans Crawler access, où tu peux aussi recopier les valeurs si tu les as perdues.
- Nom personnalisé : t’aide à te rappeler pour quel outil ou projet tu l’as créée.
- Liée au domaine : elle ne fonctionne que sur le domaine associé.
Les signatures ne donnent pas accès au Checkout et ne sont pas nécessaires aux moteurs de recherche et aux LLM, qui indexent la boutique sans elles.
Configurer les en-têtes HTTP dans Screaming Frog
Chaque requête de SEO Spider doit contenir trois en-têtes HTTP. Va dans 1Configuration›2HTTP Header, clique sur Add pour chacun et saisis le nom et la valeur :
- Signature-Input : la valeur copiée depuis l’admin Shopify.
- Signature : la valeur copiée depuis l’admin Shopify.
- Signature-Agent :
"https://shopify.com", guillemets compris.
Le résultat ressemble à ceci. Les valeurs de Signature-Input et Signature sont ici purement indicatives : utilise toujours celles générées pour ta boutique.
Signature-Input: sig1=("@authority" "signature-agent");created=1760600000;expires=1768376000;keyid="…";alg="ed25519";tag="web-bot-auth"
Signature: sig1=:…valore-base64-copiato-da-shopify…:
Signature-Agent: "https://shopify.com"
Si tu continues à recevoir des erreurs 429, Shopify conseille de vérifier que :
- le format des en-têtes est correct, sans espaces ni caractères perdus au copier-coller ;
- les trois en-têtes sont envoyés avec chaque requête ;
- la signature n’a pas expiré (la date figure dans Crawler access) ;
- tu crawles bien le domaine associé à la signature, et pas un autre domaine ou le domaine myshopify.com.
Source : Shopify Help Center, Crawling your store.
Des questions sur Problèmes de crawl de SEO Spider?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
