

Problemas de rastreo de SEO Spider.
Descubre cómo gestionar posibles problemas de rastreo de SEO Spider.
Índice de la guía 5 secciones
●Brief01.Introducción02.Status Code 0: sin respuesta03.Códigos de estado HTTP04.El error 429 y ShopifyQué hacer cuando SEO Spider rastrea una sola página o se bloquea: las causas más frecuentes (robots.txt, DNS, timeout, conexión rechazada, errores 4xx y 5xx) y, para cada una, cómo resolverla. Con un apartado sobre el error 429 en las tiendas Shopify y las firmas para crawlers.
Introducción
A veces puede pasar que Screaming Frog rastree una sola página o que no rastree como esperabas.
En ese caso, lo primero que hay que revisar es el Status y el Status Code de los recursos devueltos, para identificar el problema y resolverlo.
Status Code 0: sin respuesta
Blocked by Robots.txt
Este filtro muestra todas las URL bloqueadas por el robots.txt del sitio, que impide al Spider rastrear esos recursos y, en consecuencia, que los buscadores los indexen.
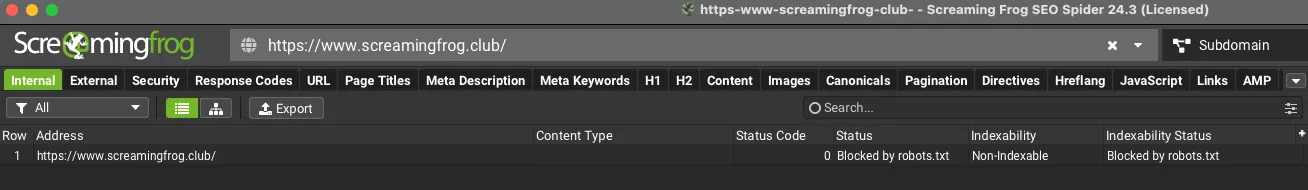
Cada «0» en la columna Status Code indica que el servidor no dio respuesta HTTP, mientras que la columna Status indica el motivo. En el ejemplo, el user agent del Spider fue bloqueado por el robots.txt con la directiva «disallow» y, al estar bloqueado, no puede ver la respuesta HTTP.
Qué hacer
Puedes configurar SEO Spider para ignorar el robots.txt desde 1Configuration›2robots.txt eligiendo Ignore robots.txt, o usar un robots.txt personalizado. Por defecto, Screaming Frog respeta las reglas «disallow» del archivo robots.txt.
Para profundizarRastrear sitios en staging.Robots.txt, autenticación, noindex y nofollow: cómo rastrear un sitio protegido antes de publicarlo.Leer la guíaDNS Lookup Failed
El sitio no se ha encontrado, por un error al escribir el dominio o por falta de conexión a la red.

Qué hacer
Comprueba que el dominio esté bien escrito y que el sitio se vea en tu navegador. Si tampoco se ve en el navegador, puede haber problemas de conexión; si se abre bien, comprueba si un antivirus o un cortafuegos está bloqueando SEO Spider.
Connection Timeout
Screaming Frog pidió la respuesta HTTP al servidor, pero no la recibió en 20 segundos. Para solucionarlo puedes aumentar el Response Timeout en la configuración o reducir la velocidad del Spider, para no sobrecargar el servidor y darle más tiempo para responder.

Qué hacer
- Comprueba los tiempos de carga del sitio en el navegador: si son muy largos, aumenta el timeout en 1Configuration›2Spider›3Advanced y reduce la velocidad del crawler en 1Configuration›2Speed para aliviar el servidor.
- Comprueba si puedes rastrear otros sitios con Screaming Frog. Si el problema es general, puede deberse al antivirus o al cortafuegos: prueba a crear una excepción para Screaming Frog.
- Si tampoco así se resuelve, probablemente hay un problema de red o local. Comprueba, por ejemplo, si el proxy está activado en 1File›2Settings›3Proxy: si lo está, prueba a desactivarlo y vuelve a lanzar el rastreo.
Connection Refused
Aparece cuando el intento de conexión de SEO Spider ha sido rechazado en algún punto entre tu equipo y el sitio web.

Qué hacer
- ¿Puedes rastrear otros sitios web? Si es así, revisa el antivirus y el cortafuegos y crea una excepción para el Spider; si el problema afecta también a otros sitios, comprueba que no haya un problema de red o de tu ordenador.
- ¿Ves la página en el navegador o devuelve un error parecido? Si la página se ve, cambia el user agent a Chrome en 1Configuration›2User-Agent.
No Response
SEO Spider tiene problemas para crear conexiones o recibir respuestas. Una causa habitual es el proxy.

Qué hacer
Lo primero es revisar el proxy (1File›2Settings›3Proxy): prueba a desactivarlo. Si no está bien configurado, SEO Spider podría no lograr enviar o recibir las peticiones.
Códigos de estado HTTP
Success (2xx)
La URL solicitada se recibió, entendió, aceptó y procesó correctamente. Si aun así el rastreo se detiene en la primera página, estas son las comprobaciones que te sugiero.
Qué hacer
- ¿La página tiene la directiva meta robots «nofollow» (o en la cabecera HTTP), o todos sus enlaces llevan rel=“nofollow”? En ese caso configura SEO Spider para seguir los enlaces Internal/External nofollow en 1Configuration›2Spider›3Crawl: por defecto, Screaming Frog respeta los «nofollow».
- ¿El sitio tiene enlaces en JavaScript? Prueba a desactivar JavaScript y a ver las páginas en el navegador. Si los enlaces desaparecen, activa el renderizado JavaScript en 1Configuration›2Spider›3Rendering. Por defecto, SEO Spider solo rastrea los enlaces
<a href="">,<img src="">y<link rel="canonical">del código fuente HTML y no lee el DOM. - Revisa la sección 1Configuration›2Spider›3Limits, en particular «Limit Crawl Depth» y «Limit Crawl Total»: si están en 0 o 1, SEO Spider rastrea una sola URL.
- ¿El sitio requiere cookies? Prueba a ver la página con las cookies desactivadas en el navegador: puede que a SEO Spider se le sirva una página distinta, sin enlaces. Para solucionarlo, pon Cookie Storage en «Session Only» en 1Configuration›2Spider›3Advanced.
- ¿Qué hay en la columna Content Type? Si está vacía, activa el renderizado JavaScript y vuelve a lanzar el rastreo. Ocurre cuando la cabecera HTTP no especifica el tipo de contenido y SEO Spider no sabe si la URL es una imagen, un PDF o una página HTML, así que no la analiza en busca de más enlaces. Con el renderizado activo, la herramienta también comprueba si hay un
<meta http-equiv>en el<head>. - ¿Hay restricciones de edad? Prueba a poner Googlebot como user agent (1Configuration›2User-Agent): el servidor podría servir el HTML a los bots de los buscadores sin pedir la edad.
Redirection (3xx)
Se ha detectado una redirección, como una 301 o una 302. Lo ideal es que cada enlace interno apunte a una respuesta 200 y evite pasos extra al Spider, para proteger el Crawl Budget.

Qué hacer
- Revisa el destino de la redirección en los outlinks de la URL. Si hay un bucle, SEO Spider no puede completar el rastreo.
- Pestaña External: SEO Spider trata los subdominios como externos y por defecto no los rastrea. Para incluirlos, activa Crawl All Subdomains en 1Configuration›2Spider›3Crawl.
- ¿El sitio requiere cookies? Prueba a desactivarlas en el navegador: si ves el problema, pon Cookie Storage en «Session Only» en 1Configuration›2Spider›3Advanced. Ocurre cuando SEO Spider es redirigido a una URL que instala una cookie, pero la cookie no se acepta.
Client Error (4xx)
El servidor no puede o no quiere procesar la petición y niega a SEO Spider la URL solicitada.

Qué hacer
- 403 Forbidden: si la página se ve en el navegador, prueba a poner Chrome como user agent (1Configuration›2User-Agent). Probablemente el sitio niega la página a SEO Spider por motivos de seguridad.

- 404 Not Found: el servidor indica que la página no existe. Si con el user agent Chrome tampoco cambia nada, el problema probablemente es del sitio. Si en cambio con Chrome la página se devuelve (o la ves en el navegador) y el rastreo arranca, el servidor estaba bloqueando nuestro user agent por motivos de seguridad.
- 429 Too Many Requests: se han hecho demasiadas peticiones al servidor en un periodo de tiempo. ¿Ves el sitio en el navegador o muestra un error parecido? Reduce la velocidad de rastreo y/o prueba otro user agent, como Chrome o Googlebot. Si el sitio está en Shopify, lee el siguiente apartado.
Error de servidor (5xx)
El servidor no pudo atender una petición aparentemente válida. Aquí entran respuestas habituales como 500 Internal Server Error, 502 Bad Gateway y 503 Service Unavailable.

Qué hacer
- ¿Ves el sitio en el navegador o está caído? Si la página se ve, cambia el user agent a Chrome (1Configuration›2User-Agent).
El error 429 y Shopify
Si rastreas una tienda Shopify, sobre todo un tema en staging o una tienda aún no publicada, es fácil que tras unas decenas de URL aparezca una larga serie de 429 Too Many Requests. Shopify aplica un rate limiting muy agresivo a los crawlers que no reconoce, y reducir la velocidad de SEO Spider a menudo no basta: el rastreo se vuelve lentísimo y los datos quedan incompletos.
La solución oficial son las firmas para crawlers (crawler access). Shopify te permite generar firmas criptográficas que autentican tu crawler en la tienda: cuando SEO Spider las envía, Shopify lo reconoce como una herramienta autorizada y no lo limita. Según la documentación de Shopify, si el crawler recibe errores de rate limiting es que la firma no es válida.
Crear la firma en Shopify
- En el admin de Shopify ve a Online Store › Preferences.
- En la sección Crawler access haz clic en Create signature.
- Ponle a la firma un nombre descriptivo, por ejemplo «Screaming Frog staging».
- Selecciona el dominio conectado en el que la usarás: cada firma vale para un solo dominio.
- Elige la caducidad (como máximo tres meses) y haz clic en Create.
- Copia los valores de Signature-Input y Signature.
Según Shopify, las principales características de las firmas son:
- Autenticación segura: las firmas son criptográficas y no se pueden falsificar.
- Caducidad controlada: caducan automáticamente tras el periodo elegido, como máximo tres meses, y no se pueden renovar ni prolongar. Para una nueva fecha creas una firma nueva y actualizas la herramienta; la antigua funciona hasta su caducidad original.
- Gestión centralizada: las encuentras todas en Crawler access, donde también puedes volver a copiar los valores si los has perdido.
- Nombre personalizado: te ayuda a recordar para qué herramienta o proyecto la creaste.
- Vinculada al dominio: solo funciona en el dominio asociado.
Las firmas no dan acceso al Checkout y no las necesitan los buscadores ni los LLM, que indexan la tienda sin ellas.
Configurar las cabeceras HTTP en Screaming Frog
Cada petición de SEO Spider debe incluir tres cabeceras HTTP. Ve a 1Configuration›2HTTP Header, haz clic en Add para cada una e introduce nombre y valor:
- Signature-Input: el valor copiado del admin de Shopify.
- Signature: el valor copiado del admin de Shopify.
- Signature-Agent:
"https://shopify.com", comillas incluidas.
El resultado se parece a esto. Los valores de Signature-Input y Signature son solo de ejemplo: usa siempre los generados para tu tienda.
Signature-Input: sig1=("@authority" "signature-agent");created=1760600000;expires=1768376000;keyid="…";alg="ed25519";tag="web-bot-auth"
Signature: sig1=:…valore-base64-copiato-da-shopify…:
Signature-Agent: "https://shopify.com"
Si sigues recibiendo errores 429, Shopify sugiere comprobar que:
- el formato de las cabeceras sea correcto, sin espacios ni caracteres perdidos al copiar y pegar;
- las tres cabeceras se envíen con cada petición;
- la firma no haya caducado (la fecha está en Crawler access);
- estés rastreando justo el dominio asociado a la firma, no otro dominio ni el dominio myshopify.com.
¿Dudas sobre Problemas de rastreo de SEO Spider?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
