

Come Debuggare Html Invalido nell’Head?.
Scopri come debuggare l'HTML Invalido nell'Head?
Come trovare gli elementi HTML non validi nell'head che fanno chiudere l'head in anticipo a Google, che poi ignora i metadati successivi. Vedi quali elementi sono ammessi, come usare la tab Validation di SEO Spider, e come verificare gli errori con l’HTML renderizzato e Search Console.
Cos’è l’Invalid HTML nell’head
Nel 2026, l’ottimizzazione SEO richiede un controllo sempre più rigoroso del codice HTML, in particolare della sezione <head>, vero fulcro della trasmissione dei metadati essenziali a motori di ricerca e AI systems. La qualità e la validità del contenuto nell’<head> non sono più un dettaglio tecnico: diventano fondamentali per garantire che titoli, descrizioni, canoniche e marcatori SEO non vengano ignorati o compromessi, specialmente quando strumenti d’analisi avanzati come Screaming Frog SEO Spider mettono in luce errori che possono arrestare la corretta interpretazione del documento.
La guida “Debuggare elementi HTML nel <head>” delinea con precisione il pericolo di includere tag non conformi come <img>, <svg>, <iframe> o <div> all’interno dell'<head>, che inducono Google a interpretare prematuramente la sua chiusura, ignorando così tutto ciò che segue.
In un contesto in cui l’IA e i sistemi di ranking evoluti privilegiano contenuti intelligenti, coerenti e validi, e dove tendenze come i rich results, i featured snippets e la ricerca basata su entità diventano determinanti, non basta predisporre contenuti di valore: serve che siano anche tecnicamente leggibili e perfettamente strutturati.
Questo articolo, quindi, non è solo un tutorial tecnico: è una risorsa fondamentale per chiunque voglia garantire massima efficacia SEO, accessibilità e interpretazione corretta da parte di search engine e sistemi di intelligenza artificiale. Scoprirai come utilizzare Screaming Frog non solo per identificare pagine con errori nell’<head>, ma anche per diagnosi efficaci (crawl, tab “Validation”, HTML raw vs rendered, strumenti Search Console) e reali correzioni mirate.
Questo tutorial spiega come utilizzare Screaming Frog SEO Spider per identificare elementi HTML non validi nell’intestazione, visualizzare quali metadati potrebbero essere influenzati negativamente e come risolvere il problema che sta causando l’errore.
Utilizzare HTML valido per i metadati di una pagina assicura che i Motori di Ricerca, come Google, siano in grado di utilizzarlo per indicizzare le singole pagine.
Anche se i Motori di Ricerca cercheranno di comprendere il markup anche quando ci sono errori, alcuni elementi all’interno dell’intestazione possono causare criticità nella gestione delle informazioni da parte dello Spider.
Se vengono utilizzati elementi HTML non validi all’interno dell’intestazione (“<head>”), Google considererà che l’intestazione debba essere chiusa e avvierà il body nella sua analisi.
Ciò significa che eventuali metadati che appaiono dopo l’elemento HTML non valido potrebbero essere ignorati da Google.
Elementi HTML validi nell’head
L’head dovrebbe contenere solamente i seguenti elementi Html:
- title
- meta
- link
- script
- style
- base
- noscript
- template
Altri elementi potrebbero causare delle criticità di scansione e indicizzazione:
- iframe
- img
- svg
- div
- noscript che contiene un “img”.
In linea generale va anche considerato che se elementi <body> precedono direttamente l’elemento <head> potrebbero influenzare tutti i metadati nell’intestazione.
Ad esempio, un tag <div> fuori posto che precede l’apertura dell’elemento <html> farà sì che Google apra e chiuda automaticamente un elemento <head> vuoto, il che significa che tutti i metadati saranno nel <body> e potenzialmente potrebbero essere ignorati.
Secondo le indicazioni di Google se, nonostante queste indicazioni, ci sia la necessità di inserire elementi “invalidi” nell’Head, gli stessi dovranno essere inseriti dopo gli elementi che devono essere considerati dallo Spider.
Identificare l’Invalid HTML con Screaming Frog
Trovare elementi HTML non validi nell’intestazione, o precedenti ad essa, su larga scala in un sito web è difficile, ed è qui che Screaming Frog può aiutare a fare il grosso del lavoro.
Il Seo Spider segnalerà eventuali pagine con elementi <html> non validi che potrebbero essere problematici e qualsiasi meta tag come ad esempio titoli, canonicals o meta robots che sono al di fuori dell’intestazione.
Crawl del sito web
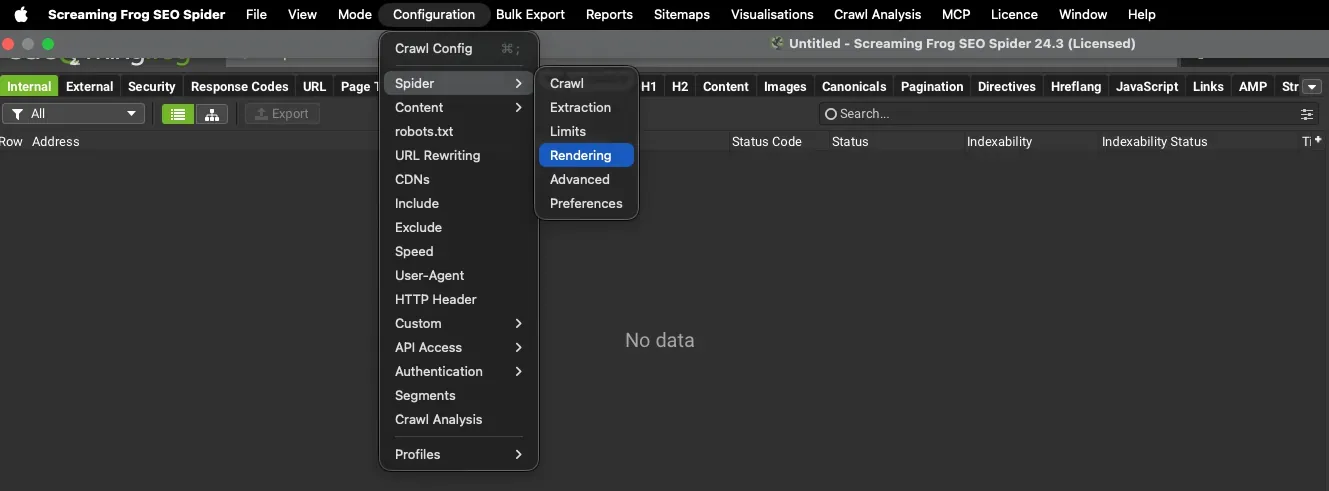
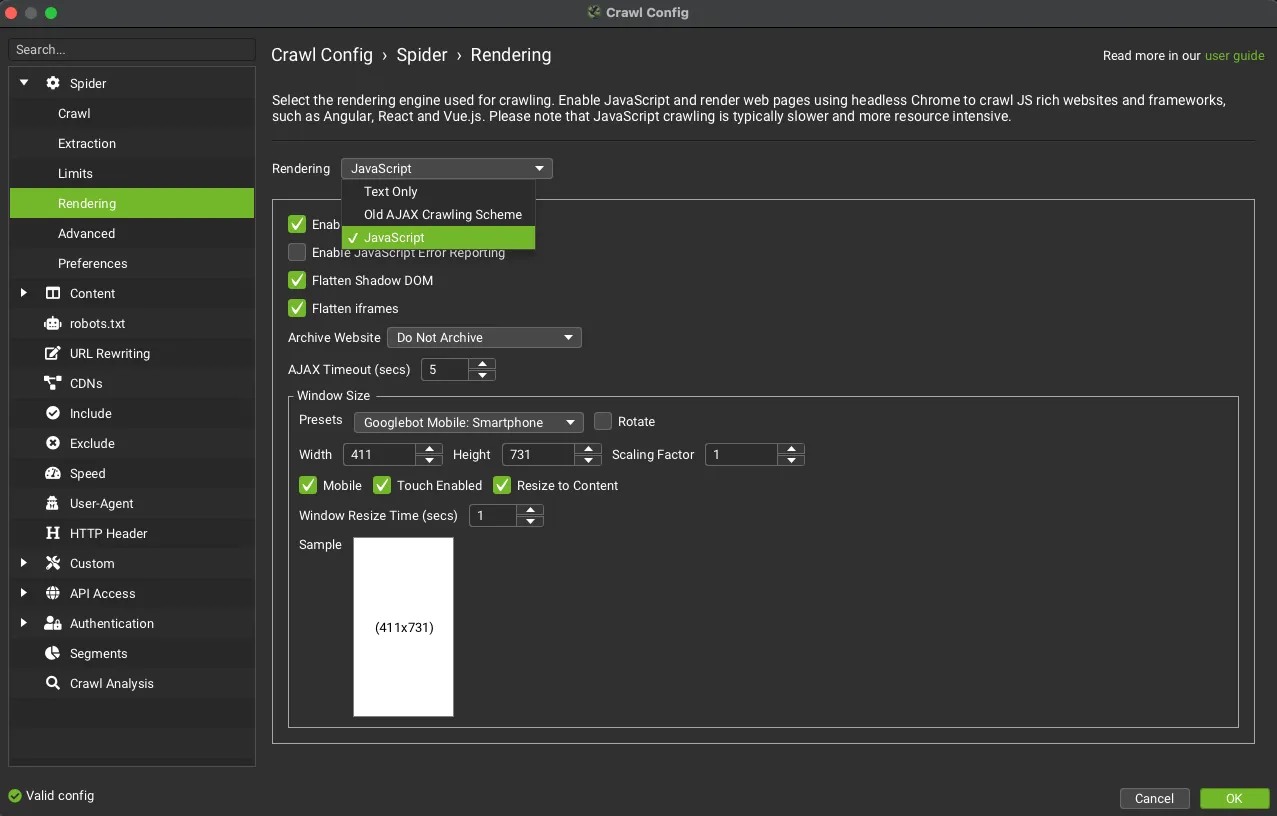
La prima fase è molto semplice: non devi configurare nulla in SEO Spider tranne il rendering JavaScript, per analizzare anche gli elementi inseriti dopo l’elaborazione degli script. Lo trovi in 1Configuration›2Spider›3Rendering.
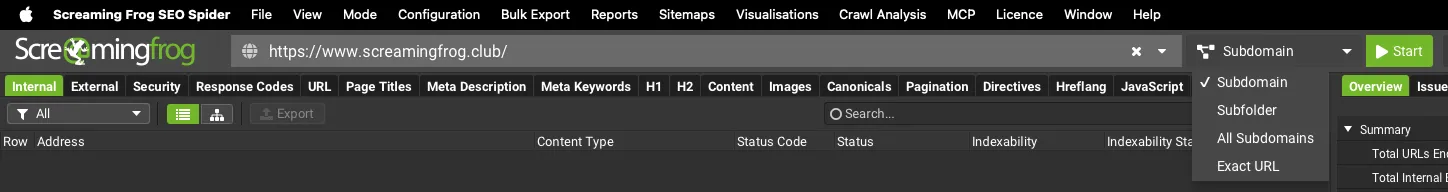
Poi inserisci il dominio o sottodominio da analizzare e avvia la scansione.
Analisi della tab Validation
Durante la scansione potrai già vedere i dati in “Real time” o aspettare la fine della scansione per un quadro completo degli URL che presentano questo scenario.
La tab di riferimento si chiama 1Validation e comprende diversi filtri:
- Invalid HTML Elements in Head: pagine con elementi HTML non validi all’interno dell’intestazione. Quando viene utilizzato un elemento non valido nell’intestazione, Google presume la fine dell’elemento <head> e ignora eventuali elementi che compaiono dopo l’elemento non valido. Ciò significa che gli elementi critici dell’intestazione che compaiono dopo l’elemento non valido non saranno visti.
- “<body>” Element Preceding “<html>”: URL che hanno un elemento body che precede l’apertura dell’elemento html. I browser e Googlebot presumono automaticamente l’inizio del corpo e generano un elemento head vuoto prima di esso. Ciò significa che l’elemento head previsto e i suoi metadati saranno visti nel corpo e ignorati.
- “<head>” Not first in “<html>” Element: l’elemento <head> dovrebbe essere il primo elemento nel codice <html>. I browser e Googlebot genereranno automaticamente un elemento <head> se non lo trovano come primo elemento.
- Missing “<head>” Tag: pagine che mancano di un elemento <head> nell’HTML.
- Multiple “<head>” Tags: pagine con più elementi <head> nell’HTML.
- Missing “<body>” Tag.
- Multiple “<body>” Tags.
- HTML Document Over 2MB.
- Resource Over 2MB.
- High Carbon Rating.
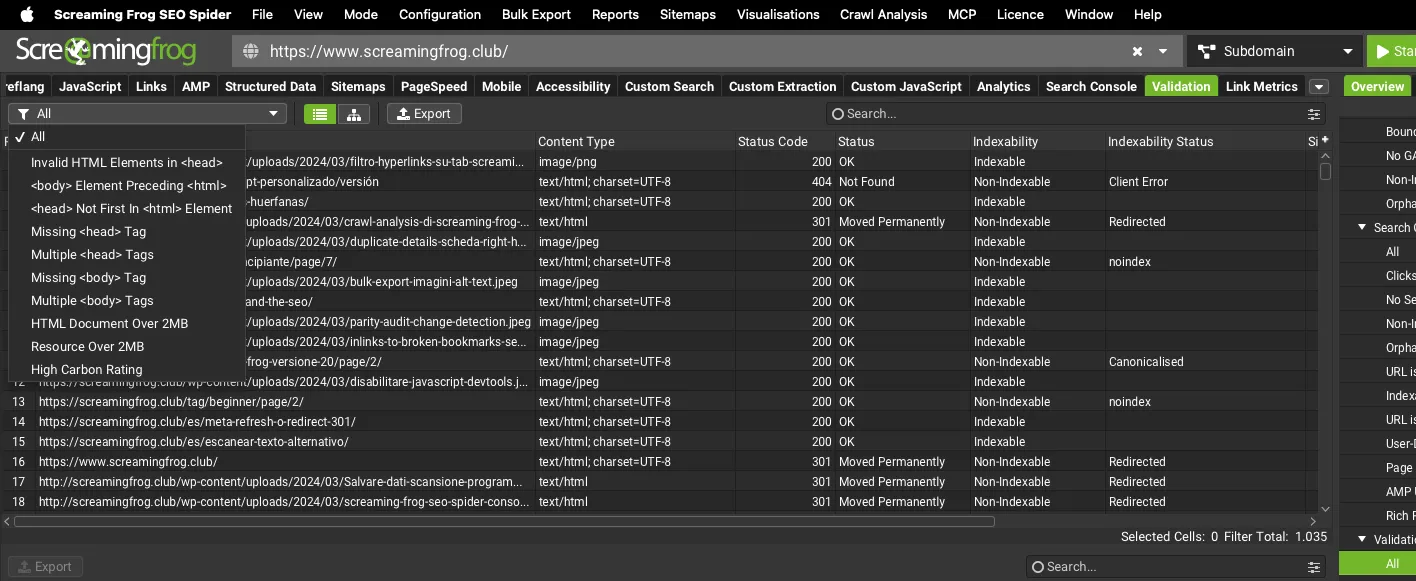
L’analisi granulare la trovi nella tab dedicata; per una visione d’insieme puoi monitorare i dati nella sidebar laterale, dove nella tab 1Issues ogni problema di validazione è etichettato con priorità alta.
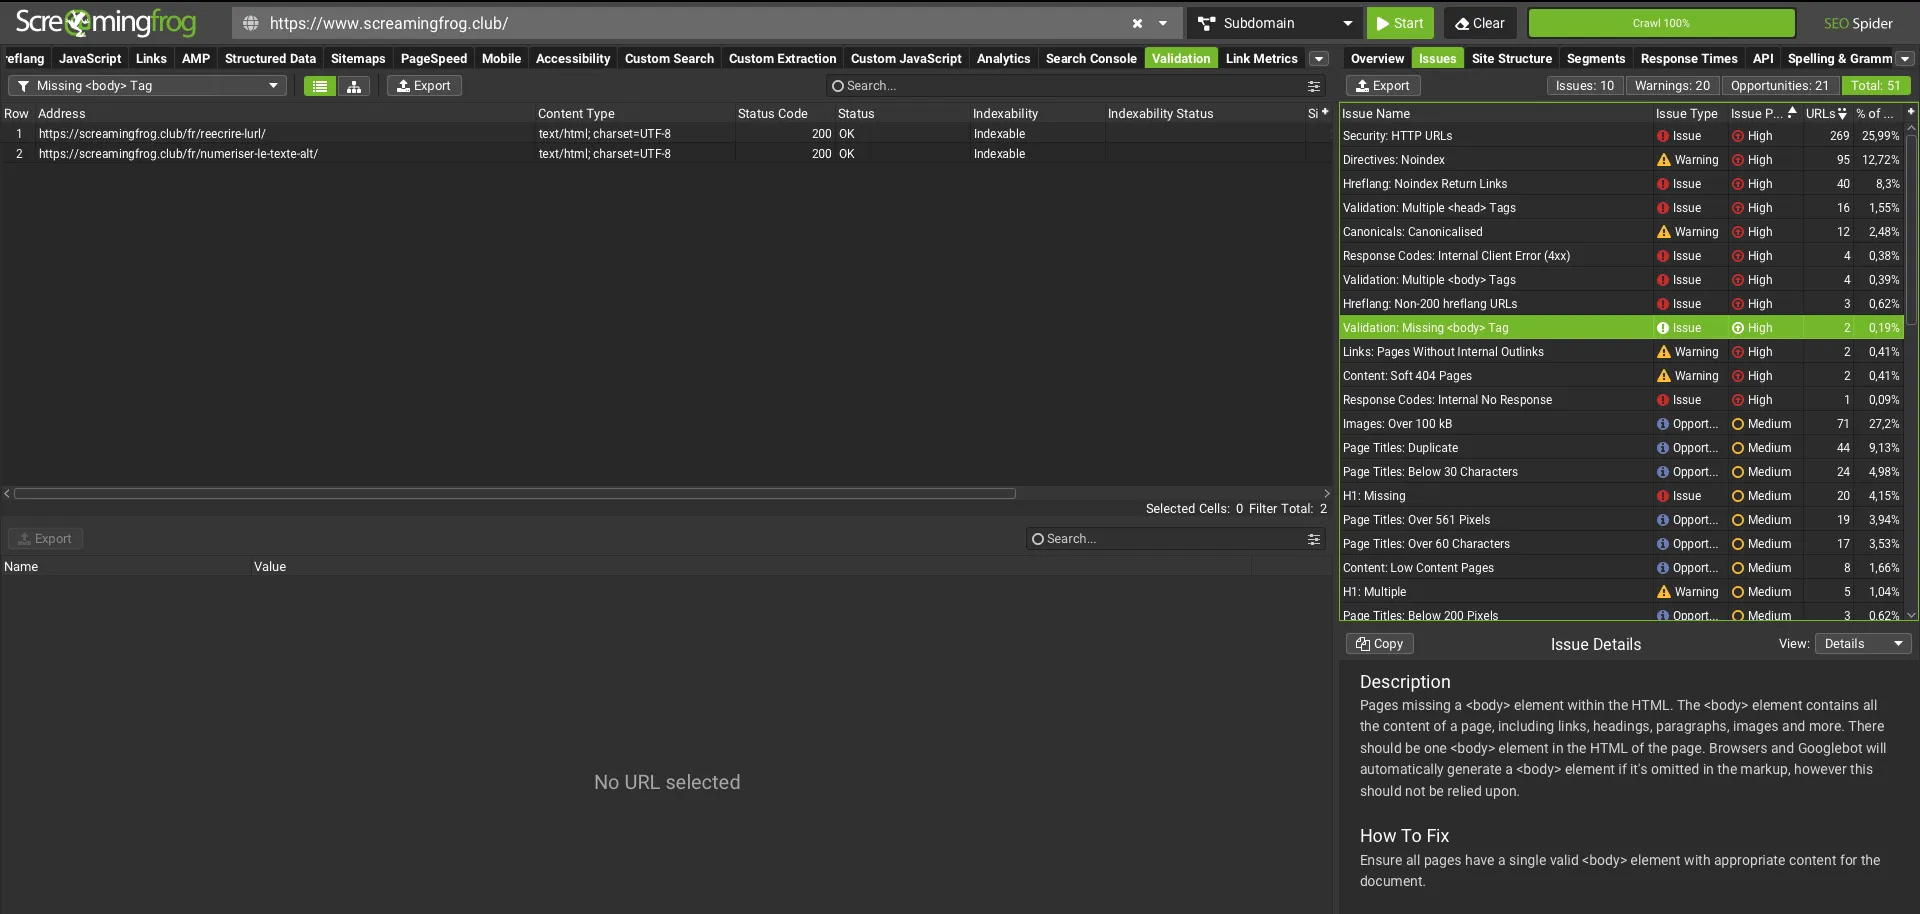
Debug dell’head
Una volta scoperti tutti gli URL interessati da questa criticità sarà possibile analizzarli in modo scrupoloso in tre modi:
- Raw HTML: analisi dell’Head nell’HTML grezzo attraverso tasto destro del mouse e scelta dell’opzione “Visualizza sorgente” della pagina. In questo caso l’analisi risulterà parziale perché alcuni elementi potrebbero essere inseriti dai JavaScript.
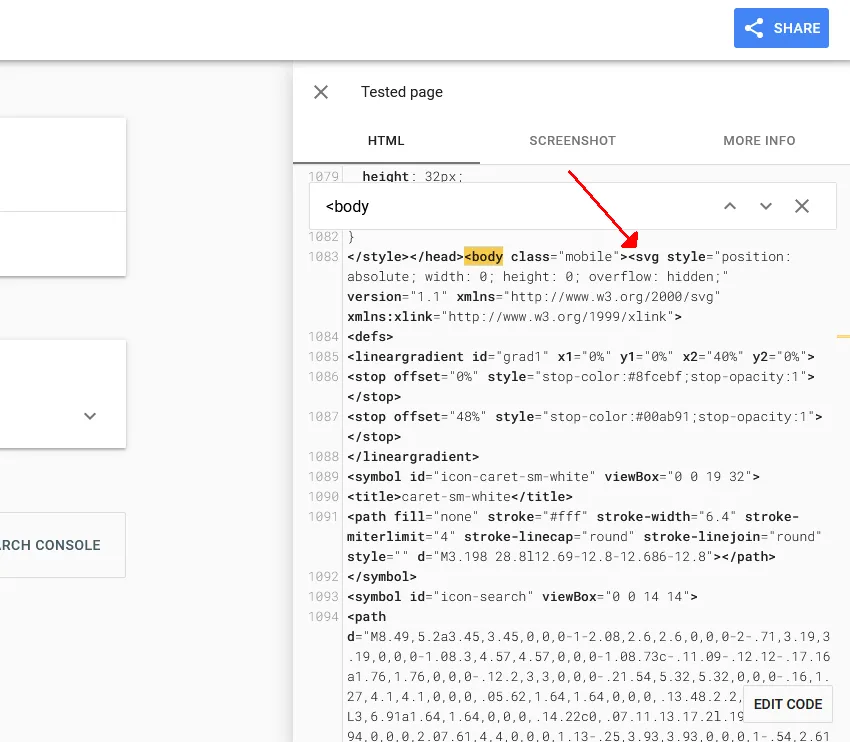
- Rendered HTML: analisi della pagina dopo il rendering dei JavaScript. In questo caso sarà sufficiente utilizzare “Ispeziona elemento” di Chrome e consultare la tab “Elements”.
- Search Console: puoi anche verificare la presenza di elementi non validi nell’Head controllando gli URL con lo strumento “Controllo URL” di Search Console.
Esempio: canonical ignorato da Google
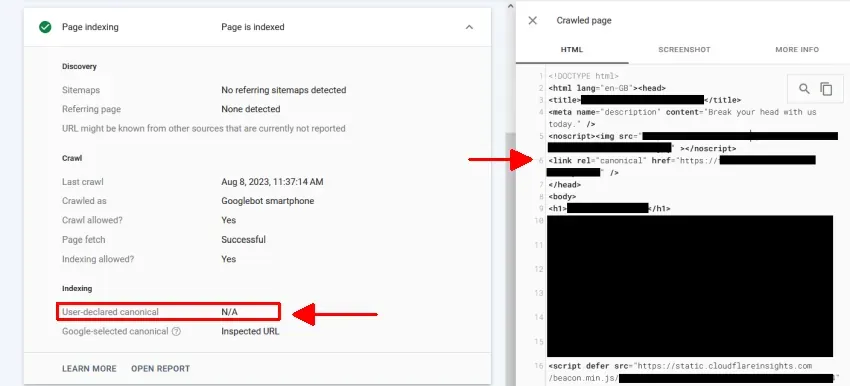
A conferma di quanto sia importante l’argomento per la SEO, vediamo un esempio.
L’HTML renderizzato sul lato destro sembra corretto, ma il “Canonical dichiarato dall’utente” viene ignorato a causa del tag <noscript> che contiene un’immagine sopra di esso, chiudendo l’intestazione.
Hai domande su Come Debuggare Html Invalido nell’Head?
Le guide nascono dai progetti di tutti i giorni. Se qualcosa non torna nel tuo crawl, o vuoi applicare questa procedura al tuo sito, scrivimi.
 Autore.Raffaele Visintin.Search & Strategic Marketing Advisor
