

Comment déboguer le HTML invalide dans le head ?.
Découvre comment déboguer le HTML invalide dans le head
Comment repérer les éléments HTML non valides dans le head qui font fermer le head trop tôt à Google, qui ignore ensuite les métadonnées suivantes. Vois quels éléments sont admis, comment utiliser l’onglet Validation de SEO Spider et comment vérifier les erreurs avec le HTML rendu et la Search Console.
Qu’est-ce que le HTML invalide dans le head
En 2026, le SEO exige un contrôle de plus en plus rigoureux du code HTML, en particulier de la section <head>, qui transmet les métadonnées essentielles aux moteurs de recherche et aux systèmes d’IA. La qualité et la validité du contenu du <head> ne sont plus un détail technique : elles sont essentielles pour que titles, descriptions, canonicals et balises SEO ne soient pas ignorés ou compromis, surtout quand des outils avancés comme Screaming Frog SEO Spider révèlent des erreurs qui empêchent une bonne interprétation du document.
Ce guide pour déboguer les éléments HTML du <head> décrit précisément le danger d’y inclure des balises non conformes comme <img>, <svg>, <iframe> ou <div> : Google considère alors que le head est fermé prématurément et ignore tout ce qui suit.
À l’heure où l’IA et les systèmes de classement avancés privilégient des contenus intelligents, cohérents et valides, et où les résultats enrichis, les featured snippets et la recherche par entités deviennent décisifs, il ne suffit pas d’avoir des contenus de valeur : ils doivent aussi être techniquement lisibles et parfaitement structurés.
Cet article n’est donc pas qu’un tutoriel technique : c’est une ressource essentielle pour garantir une efficacité SEO maximale, l’accessibilité et une bonne interprétation par les moteurs et les systèmes d’IA. Tu verras comment utiliser Screaming Frog non seulement pour repérer les pages avec des erreurs dans le <head>, mais aussi pour un diagnostic efficace (crawl, onglet « Validation », HTML brut vs rendu, outils de la Search Console) et des corrections ciblées.
Ce tutoriel explique comment utiliser Screaming Frog SEO Spider pour repérer les éléments HTML non valides dans le head, voir quelles métadonnées peuvent être affectées et corriger la cause de l’erreur.
Utiliser du HTML valide pour les métadonnées d’une page garantit que les moteurs comme Google peuvent s’en servir pour indexer chaque page.
Même si les moteurs essaient de comprendre le balisage malgré les erreurs, certains éléments du head peuvent poser des problèmes dans la façon dont le robot traite les informations.
Si des éléments HTML non valides sont utilisés dans le head (« <head> »), Google considère que le head est terminé et commence le body dans son analyse.
Les métadonnées qui apparaissent après l’élément non valide peuvent donc être ignorées par Google.
Éléments HTML valides dans le head
Le head ne devrait contenir que ces éléments HTML :
- title
- meta
- link
- script
- style
- base
- noscript
- template
D’autres éléments peuvent poser des problèmes de crawl et d’indexation :
- iframe
- img
- svg
- div
- un noscript qui contient une « img ».
De manière générale, garde aussi en tête que des éléments du <body> placés avant l’élément <head> peuvent affecter toutes les métadonnées du head.
Par exemple, une balise <div> mal placée avant l’ouverture de l’élément <html> fera que Google ouvre et ferme automatiquement un <head> vide : toutes les métadonnées se retrouvent dans le <body> et peuvent être ignorées.
D’après Google, si tu dois malgré tout placer des éléments « invalides » dans le head, ils doivent venir après les éléments que le robot doit prendre en compte.
Repérer le HTML invalide avec Screaming Frog
Trouver à grande échelle les éléments HTML non valides dans le head, ou avant lui, est difficile : c’est là que Screaming Frog fait le gros du travail.
SEO Spider signale les pages avec des éléments <html> non valides potentiellement problématiques et toutes les balises meta, comme les titles, canonicals ou meta robots, situées hors du head.
Crawl du site
La première étape est très simple : il n’y a rien à configurer dans SEO Spider sauf le rendu JavaScript, pour analyser aussi les éléments insérés après l’exécution des scripts. Tu le trouves dans 1Configuration›2Spider›3Rendering.
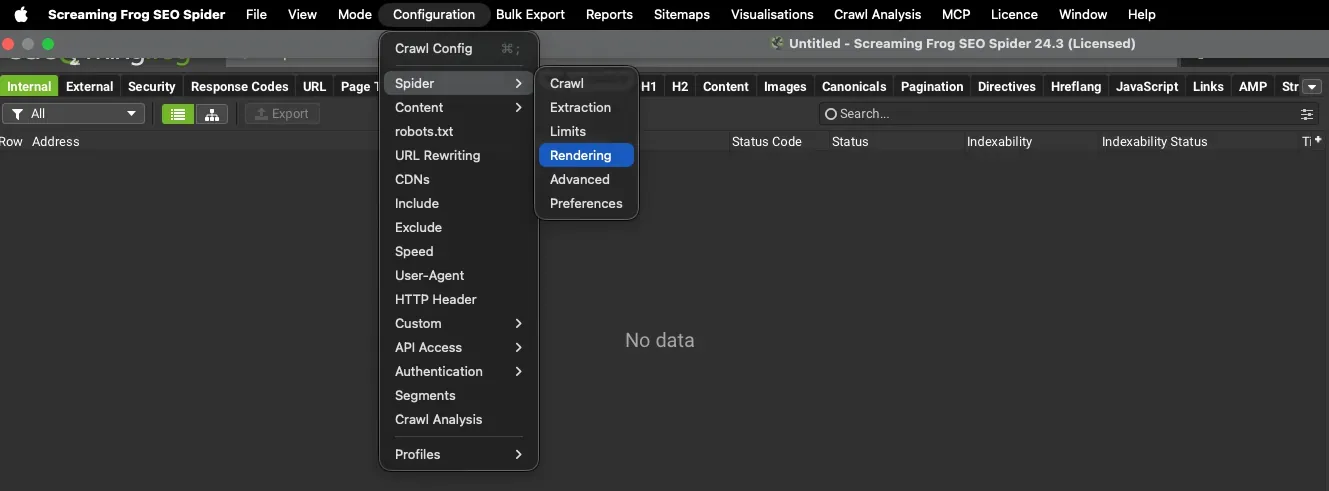
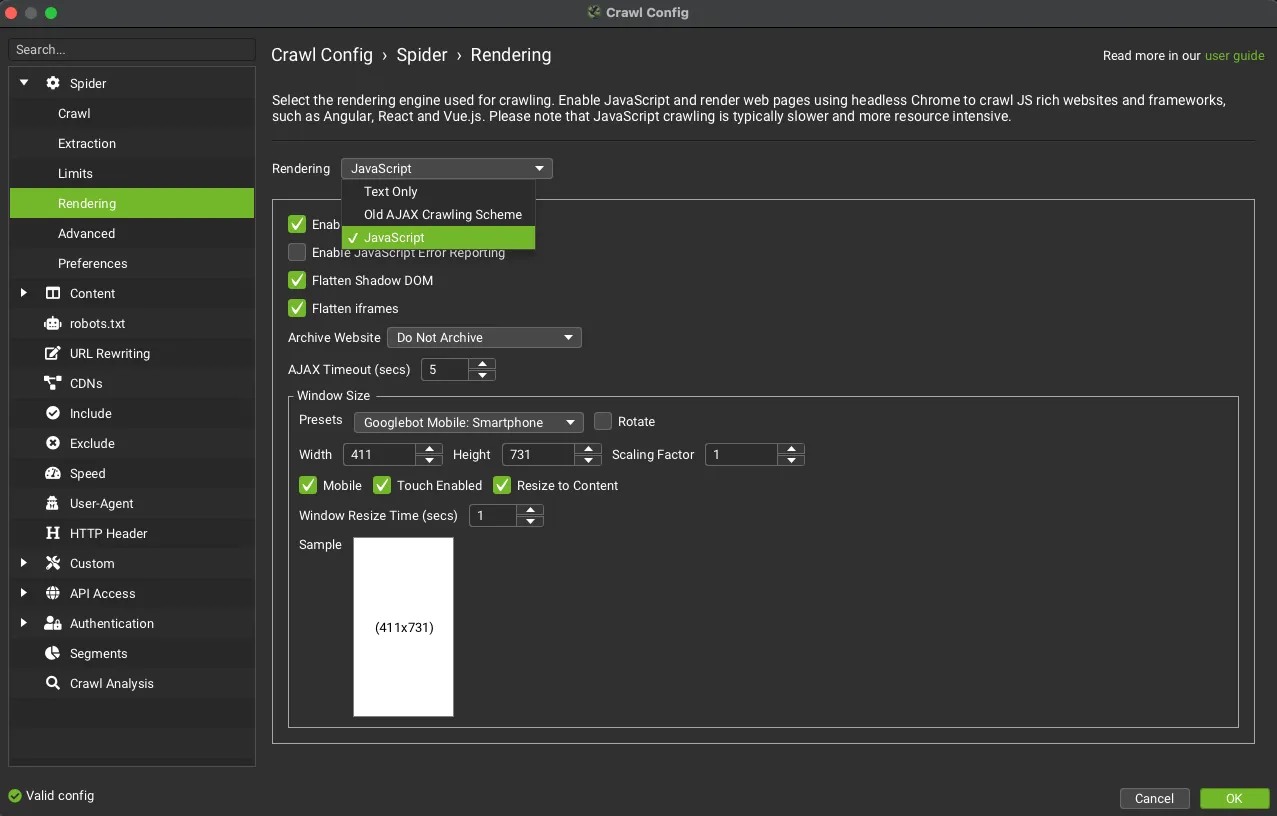
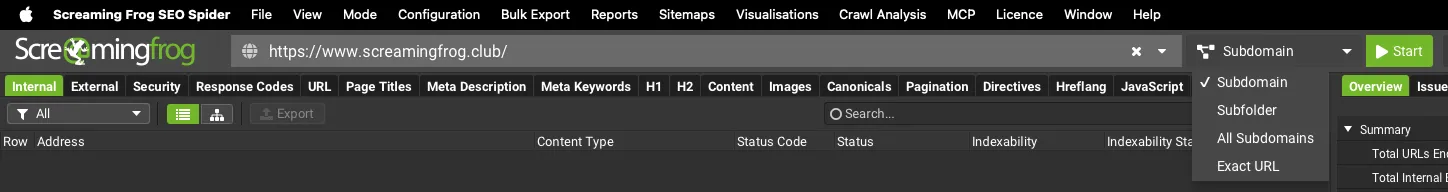
Saisis ensuite le domaine ou le sous-domaine à analyser et lance le crawl.
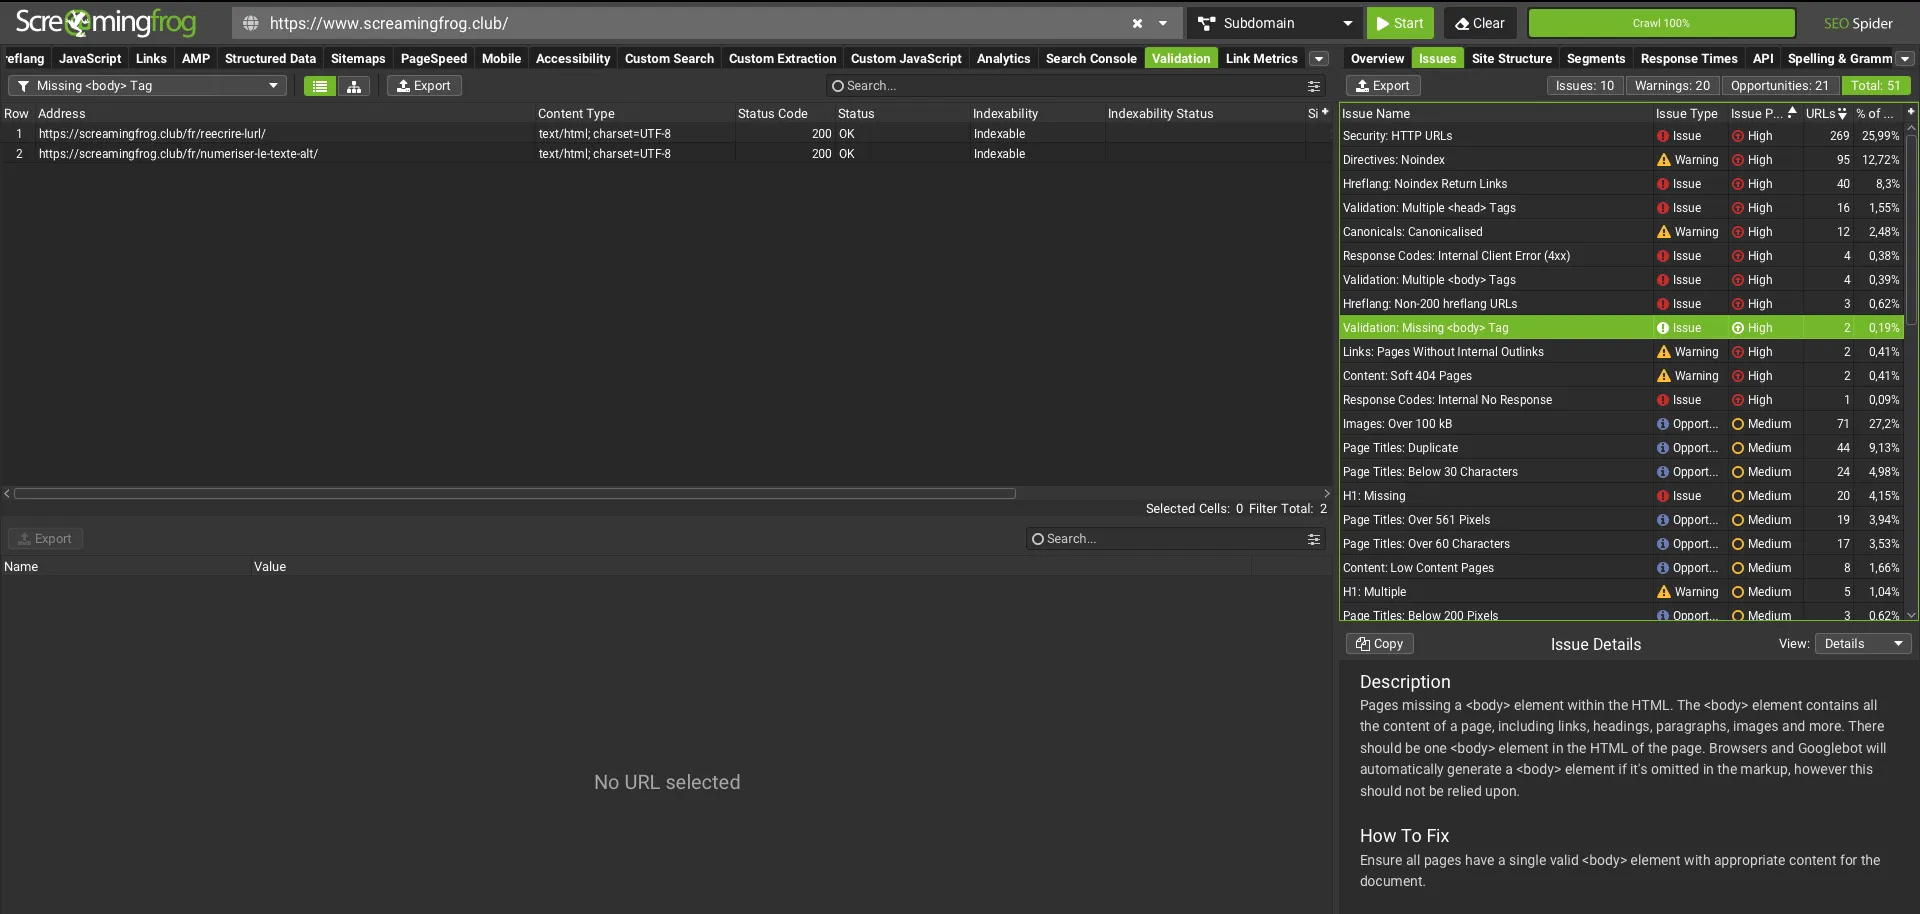
Analyse de l’onglet Validation
Pendant le crawl, tu vois déjà les données en temps réel, ou tu peux attendre la fin pour un tableau complet des URL concernées.
L’onglet de référence s’appelle 1Validation et comprend plusieurs filtres :
- Invalid HTML Elements in Head : les pages avec des éléments HTML non valides dans le head. Quand un élément non valide est utilisé dans le head, Google considère que l’élément <head> est terminé et ignore tout ce qui suit. Les éléments critiques placés après ne seront donc pas vus.
- « <body> » Element Preceding « <html> » : les URL avec un élément body avant l’ouverture de l’élément html. Navigateurs et Googlebot considèrent automatiquement que le body a commencé et génèrent un head vide avant lui. Le head prévu et ses métadonnées se retrouvent dans le body et sont ignorés.
- « <head> » Not First in « <html> » Element : l’élément <head> devrait être le premier du <html>. Navigateurs et Googlebot génèrent automatiquement un <head> s’il n’est pas en premier.
- Missing « <head> » Tag : les pages sans élément <head> dans le HTML.
- Multiple « <head> » Tags : les pages avec plusieurs éléments <head>.
- Missing « <body> » Tag.
- Multiple « <body> » Tags.
- HTML Document Over 2MB.
- Resource Over 2MB.
- High Carbon Rating.
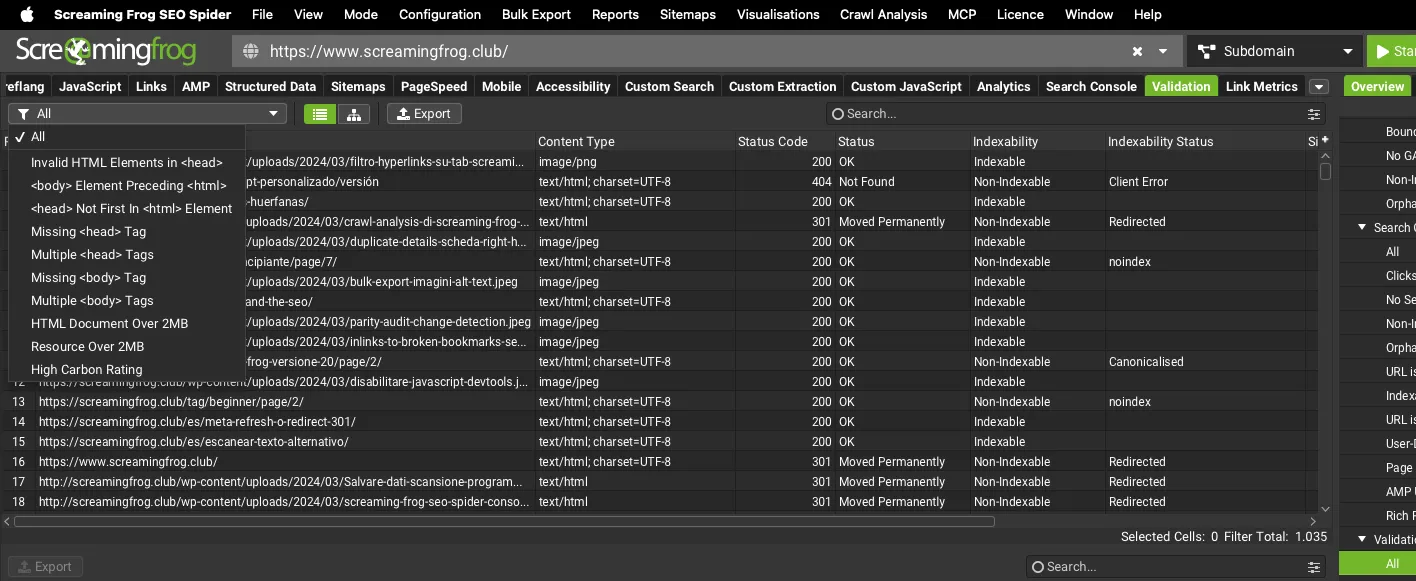
L’analyse détaillée se fait dans l’onglet dédié ; pour une vue d’ensemble, suis les données dans la barre latérale, où dans l’onglet 1Issues chaque problème de validation est classé en priorité haute.
Déboguer le head
Une fois toutes les URL concernées repérées, tu peux les analyser en détail de trois façons :
- HTML brut : analyse du head dans le HTML brut avec un clic droit et « Afficher le code source de la page ». L’analyse sera partielle, car certains éléments peuvent être insérés par JavaScript.
- HTML rendu : analyse de la page après le rendu du JavaScript. Il suffit d’utiliser « Inspecter » dans Chrome et de consulter l’onglet « Elements ».
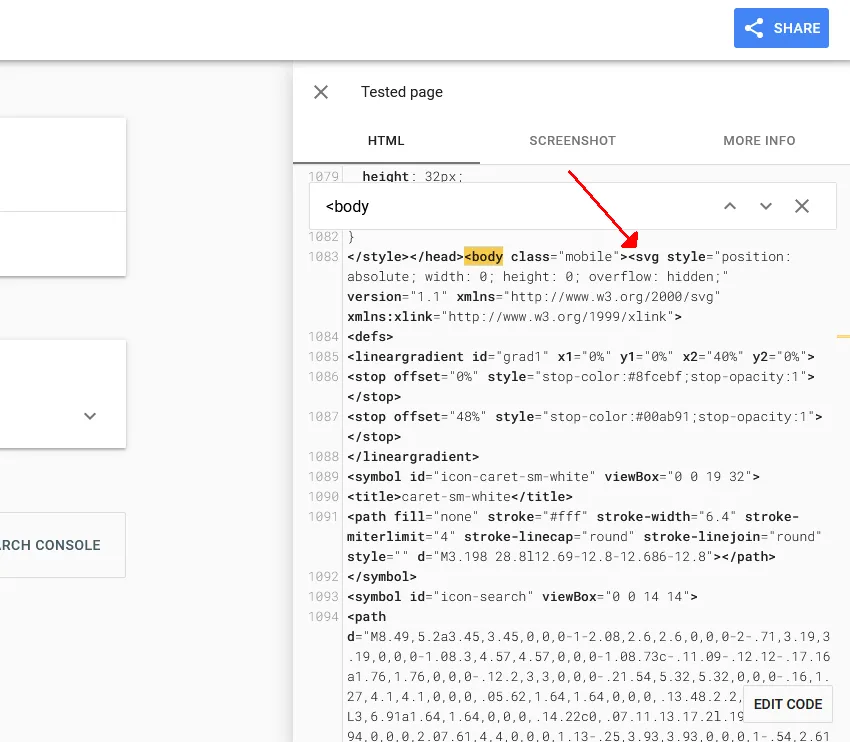
- Search Console : tu peux aussi vérifier la présence d’éléments non valides dans le head avec l’outil d’inspection d’URL de la Search Console.
Exemple : canonical ignorée par Google
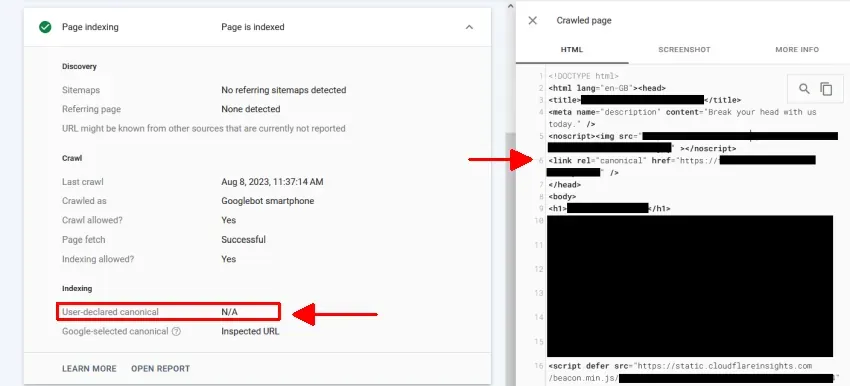
Pour montrer à quel point le sujet est important en SEO, voici un exemple.
Le HTML rendu à droite semble correct, mais la « canonical déclarée par l’utilisateur » est ignorée à cause d’une balise <noscript> contenant une image placée au-dessus, qui ferme le head.
Des questions sur Comment déboguer le HTML invalide dans le head ?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
