¿Cómo depurar el HTML no válido en el head?.
Descubre cómo depurar el HTML no válido en el head
Cómo encontrar los elementos HTML no válidos en el head que hacen que Google cierre el head antes de tiempo e ignore los metadatos siguientes. Mira qué elementos se admiten, cómo usar la pestaña Validation de SEO Spider y cómo comprobar los errores con el HTML renderizado y Search Console.
Qué es el HTML no válido en el head
En 2026, el SEO exige un control cada vez más riguroso del código HTML, en especial de la sección <head>, el centro que transmite los metadatos esenciales a buscadores y sistemas de IA. La calidad y la validez del contenido del <head> ya no son un detalle técnico: son fundamentales para que titles, descripciones, canonicals y marcadores SEO no se ignoren ni se vean comprometidos, sobre todo cuando herramientas avanzadas como Screaming Frog SEO Spider sacan a la luz errores que pueden impedir la correcta interpretación del documento.
Esta guía para depurar los elementos HTML del <head> describe con precisión el peligro de incluir en él etiquetas no conformes como <img>, <svg>, <iframe> o <div>: hacen que Google interprete que el head se ha cerrado antes de tiempo e ignore todo lo que viene después.
En un contexto en el que la IA y los sistemas de ranking avanzados premian contenidos inteligentes, coherentes y válidos, y en el que los resultados enriquecidos, los fragmentos destacados y la búsqueda basada en entidades son decisivos, no basta con tener contenidos de valor: también tienen que ser técnicamente legibles y estar perfectamente estructurados.
Así que este artículo no es solo un tutorial técnico: es un recurso fundamental para garantizar la máxima eficacia SEO, la accesibilidad y una interpretación correcta por parte de buscadores y sistemas de IA. Verás cómo usar Screaming Frog no solo para identificar páginas con errores en el <head>, sino también para diagnósticos eficaces (rastreo, pestaña «Validation», HTML sin procesar vs renderizado, herramientas de Search Console) y correcciones concretas.
Este tutorial explica cómo usar Screaming Frog SEO Spider para identificar elementos HTML no válidos en el head, ver qué metadatos pueden verse afectados y cómo resolver la causa del error.
Usar HTML válido para los metadatos de una página garantiza que buscadores como Google puedan usarlos para indexar cada página.
Aunque los buscadores intentan entender el marcado incluso con errores, algunos elementos del head pueden causar problemas en cómo el rastreador gestiona la información.
Si se usan elementos HTML no válidos dentro del head («<head>»), Google considera que el head ha terminado y empieza el body en su análisis.
Esto significa que los metadatos que aparecen después del elemento no válido podrían ser ignorados por Google.
Elementos HTML válidos en el head
El head solo debería contener estos elementos HTML:
- title
- meta
- link
- script
- style
- base
- noscript
- template
Otros elementos pueden causar problemas de rastreo e indexación:
- iframe
- img
- svg
- div
- un noscript que contiene una «img».
En general, ten en cuenta también que los elementos del <body> situados antes del elemento <head> pueden afectar a todos los metadatos del head.
Por ejemplo, una etiqueta <div> fuera de lugar antes de la apertura del elemento <html> hará que Google abra y cierre automáticamente un <head> vacío, de modo que todos los metadatos quedarán en el <body> y podrían ignorarse.
Según Google, si aun así necesitas poner elementos «no válidos» en el head, deben ir después de los elementos que el rastreador debe tener en cuenta.
Identificar el HTML no válido con Screaming Frog
Encontrar a gran escala elementos HTML no válidos en el head, o antes de él, es difícil, y ahí es donde Screaming Frog hace el trabajo pesado.
SEO Spider señala las páginas con elementos <html> no válidos que pueden dar problemas y las metaetiquetas, como titles, canonicals o meta robots, que están fuera del head.
Rastreo del sitio
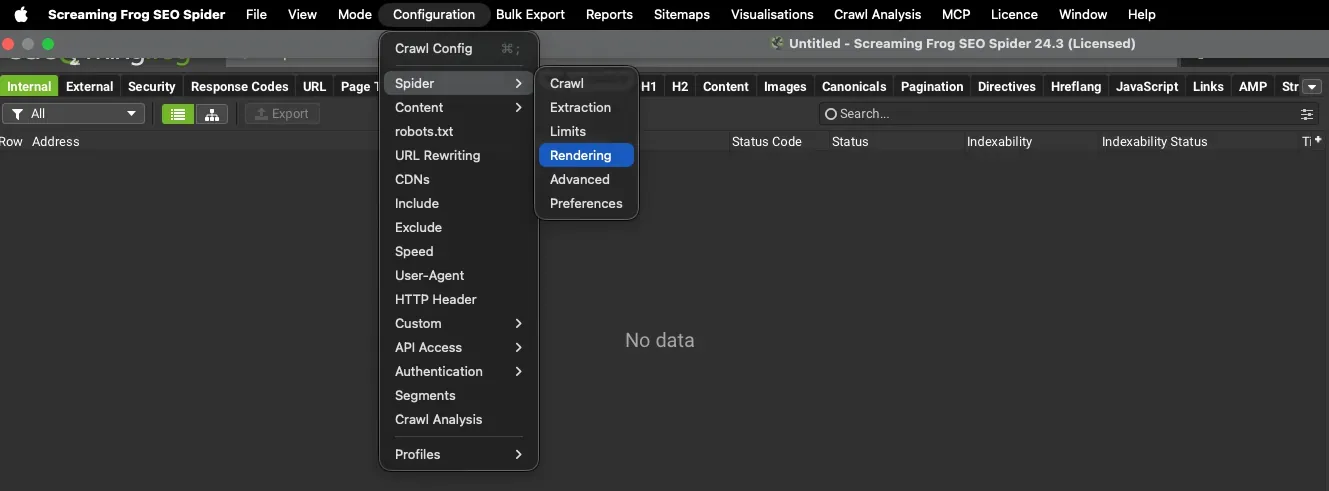
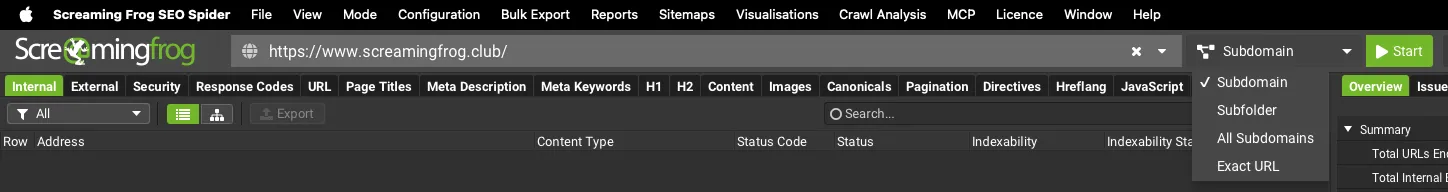
El primer paso es muy sencillo: no hay que configurar nada en SEO Spider salvo el renderizado JavaScript, para analizar también los elementos que se insertan tras ejecutar los scripts. Lo encuentras en 1Configuration›2Spider›3Rendering.
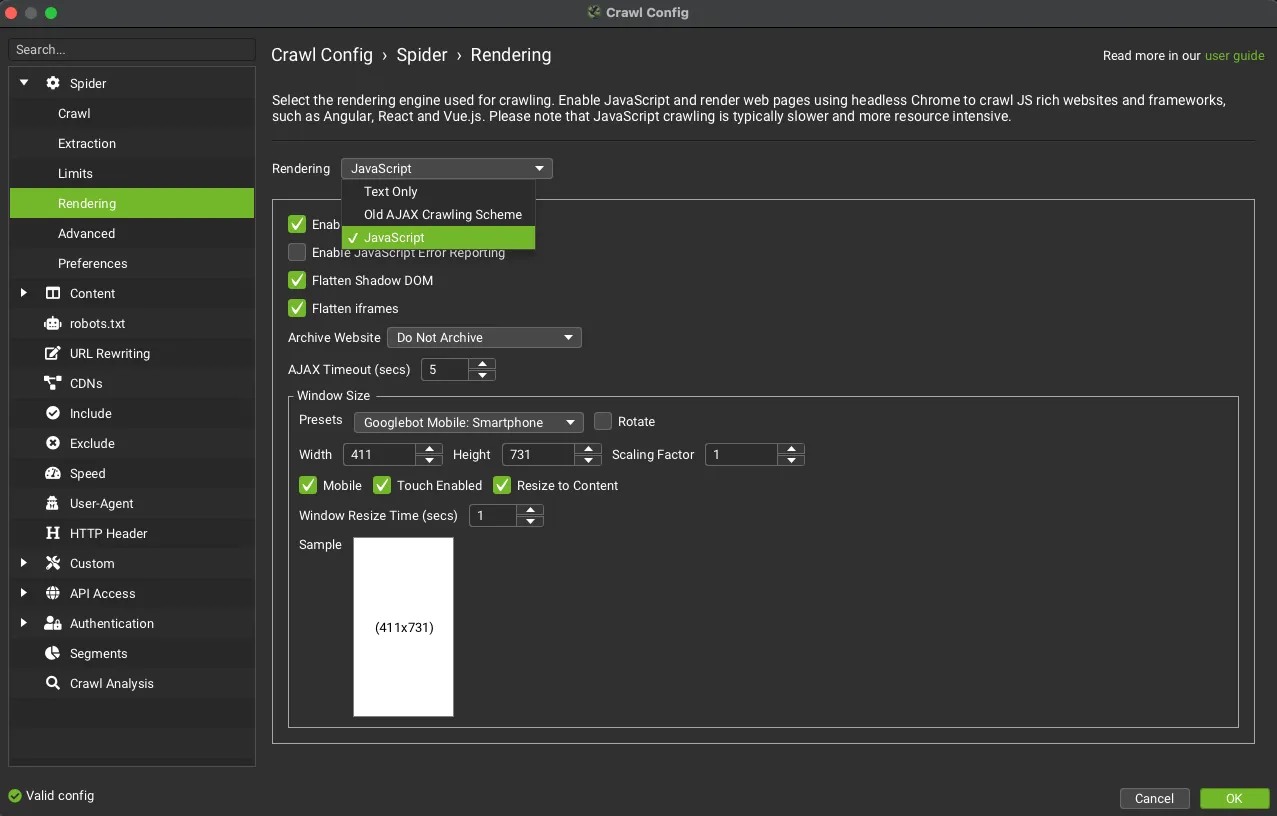
Después introduce el dominio o subdominio que analizar e inicia el rastreo.
Análisis de la pestaña Validation
Durante el rastreo ya puedes ver los datos en tiempo real, o esperar al final para tener una visión completa de las URL afectadas.
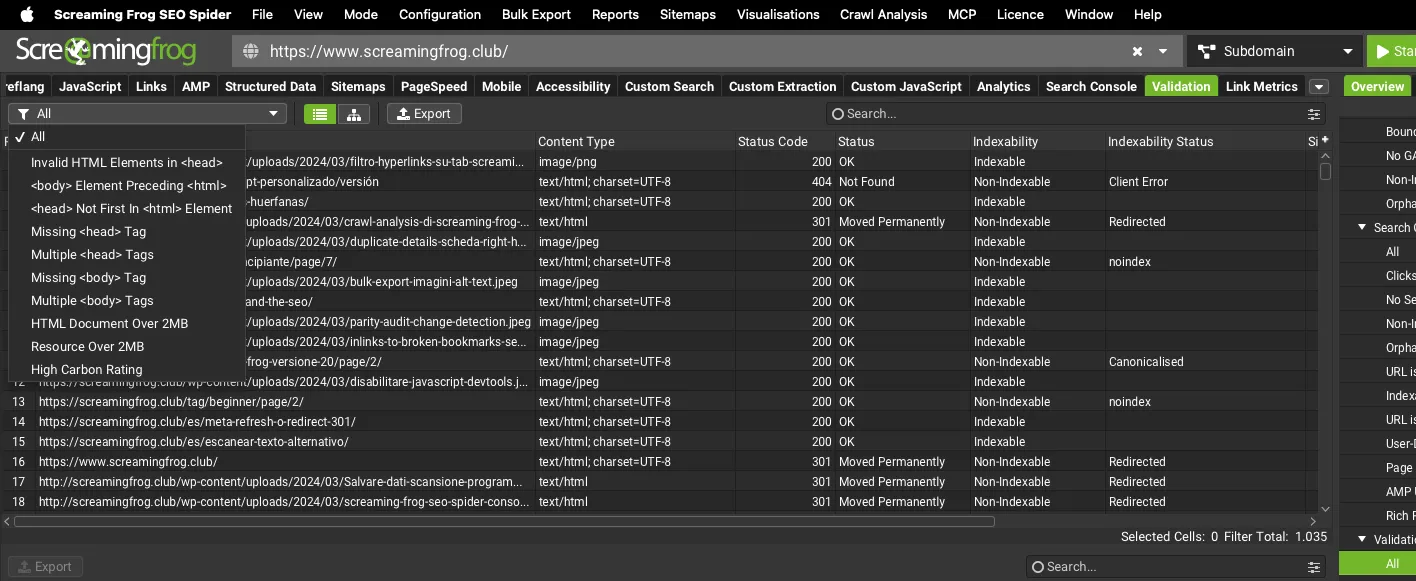
La pestaña de referencia se llama 1Validation e incluye varios filtros:
- Invalid HTML Elements in Head: páginas con elementos HTML no válidos en el head. Cuando se usa un elemento no válido en el head, Google da por terminado el elemento <head> e ignora lo que aparece después. Los elementos críticos del head que vengan detrás no se verán.
- «<body>» Element Preceding «<html>»: URL con un elemento body antes de la apertura del elemento html. Los navegadores y Googlebot dan por empezado el body y generan un head vacío antes. El head previsto y sus metadatos quedan en el body y se ignoran.
- «<head>» Not First in «<html>» Element: el elemento <head> debería ser el primero del <html>. Navegadores y Googlebot generan automáticamente un <head> si no está el primero.
- Missing «<head>» Tag: páginas sin elemento <head> en el HTML.
- Multiple «<head>» Tags: páginas con varios elementos <head>.
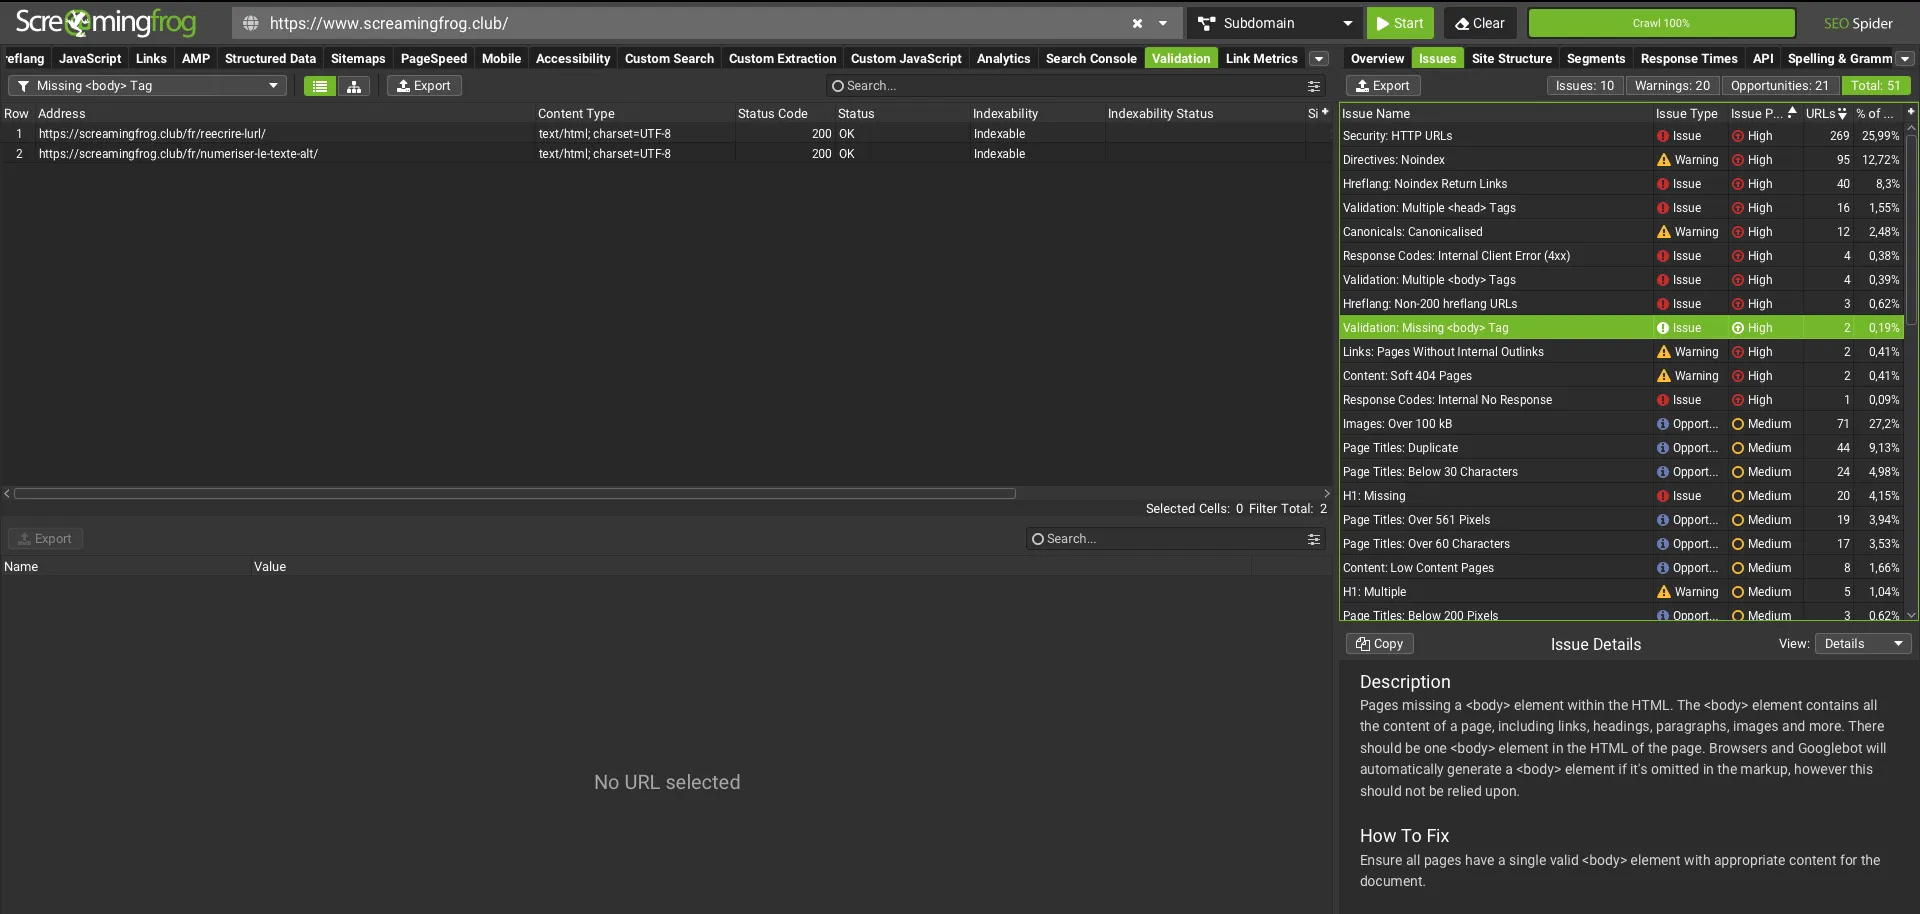
- Missing «<body>» Tag.
- Multiple «<body>» Tags.
- HTML Document Over 2MB.
- Resource Over 2MB.
- High Carbon Rating.
El análisis detallado está en la pestaña dedicada; para una visión de conjunto, sigue los datos en la barra lateral, donde en la pestaña 1Issues cada problema de validación aparece con prioridad alta.
Depurar el head
Una vez localizadas todas las URL afectadas, puedes analizarlas a fondo de tres formas:
- HTML sin procesar: analiza el head en el HTML original con clic derecho y «Ver código fuente de la página». El análisis será parcial, porque algunos elementos pueden insertarse con JavaScript.
- HTML renderizado: analiza la página tras el renderizado del JavaScript. Basta con usar «Inspeccionar» en Chrome y consultar la pestaña «Elements».
- Search Console: también puedes comprobar si hay elementos no válidos en el head con la herramienta de inspección de URL de Search Console.
Ejemplo: canonical ignorado por Google
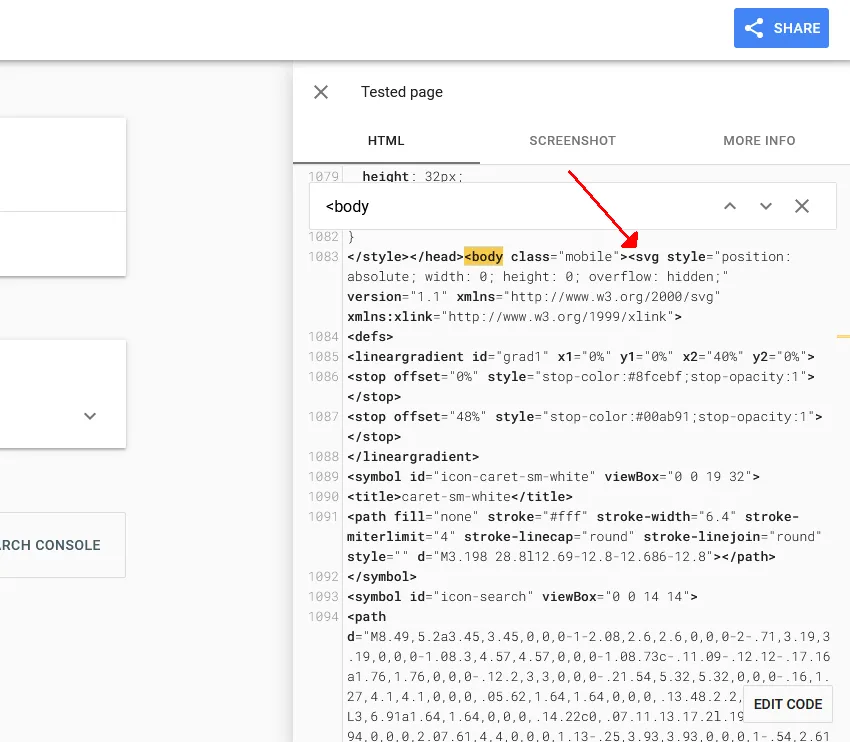
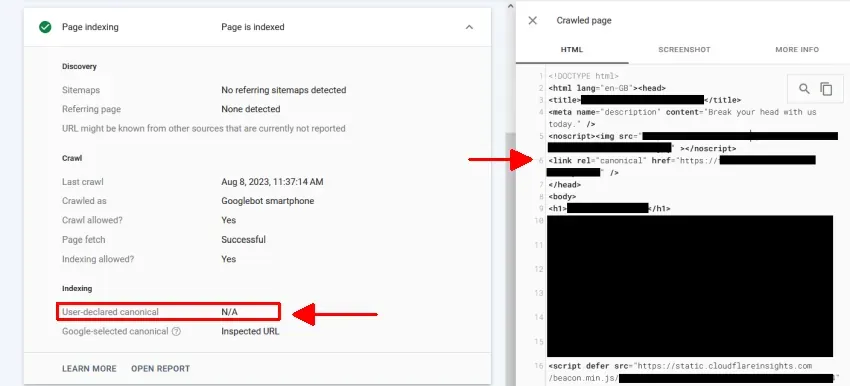
Para confirmar lo importante que es este tema para el SEO, veamos un ejemplo.
El HTML renderizado de la derecha parece correcto, pero el «canonical declarado por el usuario» se ignora por una etiqueta <noscript> con una imagen situada encima, que cierra el head.
¿Dudas sobre Cómo depurar el HTML no válido en el head?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
