

ONGLET INTERNAL.
L’onglet Internal, le premier et le plus complet de Screaming Frog SEO Spider.
Sommaire du guide 7 sections
●Brief01.Présentation de l’onglet Internal02.Code de statut03.Balises meta04.Liens05.Contenu06.HTTP et plusCe que tu trouves dans l’onglet Internal de SEO Spider, le premier et le plus complet : toutes les URL internes avec code de statut, balises meta, liens, contenus et informations HTTP.
Présentation de l’onglet Internal
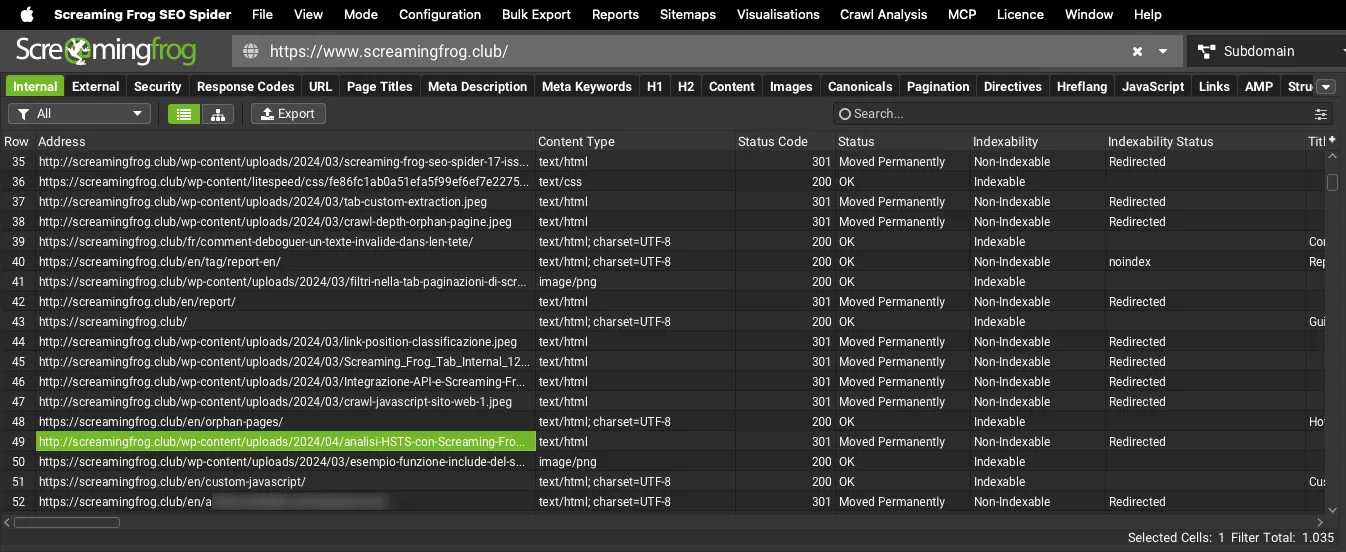
Dans SEO Spider, le premier onglet est « Internal » : il réunit toutes les URL du même sous-domaine que la page de départ du crawl. Il contient toutes les métriques de SEO Spider, sauf les données des onglets « External », « Hreflang » et « Données structurées ». D’autres sous-domaines peuvent être traités comme internes (et non comme des référents externes) si tu utilises le réglage « crawl all subdomains », le mode liste ou la fonction CDNs.
Code de statut
Dans cet onglet, tu trouves les données suivantes :
-
Address : l’adresse (URL) de la ressource crawlée (HTML, JavaScript, CSS, images, PDF, Flash, autre).
-
Content : le type d’élément à l’URL :
- HTML ;
- JavaScript ;
- CSS ;
- Images ;
- PDF ;
- Flash ;
- Autre.
-
Status Code : la réponse HTTP du serveur :
- code 200 ;
- code 301 ;
- code 302 ;
- code 404 ;
- code 500 ;
-
Status : la réponse de l’en-tête HTTP quand l’URL est demandée :
- code 200 : OK ;
- code 301 : Moved Permanently (redirection permanente) ;
- code 302 : Moved Temporarily (redirection temporaire) ;
- code 404 : Not Found (introuvable) ;
- code 500 : Server Error (problème côté serveur) ;
- Connection Timeout
-
Indexability : indique si une URL est « Indexable » par les moteurs ou « Non-Indexable ».
-
Indexability Status : la raison pour laquelle une URL ne peut pas être indexée, par exemple parce qu’elle est « Canonicalised » vers une autre ressource, a un code autre que 200, ou affiche « Connection Timeout » et est donc traitée comme « No Response ».
Balises meta
- Title 1 : le title (titre de la page) que Google utilise dans ses résultats.
- Title 1 Length : la longueur du « Title 1 » en caractères. Un title de 30 à 55 caractères est conseillé pour éviter la troncature dans la SERP.
- Title 1 Pixel Width : la largeur du « Title 1 » en pixels.
Même rôle que le précédent, mais je te conseille de toujours raisonner en pixels, car la largeur variable des caractères peut tromper.
Exemple :
Une lettre « M » et une lettre « i » comptent chacune pour 1 caractère, mais n’occupent pas le même nombre de pixels : le « M » majuscule prend plus de place dans l’extrait. Mon conseil : vérifie toujours la largeur en pixels pour éviter les troncatures.
- Meta Description 1 : la description utilisée dans l’extrait de Google.
- Meta Description Length : le nombre de caractères de la meta description. Entre 70 et 155 caractères est conseillé.
- Meta Description Pixel Width : la largeur en pixels de la meta description. Il est conseillé de rester entre 400 et 1 011 pixels.
- Meta Keyword 1 : les mots-clés définis pour l’URL. Les meta keywords sont facultatives : Google a déclaré ne pas en tenir compte pour évaluer les contenus et le classement.
- Meta Keywords Length : le nombre de caractères des meta keywords.
- H1-1 : le premier titre H1 de l’URL (titre principal de la page).
- H1 Length-1 : la longueur en caractères du premier H1.
- H2-1 : le premier titre H2 (sous-titre).
- H2-Length-1 : la longueur en caractères du premier H2.
Exemple :
SEO Spider ne collecte que les deux premiers titres H2 trouvés dans le code source. Pour extraire les autres titres (h3, h4, etc.), je te conseille la fonction « Custom Extraction ».
- Meta Robots 1 : les directives meta robots (ex. max-image-preview:large)
- X-Robots-Tag 1 – X-Robots-Tag HTTP : les directives d’en-tête de l’URL (ex. noindex).
- Meta Refresh 1 : vérifie si le code d’une URL contient une chaîne « refresh ».
- Canonical Link Element : les données de l’élément de lien canonical.
- rel="next" 1 : SEO Spider collecte ces éléments de lien HTML, conçus pour indiquer la relation entre les URL d’une série paginée ; celui-ci désigne la page suivante. Cet élément et le suivant sont fréquents sur les blogs, forums et e-commerce. Même si Google affirme pouvoir crawler un site entier sans eux, je pense qu’ils restent utiles pour les autres robots. « next » indique la relation avec la page suivante.
- rel="prev" 1 : SEO Spider collecte ces éléments de lien HTML, conçus pour indiquer la relation entre les URL d’une série paginée. « prev » indique la relation avec la page précédente.
Liens
- Unique Inlinks : le nombre de liens internes « uniques » qui pointent vers l’URL.
Exemple :
Si la « page A » pointe 3 fois vers la « page B », il y aura 1 inlink unique (et 3 inlinks).
- % of Total : le pourcentage de liens internes entrants uniques (seules les pages HTML en 200 sont prises en compte) vers l’URL.
- Outlinks : le nombre de liens internes vers d’autres URL du même sous-domaine.
- Unique External Outlinks : le nombre de liens uniques, dans des éléments d’ancre, d’une URL vers un autre sous-domaine.
Exemple :
Si la « page A » pointe 3 fois vers la « page B » sur un autre sous-domaine, cela compte comme 3 liens sortants externes et 1 lien sortant externe unique vers la « page B ».
- External Outlinks : le nombre de liens de l’URL vers des sous-domaines externes (différents de celui crawlé).
Contenu
-
Size : la taille en kilo-octets. Elle vient de l’en-tête Content-Length s’il est fourni, sinon elle vaut zéro. Pour les pages HTML, c’est la taille du HTML (non compressé) en Ko. À l’export, la taille est en octets : 1 kilo-octet = 1 024 octets.
-
Word Count : le nombre total de « mots » crawlés dans la balise body, hors balisage HTML. Le décompte se base sur la zone de contenu, sans les éléments nav et footer. Tu peux le personnaliser en définissant une autre zone : pour un diagnostic plus fin, tu peux inclure ou exclure des éléments HTML, des classes et des ID. Même si SEO Spider est très précis, ses valeurs peuvent différer d’un comptage manuel, car le parser corrige certaines choses quand il rencontre du HTML invalide. Tes réglages de rendu peuvent aussi influencer le HTML examiné. Screaming Frog compte les mots en découpant le texte sur les espaces, sans tenir compte de la visibilité (comme un texte dans un div masqué).
-
Closest Similarity Match : indique le degré de similarité entre pages pour éviter les duplications. Avec les seuils par défaut de SEO Spider, les pages sont signalées comme « quasi-doublons » à partir de 90 %. Tu peux aussi personnaliser ces seuils.
Pour remplir cette colonne, lance la Crawl Analysis à la fin du crawl. Seules les URL au-dessus du seuil auront des données, les autres restent vides. Par défaut, cette colonne ne contient donc des données que pour les URL similaires à 90 % ou plus. Le seuil se règle dans 1Configuration›2Content›3Duplicates. -
Hash : SEO Spider calcule une valeur de hachage MD5 de l’URL. Si deux valeurs sont identiques, le contenu est considéré comme dupliqué et peut être pénalisé. Contrairement à « Closest Similarity Match », c’est un contrôle des doublons exacts.
À noter : si deux hachages correspondent, les pages ont exactement le même contenu. S’il y a ne serait-ce qu’un caractère de différence, les hachages diffèrent et les pages ne sont pas signalées. Tu trouves les doublons exacts dans 1Content›2Exact Duplicates. -
No. Near Duplicates : le nombre d’URL quasi-doublons trouvées qui atteignent ou dépassent le « Near Duplicate Similarity Threshold » (90 % par défaut). Réglable dans 1Configuration›2Content›3Duplicates.
Pour remplir cette colonne, il faut avoir activé les quasi-doublons et lancé la Crawl Analysis.
-
Spelling Errors : le nombre total de fautes d’orthographe d’une URL. Pour remplir cette colonne, sélectionne « Enable Spell Check » dans 1Configuration›2Content›3Spelling & Grammar.
-
Grammar Errors : le nombre total de fautes de grammaire de chaque URL. Pour remplir cette colonne, sélectionne « Enable Grammar Check ». Dans les réglages, tu peux choisir la langue, les règles de grammaire et le dictionnaire de référence.
Pour consulter les fautes, regarde les colonnes dédiées de l’onglet « Internal », sélectionne les URL concernées et vois le détail dans l’onglet « Spelling & Grammar Details » de la fenêtre inférieure. Une excellente fonction pour les rédacteurs, qui repère fautes de frappe et erreurs de grammaire. En plus de la liste, elle propose des corrections et montre où elles se trouvent, avec un aperçu. Pour les langues autres que l’anglais, les suggestions peuvent être moins fiables, mais l’outil reste très utile pour les fautes de frappe.
HTTP et plus
- Response Time : le temps en secondes pour télécharger l’URL, de l’envoi de la requête HTTP à la réception de la réponse complète du serveur. Il n’inclut pas le téléchargement des ressources supplémentaires en mode de rendu JavaScript.
- Last Modified : lu dans l’en-tête « Last-Modified » de la réponse HTTP. Si le serveur ne l’envoie pas, la valeur est vide.
- Redirect URL : si l’URL redirige, cette colonne indique la destination.
- Redirect Type : SEO Spider identifie :
- HTTP Redirect : déclenchée par un en-tête HTTP.
- HSTS Policy : redirection due à un en-tête HSTS.
- JavaScript Redirect : redirection déclenchée par l’exécution de JavaScript (uniquement en mode de rendu JavaScript).
- Meta Refresh Redirect : déclenchée par une balise meta refresh dans le HTML.
- HTTP Version : la version HTTP utilisée pour le crawl. Utile pour vérifier si le serveur répond en HTTP/1.1 ou HTTP/2.
Des questions sur ONGLET INTERNAL?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
