

PESTAÑA INTERNAL.
La pestaña Internal, la primera y más completa de Screaming Frog SEO Spider.
Índice de la guía 7 secciones
●Brief01.Panorámica de la pestaña Internal02.Código de estado03.Metaetiquetas04.Enlaces05.Contenido06.HTTP y másQué encuentras en la pestaña Internal de SEO Spider, la primera y la más completa: todas las URL internas con código de estado, metaetiquetas, enlaces, contenidos e información HTTP.
Panorámica de la pestaña Internal
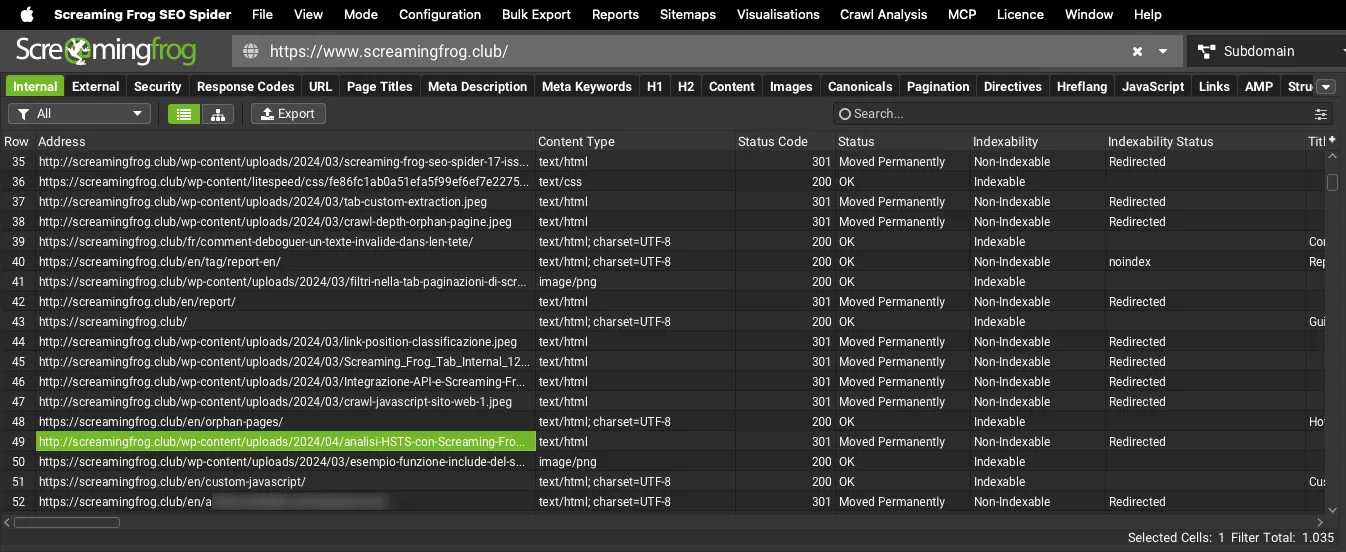
En SEO Spider la primera pestaña es «Internal», que reúne todas las URL del mismo subdominio que la página inicial del rastreo. Incluye todas las métricas de SEO Spider, salvo los datos de las pestañas «External», «Hreflang» y «Datos estructurados». Otros subdominios pueden tratarse como internos (y no como referencias externas) si usas el ajuste «crawl all subdomains», el modo lista o la función CDNs.
Código de estado
En esta pestaña encuentras los siguientes datos:
-
Address: la dirección (URL) del recurso rastreado (HTML, JavaScript, CSS, imágenes, PDF, Flash, otros).
-
Content: el tipo de elemento de la URL:
- HTML;
- JavaScript;
- CSS;
- Imágenes;
- PDF;
- Flash;
- Otros.
-
Status Code: la respuesta HTTP del servidor:
- código 200;
- código 301;
- código 302;
- código 404;
- código 500;
-
Status: la respuesta de la cabecera HTTP al solicitar la URL:
- código 200: OK;
- código 301: Moved Permanently (redirección permanente);
- código 302: Moved Temporarily (redirección temporal);
- código 404: Not Found (no encontrada);
- código 500: Server Error (problema del servidor);
- Connection Timeout
-
Indexability: indica si una URL es «Indexable» por los buscadores o «Non-Indexable».
-
Indexability Status: el motivo por el que una URL no se puede indexar, por ejemplo porque está «Canonicalised» hacia otro recurso, tiene un código distinto de 200 o muestra «Connection Timeout» y se considera «No Response».
Metaetiquetas
- Title 1: el title (título de la página) que Google usa en sus resultados.
- Title 1 Length: la longitud del «Title 1» en caracteres. Se recomienda un title de entre 30 y 55 caracteres para evitar que el fragmento se corte en la SERP.
- Title 1 Pixel Width: el ancho del «Title 1» en píxeles.
Cumple la misma función que el anterior, pero te recomiendo razonar siempre en píxeles, porque el distinto ancho de los caracteres puede engañarte.
Ejemplo:
Una «M» y una «i» cuentan cada una como 1 carácter, pero ocupan distintos píxeles, y la «M» mayúscula ocupa más espacio en el fragmento. Mi consejo es comprobar siempre el ancho en píxeles para evitar cortes en la SERP.
- Meta Description 1: la descripción que usa el fragmento de Google.
- Meta Description Length: el número de caracteres de la meta description. Se recomienda entre 70 y 155 caracteres.
- Meta Description Pixel Width: el ancho en píxeles de la meta description. Se recomienda quedarse entre 400 y 1.011 píxeles.
- Meta Keyword 1: las palabras clave de la URL. Las meta keywords son opcionales: Google ha declarado que no las tiene en cuenta para valorar los contenidos ni para el ranking.
- Meta Keywords Length: el número de caracteres de las meta keywords.
- H1-1: el primer encabezado H1 de la URL (título principal de la página).
- H1 Length-1: la longitud en caracteres del primer H1.
- H2-1: el primer encabezado H2 (subtítulo).
- H2-Length-1: la longitud en caracteres del primer H2.
Ejemplo:
SEO Spider solo recoge los dos primeros encabezados H2 que encuentra en el código fuente. Para extraer los demás encabezados (h3, h4, etc.) te recomiendo la función «Custom Extraction».
- Meta Robots 1: las directivas meta robots (p. ej. max-image-preview:large)
- X-Robots-Tag 1 – X-Robots-Tag HTTP: las directivas de cabecera de la URL (p. ej. noindex).
- Meta Refresh 1: comprueba si el código de una URL contiene una cadena «refresh».
- Canonical Link Element: los datos del elemento de enlace canonical.
- rel="next" 1: SEO Spider recoge estos elementos de enlace HTML, pensados para indicar la relación entre las URL de una serie paginada; este señala la página siguiente. Este elemento y el siguiente son habituales en blogs, foros y ecommerce. Aunque Google ha declarado que puede rastrear un sitio completo sin ellos, creo que siguen siendo útiles para otros bots. «next» indica la relación con la página siguiente.
- rel="prev" 1: SEO Spider recoge estos elementos de enlace HTML, pensados para indicar la relación entre las URL de una serie paginada. «prev» indica la relación con la página anterior.
Enlaces
- Unique Inlinks: el número de enlaces internos «únicos» que apuntan a la URL.
Ejemplo:
Si la «página A» enlaza 3 veces a la «página B», habrá 1 inlink único (y 3 inlinks).
- % of Total: el porcentaje de enlaces internos entrantes únicos (solo cuenta las páginas HTML con código 200) a la URL.
- Outlinks: el número de enlaces internos hacia otras URL del mismo subdominio.
- Unique External Outlinks: el número de enlaces únicos, en elementos de anclaje, de una URL hacia otro subdominio.
Ejemplo:
Si la «página A» enlaza 3 veces a la «página B» de otro subdominio, cuenta como 3 enlaces salientes externos y 1 enlace saliente externo único hacia la «página B».
- External Outlinks: el número de enlaces de la URL hacia subdominios externos (distintos del rastreado).
Contenido
-
Size: el tamaño en kilobytes. Se toma de la cabecera Content-Length si existe; si no, vale cero. En las páginas HTML es el tamaño del HTML (sin comprimir) en KB. Al exportar, el tamaño se da en bytes: 1 kilobyte = 1.024 bytes.
-
Word Count: la suma de todas las «palabras» rastreadas dentro de la etiqueta body, sin el marcado HTML. El recuento se basa en el área de contenido, excluyendo los elementos nav y footer. Puedes personalizarlo definiendo otra área: para un diagnóstico más fino puedes incluir o excluir elementos HTML, clases e ID. Aunque SEO Spider es muy preciso, sus valores pueden diferir de un recuento manual, porque el parser hace algunas correcciones al encontrar HTML no válido. Tus ajustes de renderizado también pueden influir en el HTML analizado. Screaming Frog cuenta las palabras dividiendo el texto por espacios, sin tener en cuenta si el contenido es visible (como un texto dentro de un div oculto).
-
Closest Similarity Match: muestra el grado de similitud entre páginas para evitar duplicaciones. Con los umbrales por defecto de SEO Spider, las páginas se marcan como «casi duplicadas» a partir del 90 %. También puedes personalizar los umbrales.
Para rellenar esta columna hay que ejecutar la Crawl Analysis al final del rastreo. Solo las URL por encima del umbral tendrán datos; las demás quedan vacías. Por defecto, esta columna solo tendrá datos para las URL con un 90 % o más de similitud. El umbral se fija en 1Configuration›2Content›3Duplicates. -
Hash: SEO Spider calcula un valor hash MD5 de la URL. Si dos valores coinciden, el contenido se considera duplicado y puede ser penalizado. A diferencia de «Closest Similarity Match», es un control de duplicados exactos.
Nota: si dos valores hash coinciden, las páginas tienen exactamente el mismo contenido. Si difieren aunque sea en un carácter, tendrán hash distintos y no se marcarán como duplicadas. Los duplicados exactos están en 1Content›2Exact Duplicates. -
No. Near Duplicates: el número de URL casi duplicadas encontradas que alcanzan o superan el «Near Duplicate Similarity Threshold» (90 % por defecto). Se cambia en 1Configuration›2Content›3Duplicates.
Para rellenar esta columna hay que haber activado los casi duplicados y ejecutado la Crawl Analysis.
-
Spelling Errors: el número total de errores ortográficos de una URL. Para rellenarla, selecciona «Enable Spell Check» en 1Configuration›2Content›3Spelling & Grammar.
-
Grammar Errors: el número total de errores gramaticales de cada URL. Para rellenarla, selecciona «Enable Grammar Check». En los ajustes puedes elegir el idioma, las reglas gramaticales y el diccionario de referencia.
Para consultar los errores, mira las columnas correspondientes de la pestaña «Internal», selecciona las URL con errores y consulta el detalle en la pestaña «Spelling & Grammar Details» de la ventana inferior. Una función excelente para los redactores, que detecta erratas y errores gramaticales. Además de la lista, sugiere correcciones y muestra dónde se encontraron, con vista previa. En idiomas distintos del inglés las sugerencias pueden ser menos fiables, pero es muy útil para las erratas.
HTTP y más
- Response Time: el tiempo en segundos para descargar la URL, desde el envío de la petición HTTP hasta recibir la respuesta completa del servidor. No incluye la descarga de recursos adicionales en modo de renderizado JavaScript.
- Last Modified: se lee de la cabecera «Last-Modified» de la respuesta HTTP. Si el servidor no la envía, el valor queda vacío.
- Redirect URL: si la URL redirige, esta columna indica el destino.
- Redirect Type: SEO Spider identifica:
- HTTP Redirect: activada por una cabecera HTTP.
- HSTS Policy: redirección por una cabecera HSTS.
- JavaScript Redirect: redirección activada por la ejecución de JavaScript (solo en modo de renderizado JavaScript).
- Meta Refresh Redirect: activada por una etiqueta meta refresh en el HTML.
- HTTP Version: la versión HTTP usada en el rastreo. Útil para comprobar si el servidor responde por HTTP/1.1 o HTTP/2.
¿Dudas sobre PESTAÑA INTERNAL?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
