

Qu’est-ce que le web scraping ?.
Comment scraper les SERP avec la Custom Extraction de Screaming Frog.
Sommaire du guide 5 sections
●Brief01.Qu’est-ce que le web scrapingCe qu’est le web scraping, ses techniques et ses limites légales, du RGPD au droit d’auteur. Dans la seconde partie, tu verras comment l’appliquer au SEO avec Screaming Frog, y compris pour extraire des données des SERP.
Qu’est-ce que le web scraping
Le web scraping, de l’anglais « to scrape » (gratter), est une méthode de collecte de données et d’informations directement depuis les pages web ou les SERP, pour les cataloguer et les stocker dans une base de données.
Dans certains cas, encore fréquents, le web scraping sert à collecter noms, prénoms et données sensibles pour constituer des bases marketing, mais cette pratique est illégale.
Dans d’autres cas, il peut servir à des campagnes de phishing, des usurpations d’identité ou des violations du droit d’auteur.
Malgré ces dérives, le web scraping n’est pas illégal en soi et permet de récupérer des données très précieuses pour les analyses SEO et le marketing digital en général.
Comment fonctionne le web scraping
Le web scraping est une technique d’extraction automatisée de données de sites web à l’aide de logiciels ou de scripts dédiés. Il permet de collecter des informations structurées, comme des textes, des images ou d’autres données publiques, puis de les traiter selon des besoins précis.
Technologies et méthodes
Les principales méthodes de web scraping sont :
- Parsing HTML : l’usage de bibliothèques comme Beautiful Soup en Python pour analyser le code HTML d’une page.
- Automatisation du navigateur : des outils comme Selenium qui simulent un utilisateur humain pour naviguer et interagir avec les pages.
- API publiques : de nombreux sites proposent des API (Application Programming Interfaces) qui donnent un accès légal aux données dans un format structuré.
Applications du web scraping
Les usages les plus courants sont :
- Analyse de marché : les entreprises peuvent suivre les prix des concurrents et les avis clients.
- Recherche académique : la collecte de grands volumes de données pour des analyses statistiques.
- Automatisation : la réduction du temps nécessaire pour collecter manuellement des données de différentes sources.
Cas d’usage réels
Un exemple concret : le « crawling web » dans l’e-commerce pour mettre à jour dynamiquement les prix selon les concurrents. De même, les plateformes qui agrègent des annonces immobilières utilisent le web scraping pour tenir leur base à jour.
Aspects juridiques du web scraping
Aussi utile soit-il, le web scraping soulève plusieurs questions juridiques. Comprendre et respecter les règles est essentiel pour éviter les conflits et protéger toutes les parties.
Par exemple, dans certaines juridictions, le web scraping est considéré comme une violation du droit de la propriété intellectuelle ou des contrats, surtout quand il enfreint les conditions d’utilisation d’un site. En outre, l’accès non autorisé à des systèmes informatiques peut constituer une infraction au regard de lois comme le Computer Fraud and Abuse Act (CFAA) aux États-Unis.
Le RGPD et le web scraping
Le Règlement général sur la protection des données (RGPD), en vigueur dans l’Union européenne depuis 2018, encadre la collecte et l’usage des données personnelles. Selon le RGPD, toute donnée permettant d’identifier une personne est « personnelle » et soumise à des règles strictes : noms, adresses e-mail, numéros de téléphone, adresses IP, etc.
Implications pour le web scraping
- Base légale de la collecte : les entreprises doivent identifier une base légale valable pour collecter des données personnelles. Par exemple, le consentement explicite de la personne concernée (article 6 du RGPD) ou un intérêt légitime qui ne prévaut pas sur ses droits fondamentaux.
- Transparence et information : les utilisateurs doivent être clairement informés de l’usage de leurs données, ce qui impose des mentions d’information décrivant les finalités et les méthodes de collecte.
- Minimisation des données : le RGPD impose de ne collecter que le minimum de données nécessaire à une finalité légitime (principe de minimisation).
- Sécurité des données : les données collectées doivent être protégées contre les accès non autorisés par des mesures techniques et organisationnelles adaptées (article 32).
Exemples pratiques
Un cas connu qui illustre les problèmes de RGPD liés au crawling est celui d’entreprises qui scrapent des adresses e-mail ou des profils LinkedIn sans consentement. Ces pratiques ont entraîné des sanctions administratives importantes au titre des articles 83 et 84 du RGPD, qui prévoient des amendes jusqu’à 20 millions d’euros ou 4 % du chiffre d’affaires annuel mondial.
Les entreprises qui pratiquent le web scraping doivent aussi tenir compte du droit à l’effacement (article 17), aussi appelé « droit à l’oubli », qui permet aux utilisateurs de demander la suppression de leurs données.
Propriété intellectuelle et web scraping
Les lois sur la propriété intellectuelle, dont le droit d’auteur, s’appliquent aussi aux contenus en ligne.
Aspects juridiques
- Contenus protégés par le droit d’auteur : copier des textes, images ou autres éléments protégés sans autorisation est interdit. Cela vaut aussi pour les contenus accessibles publiquement mais protégés, comme les articles de presse, les images ou les bases de données protégées.
- Conditions d’utilisation : la plupart des sites interdisent le web scraping dans leurs conditions d’utilisation. Ignorer ces restrictions peut mener à des contentieux, comme l’ont montré plusieurs affaires internationales.
Affaires connues
Une affaire emblématique est le litige entre LinkedIn et HiQ Labs, où LinkedIn a tenté d’empêcher HiQ de collecter des données publiques des profils. Le litige portait sur deux points clés : la violation des conditions d’utilisation de LinkedIn et un possible conflit avec la libre concurrence. Même si HiQ a d’abord obtenu gain de cause, l’affaire a souligné la complexité juridique du web scraping.
Autre exemple marquant : les litiges sur l’utilisation d’images protégées via le scraping. Un cas célèbre est celui de Getty Images, qui a engagé des actions contre des plateformes utilisant des logiciels de scraping pour récupérer et redistribuer des images sans licence.
Conformité et solutions
Pour éviter de violer le droit de la propriété intellectuelle :
- Vérifier les droits d’utilisation : avant d’utiliser des données scrapées, s’assurer qu’elles ne sont pas protégées.
- Demander des licences : le cas échéant, obtenir des licences ou autorisations pour les contenus protégés.
- Utiliser des sources open data : privilégier les données et contenus publiés sous licence ouverte (comme Creative Commons), qui en permettent un usage légal et gratuit.
Traiter les questions de propriété intellectuelle est essentiel pour éviter les contentieux et préserver la réputation de l’entreprise.
Bonnes pratiques pour une extraction conforme
Respecter les règles est crucial pour éviter les problèmes juridiques et garantir un usage éthique du web scraping et de la protection des données.
Stratégies conseillées
- Obtenir les autorisations : contacter les propriétaires des sites pour obtenir une autorisation explicite avant de collecter des données.
- Respecter les politiques de confidentialité : les consulter et s’y conformer.
- Utiliser les API : préférer les API officielles au scraping direct du HTML.
- Anonymiser les données : supprimer toute information personnelle des données collectées quand c’est possible.
Rédiger des politiques internes
Les entreprises qui pratiquent le web scraping devraient :
- documenter clairement leurs procédures de collecte ;
- fournir des informations détaillées sur les mesures prises pour garantir la conformité.
Le web scraping pour le SEO
Marketing digital et scraping
Après avoir vu le potentiel et les risques du « crawling sauvage », voyons ses applications au SEO et au marketing digital en général, et comment l’exploiter avec un logiciel de web scraping comme Screaming Frog.
Après des années où cette activité demandait des compétences techniques avancées, il existe aujourd’hui des outils no-code qui donnent d’excellents résultats en extraction de données.
À la base du web scraping éthique, il y a un standard appelé XPath, qui permet de localiser et de manipuler assez facilement les différents nœuds d’un document HTML.
Les avantages du web scraping pour le SEO
Le web scraping offre plusieurs avantages pour le référencement naturel (SEO) :
- Recherche de mots-clés : il permet de collecter une grande variété de données, dont les mots-clés utilisés par les concurrents ou présents sur les sites les plus pertinents d’un secteur. Ces informations aident à repérer de nouvelles opportunités et à améliorer la stratégie SEO (analyse des titres, balises meta, etc.).
- Veille concurrentielle : le web scraping permet de suivre en continu l’activité des concurrents : évolutions de leur stratégie SEO, nouveaux contenus, mises à jour de l’algorithme de Google, etc. Des informations précieuses pour adapter ta propre stratégie.
- Mise à jour des données : bien utilisé, il garde à jour les données utilisées pour le SEO. Tu peux par exemple suivre en continu les résultats et les évolutions de classement pour certains mots-clés, et collecter des données sur les nouvelles tendances de recherche et les comportements des utilisateurs.
- Analyse des backlinks : le web scraping peut servir à extraire des informations sur les backlinks de sites pertinents ou concurrents, pour trouver de nouvelles opportunités de netlinking et évaluer la qualité des backlinks existants (services comme Semrush ou Ahrefs).
- Scraping de contenus : utilisé de façon éthique et conforme, il permet de collecter des contenus pertinents d’autres sources pour enrichir ton site ou créer de nouveaux contenus de qualité en croisant les sources.
En bref, le web scraping offre aux spécialistes SEO des outils et des données utiles pour optimiser les performances des sites dans les moteurs. Il faut toutefois utiliser ces informations de façon responsable et conforme à la loi, pour éviter litiges et pénalités.
Le web scraping avec Screaming Frog
Custom Extraction et Visual Custom Extraction
Maintenant qu’on a vu l’intérêt de cette activité, voyons comment utiliser un outil de data scraping comme Screaming Frog pour extraire des informations précieuses et améliorer notre stratégie de marketing digital.
Avec SEO Spider, tu peux collecter rapidement et efficacement des données de pages web pour analyser ton site ou réaliser des comparaisons concurrentielles, même très poussées.
Avec XPath et la Custom Extraction, tes analyses ne seront plus les mêmes. Et depuis la version 19 de SEO Spider, la Visual Custom Extraction rend le scraping personnalisé encore plus simple et intuitif, sans connaissances préalables.
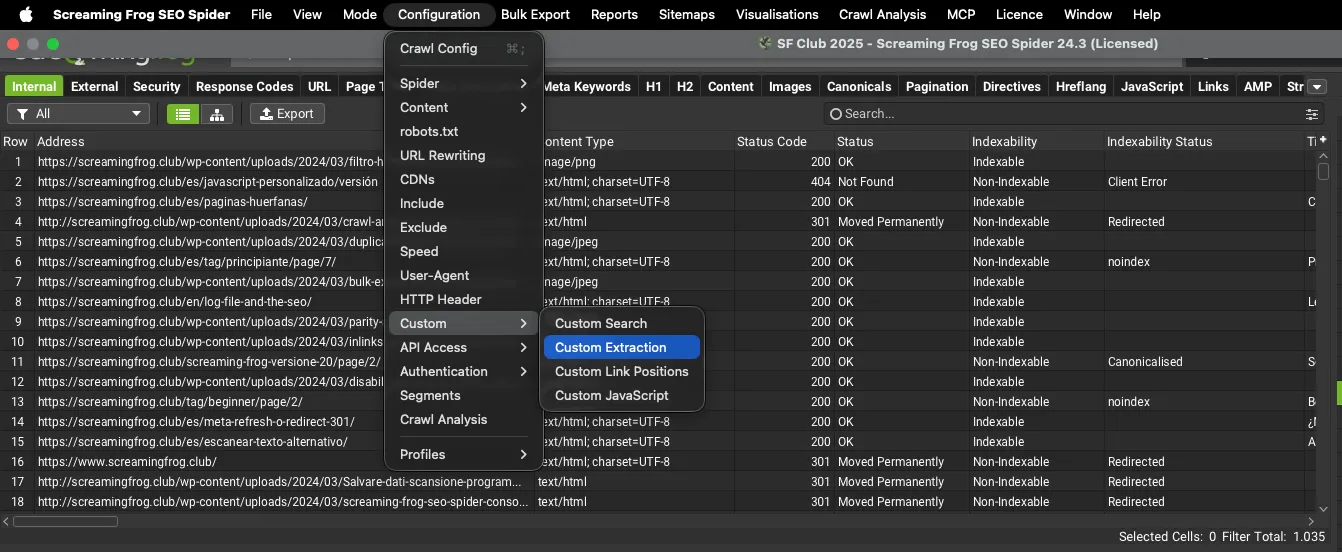
Pour commencer, ouvre 1Configuration›2Custom›3Custom Extraction.
Une fois dans la fonction, il suffit de cliquer sur Add en bas à droite et de saisir l’expression de scraping.
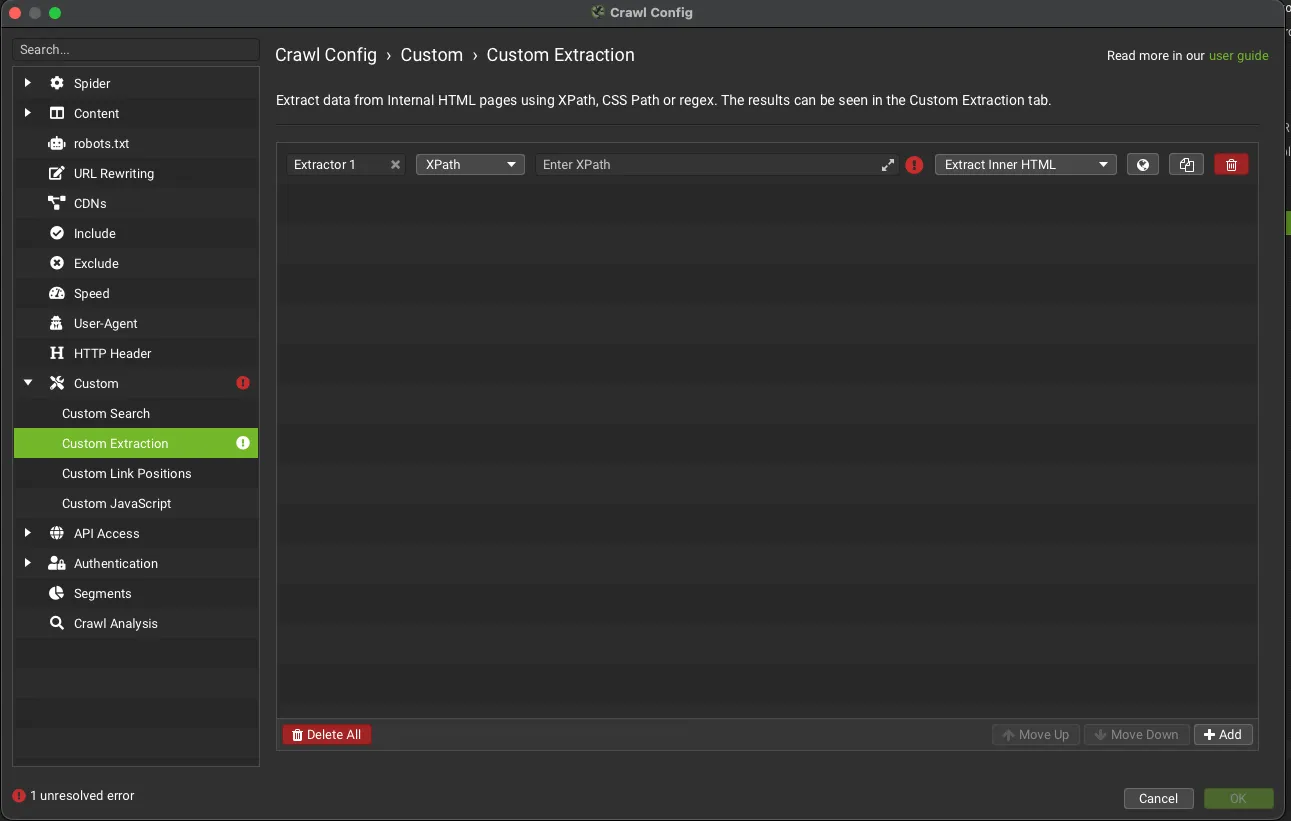
Si tu maîtrises déjà les expressions XPath, tu peux les saisir directement dans la cellule « Enter XPath » ; sinon, choisis la version « Visual » de SEO Spider, qui te permet en quelques clics de repérer visuellement les informations à extraire avec le navigateur intégré de Screaming Frog.
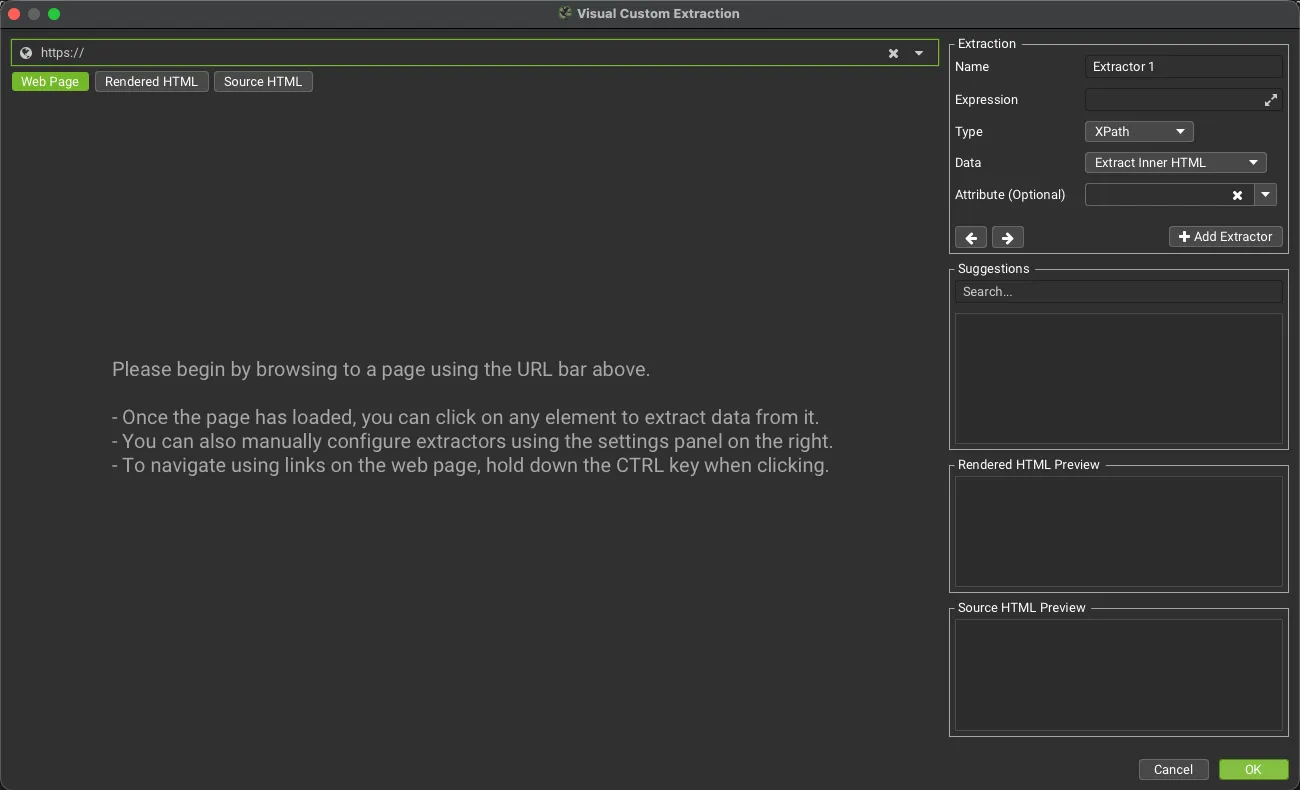
Ensuite, quand tu sélectionnes l’élément à extraire sur la page, SEO Spider met la zone en évidence, crée plusieurs expressions suggérées (à droite) et affiche un aperçu de ce qui sera extrait du HTML brut ou rendu.
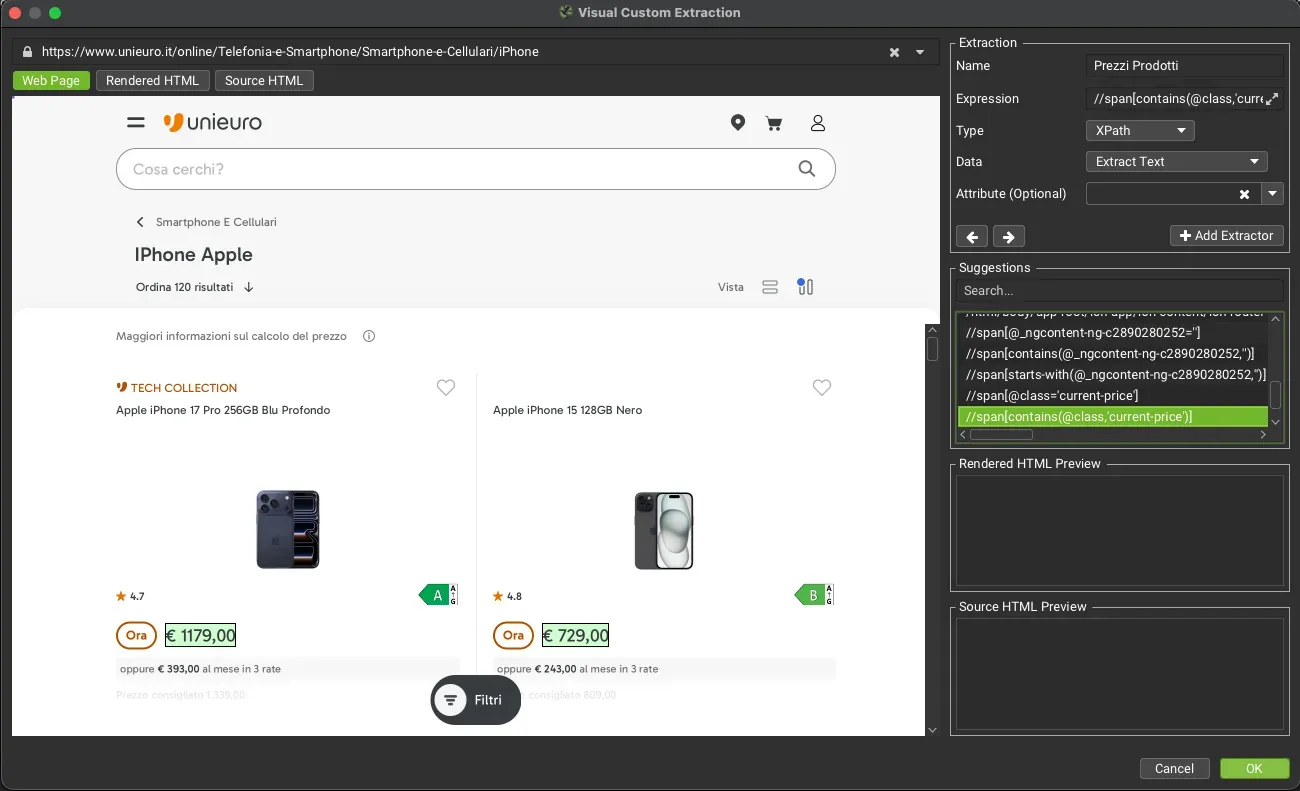
Dans l’exemple ci-dessus, j’ai sélectionné les prix des produits (en cliquant dessus) et, comme tu le vois à droite, SEO Spider a saisi la bonne syntaxe d’extraction.
Il y a essentiellement 4 types d’extraction (« Data ») :
- Extract HTML Element : l’élément sélectionné et tout son contenu HTML interne.
- Extract Inner HTML : le contenu HTML interne de l’élément sélectionné. S’il contient d’autres éléments HTML, ils sont inclus.
- Extract Text : le contenu textuel de l’élément sélectionné et de ses éventuels enfants.
- Function Value : le résultat de la fonction fournie, par exemple count(//h1) pour connaître le nombre de balises h1 d’une page.
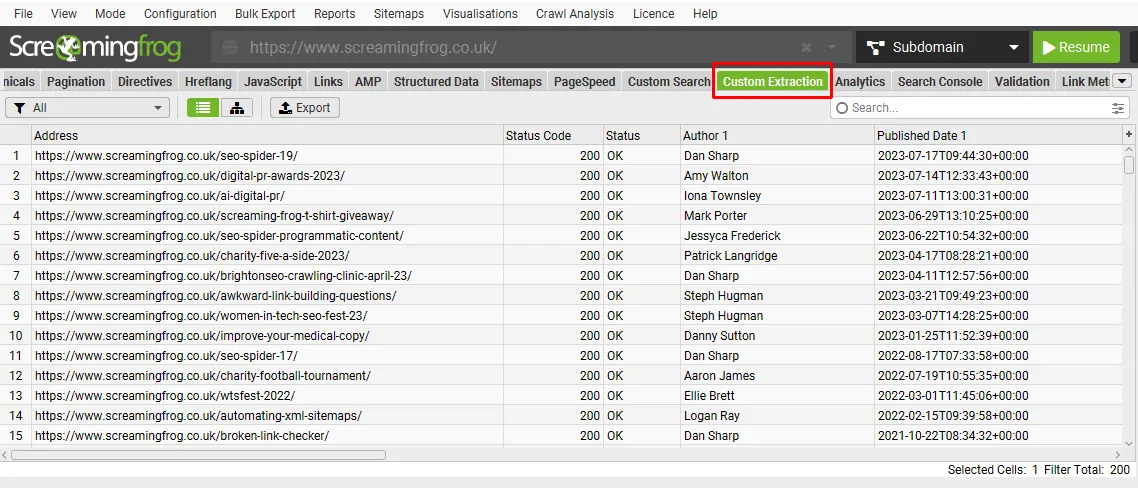
Une fois le crawl terminé, tu trouves les résultats de la Custom Extraction dans l’onglet dédié ; s’il y a plusieurs extractions, utilise les filtres pour passer de l’une à l’autre.
Scraper les SERP
Au-delà du scraping de ton site ou de sites concurrents, tu peux aussi extraire des données d’annuaires et du moteur lui-même. À faire avec prudence pour ne pas te faire bloquer ton IP, mais c’est très utile, par exemple, pour collecter des données de positionnement sur des mots-clés stratégiques.
Screaming Frog ne remplace pas des services comme Semrush, mais pour tes mots-clés cibles c’est un bon outil pour vérifier le positionnement des concurrents, les caractéristiques des sites les plus performants, etc.
- La première étape consiste à créer une URL de recherche Google que SEO Spider crawlera. Tu peux le faire simplement avec ce modèle Google Sheets.
- La deuxième étape consiste à configurer SEO Spider comme il faut :
- Utiliser le rendu JavaScript : 1Configuration›2Spider›3Rendering.
- Activer « Ignore robots.txt » : 1Configuration›2robots.txt.
- Utiliser le user agent « Chrome » : 1Configuration›2User-Agent.
- Réduire la vitesse de crawl (Max Threads = 1, Max URI/s = 0,5) : 1Configuration›2Speed.
Je te conseille d’enregistrer cette configuration comme nouveau profil depuis 1Configuration›2Profiles›3Save As…, pour la réutiliser au besoin.
Pour aller plus loinCrawl Profiles.Comment enregistrer et charger les profils de configuration de SEO Spider, par exemple celui pour le scraping des SERP.Lire le guideConfigurer le crawl en mode List
Une fois la configuration technique de Screaming Frog terminée, il est temps de définir la syntaxe d’extraction des données personnalisées des SERP avec un crawl en mode List : 1Mode›2List.
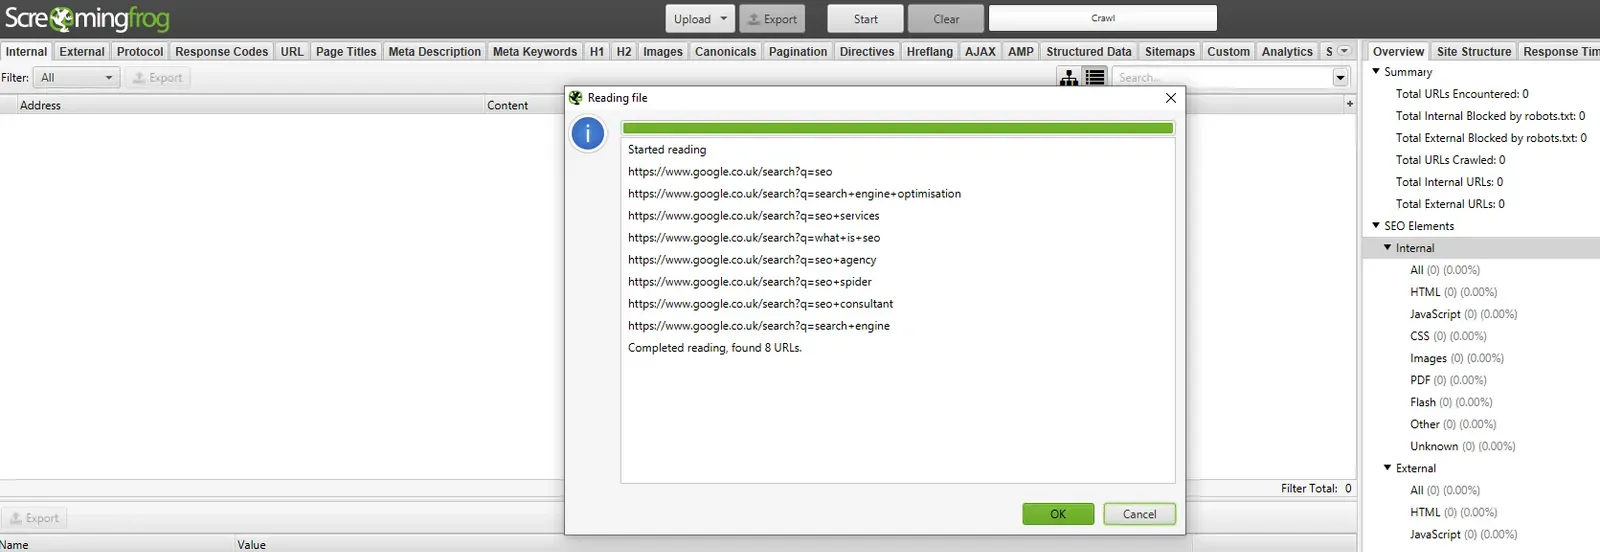
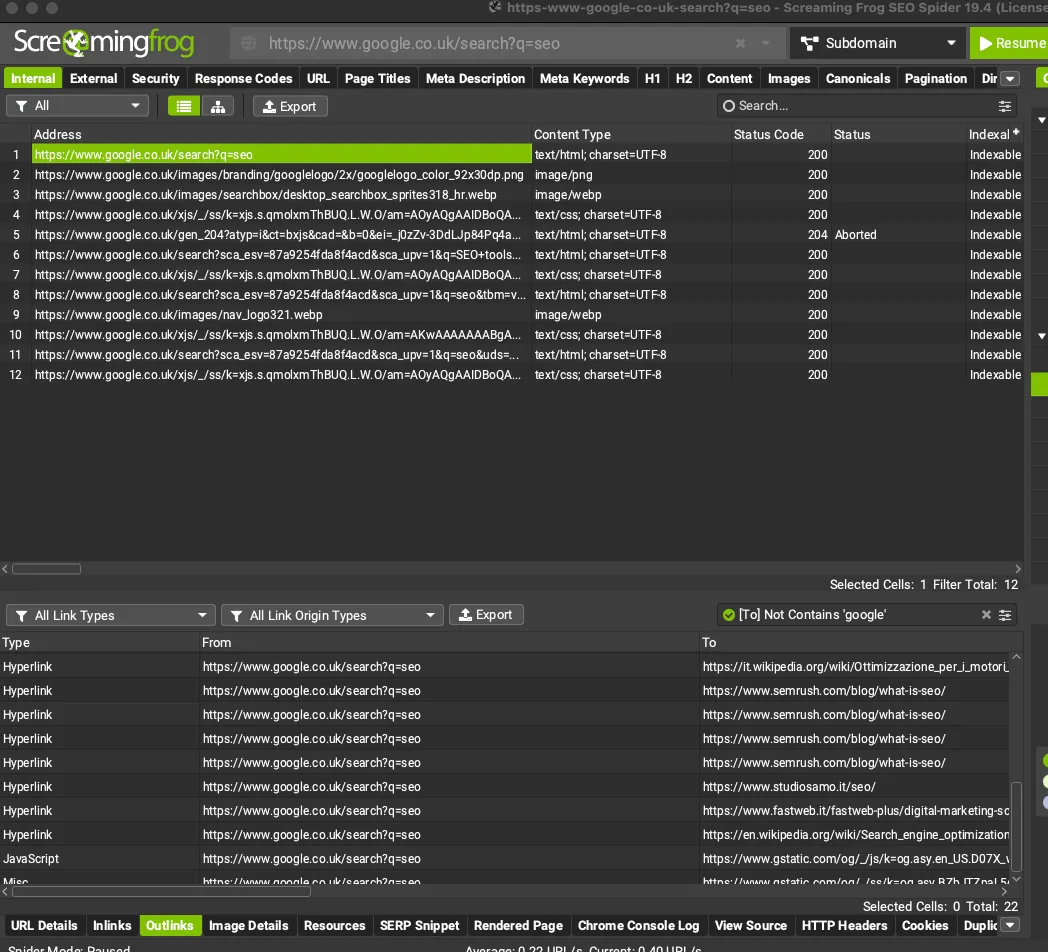
Par défaut, en crawlant les URL générées en mode List, tu obtiens déjà des résultats intéressants dans l’onglet inférieur « Outlinks », où se trouvent les URL positionnées pour la requête.
Comme tu le verras, il y aura beaucoup de liens vers Google : je te conseille donc d’utiliser le filtre de l’onglet inférieur avec la condition [To] Not Contains 'google'.
Au-delà de cette fonction de base, on peut réaliser des audits de SERP plus avancés avec la Custom Extraction, par exemple sur les « People Also Ask », les featured snippets, la présence de vidéos ou tout ce qui caractérise la SERP. Tu trouveras les syntaxes XPath avec le navigateur intégré de SEO Spider.
Exemple pratique : extraire les questions People Also Ask
L’objectif de ce test est d’extraire les données « People Also Ask » de la SERP. Notre requête de référence est « Cos’è la SEO » (« qu’est-ce que le SEO » en italien).
- On saisit l’URL générée avec le modèle :
https://www.google.it/search?q=cose+la+seo. - On ouvre 1Configuration›2Custom›3Custom Extraction et on utilise le navigateur intégré.
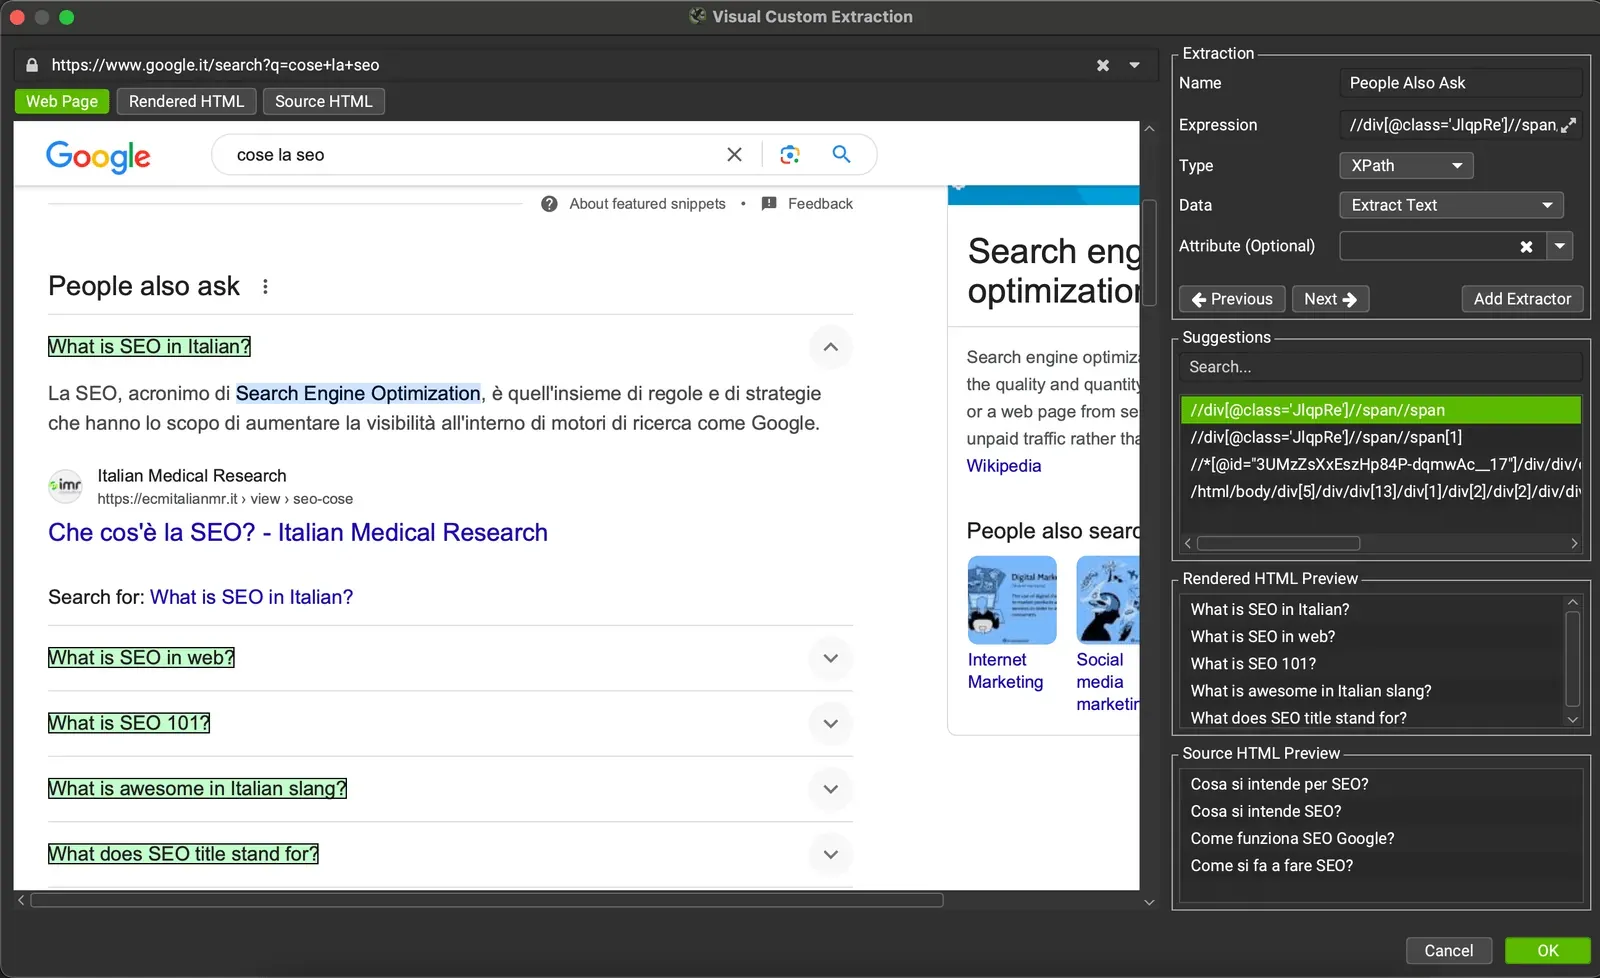
- On lance le crawl en mode List et on consulte les données dans l’onglet Custom Extraction.
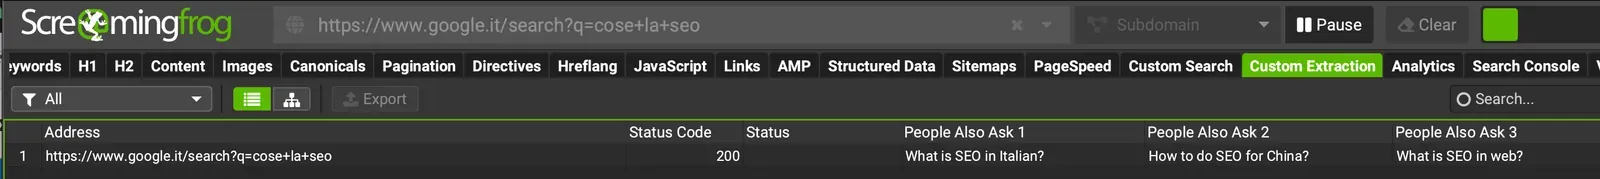
De la même façon, tu peux très simplement extraire toutes les autres fonctionnalités de Google et obtenir une vue d’ensemble et détaillée pour tes audits SEO.
Rappel : le modèle utilisé contient des syntaxes XPath préconfigurées, mais Google modifie souvent le code des SERP et elles peuvent ne plus donner de résultats fiables. Mon conseil : utilise toujours le navigateur intégré pour ces analyses.
Des questions sur Qu’est-ce que le web scraping ?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
