

¿Qué es el web scraping?.
Cómo hacer web scraping de las SERP con la Custom Extraction de Screaming Frog.
Qué es el web scraping, qué técnicas usa y qué límites legales tiene, del RGPD a los derechos de autor. En la segunda parte verás cómo aplicarlo al SEO con Screaming Frog, también para extraer datos de las SERP.
Qué es el web scraping
El web scraping, del inglés «to scrape» (raspar), es un método para recoger datos e información directamente de las páginas web o de las SERP, catalogarlos y guardarlos en una base de datos.
En algunos casos, todavía muy frecuentes, el web scraping se usa para recopilar nombres, apellidos y datos sensibles con los que crear bases de datos de marketing, pero esto es ilegal.
En otros casos puede usarse para campañas de phishing, suplantación de identidad o vulneración de derechos de autor.
Pese a estos abusos, el web scraping no es ilegal en sí mismo y permite obtener datos muy valiosos para el análisis SEO y para el marketing digital en general.
Cómo funciona el web scraping
El web scraping es una técnica de extracción automatizada de datos de sitios web mediante software o scripts específicos. Permite recoger información estructurada, como textos, imágenes u otros datos públicos, y procesarla según necesidades concretas.
Tecnologías y métodos
Los principales métodos de web scraping son:
- Parsing de HTML: uso de librerías como Beautiful Soup en Python para analizar el HTML de una página.
- Automatización del navegador: herramientas como Selenium que simulan a un usuario humano para navegar e interactuar con las páginas.
- API públicas: muchos sitios ofrecen API (Application Programming Interfaces) que dan acceso legal a los datos en un formato estructurado.
Aplicaciones del web scraping
Los usos más habituales son:
- Análisis de mercado: las empresas pueden seguir los precios de la competencia y las opiniones de los clientes.
- Investigación académica: recopilación de grandes volúmenes de datos para análisis estadísticos.
- Automatización: reducción del tiempo necesario para recoger datos manualmente de distintas fuentes.
Casos de uso reales
Un ejemplo concreto es el uso del «crawling web» en el e-commerce para actualizar los precios de forma dinámica según la competencia. Del mismo modo, las plataformas que agregan anuncios inmobiliarios usan el web scraping para mantener su base de datos al día.
Aspectos legales del web scraping
Por útil que sea, el web scraping plantea varias cuestiones legales. Entender y cumplir la normativa es esencial para evitar conflictos y proteger a todas las partes.
Por ejemplo, en algunas jurisdicciones el web scraping se considera una infracción de la propiedad intelectual o de los contratos, sobre todo cuando incumple las condiciones de uso de un sitio. Además, el acceso no autorizado a sistemas informáticos puede ser delito según leyes como la Computer Fraud and Abuse Act (CFAA) de Estados Unidos.
El RGPD y el web scraping
El Reglamento General de Protección de Datos (RGPD), vigente en la Unión Europea desde 2018, regula la recogida y el uso de los datos personales. Según el RGPD, cualquier dato que permita identificar a una persona es «personal» y está sujeto a normas estrictas: nombres, direcciones de email, números de teléfono, direcciones IP, etc.
Implicaciones para el web scraping
- Base jurídica de la recogida: las empresas deben identificar una base jurídica válida para recoger datos personales. Por ejemplo, el consentimiento explícito del interesado (artículo 6 del RGPD) o un interés legítimo que no prevalezca sobre sus derechos fundamentales.
- Transparencia e información: hay que informar claramente a los usuarios de cómo se usarán sus datos, con avisos de privacidad que describan las finalidades y los métodos de recogida.
- Minimización de datos: el RGPD exige recoger solo los datos mínimos necesarios para un fin legítimo (principio de minimización).
- Seguridad de los datos: los datos recogidos deben protegerse frente a accesos no autorizados con medidas técnicas y organizativas adecuadas (artículo 32).
Ejemplos prácticos
Un caso conocido que muestra los problemas del RGPD con el crawling es el de empresas que usan scraping para recoger emails o perfiles de LinkedIn sin consentimiento. Estas conductas han dado lugar a sanciones administrativas importantes según los artículos 83 y 84 del RGPD, que prevén multas de hasta 20 millones de euros o el 4 % de la facturación anual global.
Las empresas que hacen web scraping también deben tener en cuenta el derecho de supresión (artículo 17), conocido como «derecho al olvido», que permite a los usuarios pedir que se eliminen sus datos.
Propiedad intelectual y web scraping
Las leyes de propiedad intelectual, incluidos los derechos de autor, también se aplican a los contenidos online.
Aspectos legales
- Contenidos protegidos por derechos de autor: copiar textos, imágenes u otros elementos protegidos sin permiso está prohibido. Esto vale también para contenidos públicos pero protegidos, como artículos de prensa, imágenes o bases de datos protegidas.
- Condiciones de uso: la mayoría de los sitios prohíben el web scraping en sus condiciones de uso. Ignorar estas restricciones puede llevar a pleitos, como han demostrado varios casos internacionales.
Casos conocidos
Un caso emblemático fue el litigio entre LinkedIn y HiQ Labs, en el que LinkedIn intentó impedir que HiQ recogiera datos públicos de los perfiles. La disputa giró en torno a dos cuestiones clave: el incumplimiento de las condiciones de uso de LinkedIn y un posible conflicto con la libre competencia. Aunque al principio HiQ ganó, el caso puso de relieve la complejidad legal del web scraping.
Otro ejemplo importante son los litigios por el uso de imágenes protegidas mediante scraping. Un caso famoso es el de Getty Images, que emprendió acciones legales contra plataformas que usaban software de scraping para obtener y redistribuir imágenes sin licencia.
Cumplimiento y soluciones
Para no infringir la propiedad intelectual:
- Comprobar los derechos de uso: antes de usar datos obtenidos por scraping, asegúrate de que no estén protegidos.
- Pedir licencias: cuando proceda, obtén licencias o permisos para usar contenidos protegidos.
- Usar fuentes de datos abiertos: prioriza datos y contenidos publicados con licencias abiertas (como Creative Commons), que permiten un uso legal y gratuito.
Afrontar las cuestiones de propiedad intelectual es clave para evitar litigios y proteger la reputación de la empresa.
Buenas prácticas para una extracción conforme
Cumplir la normativa es crucial para evitar problemas legales y garantizar un uso ético del web scraping y de la privacidad de los datos.
Estrategias recomendadas
- Obtener permisos: contactar con los propietarios de los sitios para obtener autorización explícita antes de recoger datos.
- Respetar las políticas de privacidad: consultarlas y cumplirlas.
- Usar API: preferir las API oficiales al scraping directo del HTML.
- Anonimizar los datos: eliminar cualquier información personal de los datos recogidos siempre que sea posible.
Redactar políticas internas
Las empresas que hacen web scraping deberían:
- documentar claramente sus procedimientos de recogida de datos;
- ofrecer información detallada sobre las medidas adoptadas para garantizar el cumplimiento.
Web scraping para el SEO
Marketing digital y scraping
Después de ver el potencial y los riesgos del «crawling salvaje», veamos sus aplicaciones en el SEO y el marketing digital en general, y cómo aprovecharlo con un software de web scraping como Screaming Frog.
Tras años en los que esta actividad requería conocimientos técnicos de nivel medio-alto, hoy existen herramientas no-code que logran resultados notables en la extracción de datos.
En la base del web scraping ético está un estándar llamado XPath, que permite localizar y manejar con bastante facilidad los distintos nodos de un documento HTML.
Ventajas del web scraping para el SEO
El web scraping ofrece varias ventajas para la optimización en buscadores (SEO):
- Investigación de palabras clave: permite recoger una gran variedad de datos, incluidas las palabras clave que usa la competencia o que aparecen en los sitios más relevantes de un sector. Con esta información puedes detectar nuevas oportunidades y mejorar tu estrategia SEO (análisis de encabezados, meta etiquetas, etc.).
- Seguimiento de la competencia: con el web scraping puedes seguir de forma constante la actividad de la competencia: cambios en su estrategia SEO, nuevos contenidos, actualizaciones del algoritmo de Google y más. Información muy valiosa para adaptar tu propia estrategia.
- Actualización de los datos: bien usado, mantiene al día los datos que usas para el SEO. Por ejemplo, puedes seguir de forma continua los resultados y los cambios de posición de ciertas palabras clave, y recoger datos sobre nuevas tendencias de búsqueda y comportamiento de los usuarios.
- Análisis de backlinks: el web scraping puede servir para extraer información sobre backlinks de sitios relevantes o competidores, para encontrar nuevas oportunidades de link building y valorar la calidad de los backlinks existentes (servicios como Semrush o Ahrefs).
- Scraping de contenidos: usado de forma ética y conforme a la normativa, permite recoger contenidos relevantes de otras fuentes para enriquecer tu sitio o crear contenidos nuevos de calidad combinando fuentes.
En resumen, el web scraping ofrece a los especialistas SEO herramientas y datos útiles para optimizar el rendimiento de los sitios en los buscadores. Pero es importante usar esta información de forma responsable y conforme a la ley, para evitar litigios o penalizaciones.
Web scraping con Screaming Frog
Custom Extraction y Visual Custom Extraction
Visto lo importante de esta actividad, veamos cómo usar una herramienta de data scraping como Screaming Frog para extraer información valiosa y mejorar nuestra estrategia de marketing digital.
Con SEO Spider podrás recoger datos de páginas web de forma rápida y eficiente para analizar tu sitio o hacer comparativas de la competencia, incluso muy avanzadas.
Con XPath y la Custom Extraction, tus análisis ya no serán los mismos. Además, desde la versión 19 de SEO Spider, la Visual Custom Extraction hace el scraping personalizado aún más sencillo e intuitivo, sin necesidad de conocimientos previos.
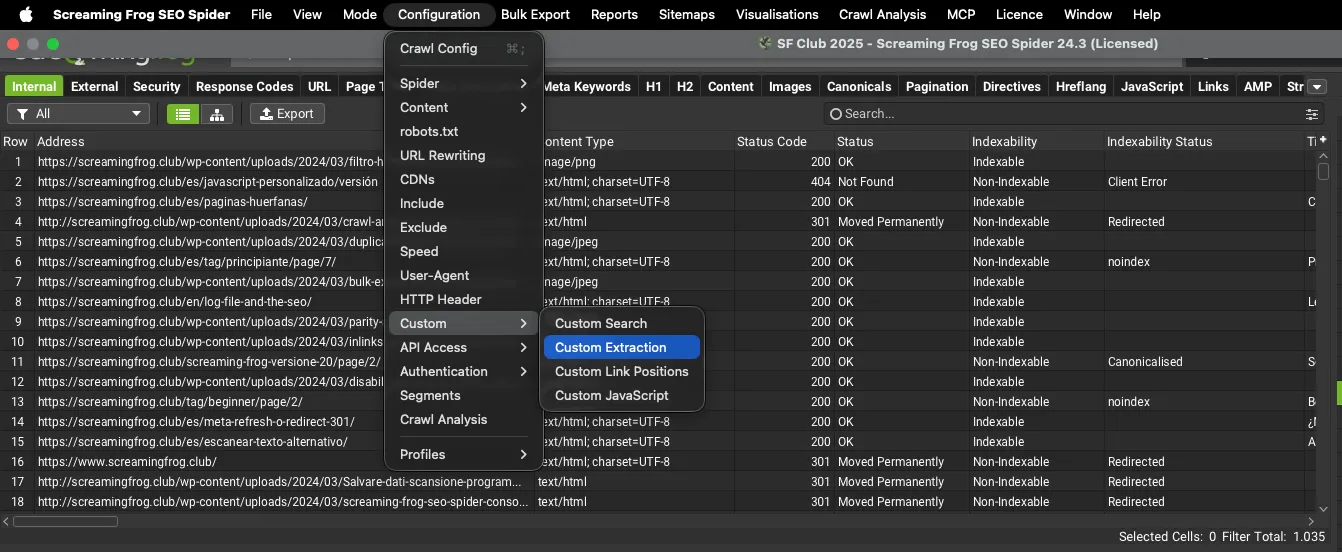
Para empezar, abre 1Configuration›2Custom›3Custom Extraction.
Una vez dentro, basta con hacer clic en Add abajo a la derecha e introducir la expresión de scraping.
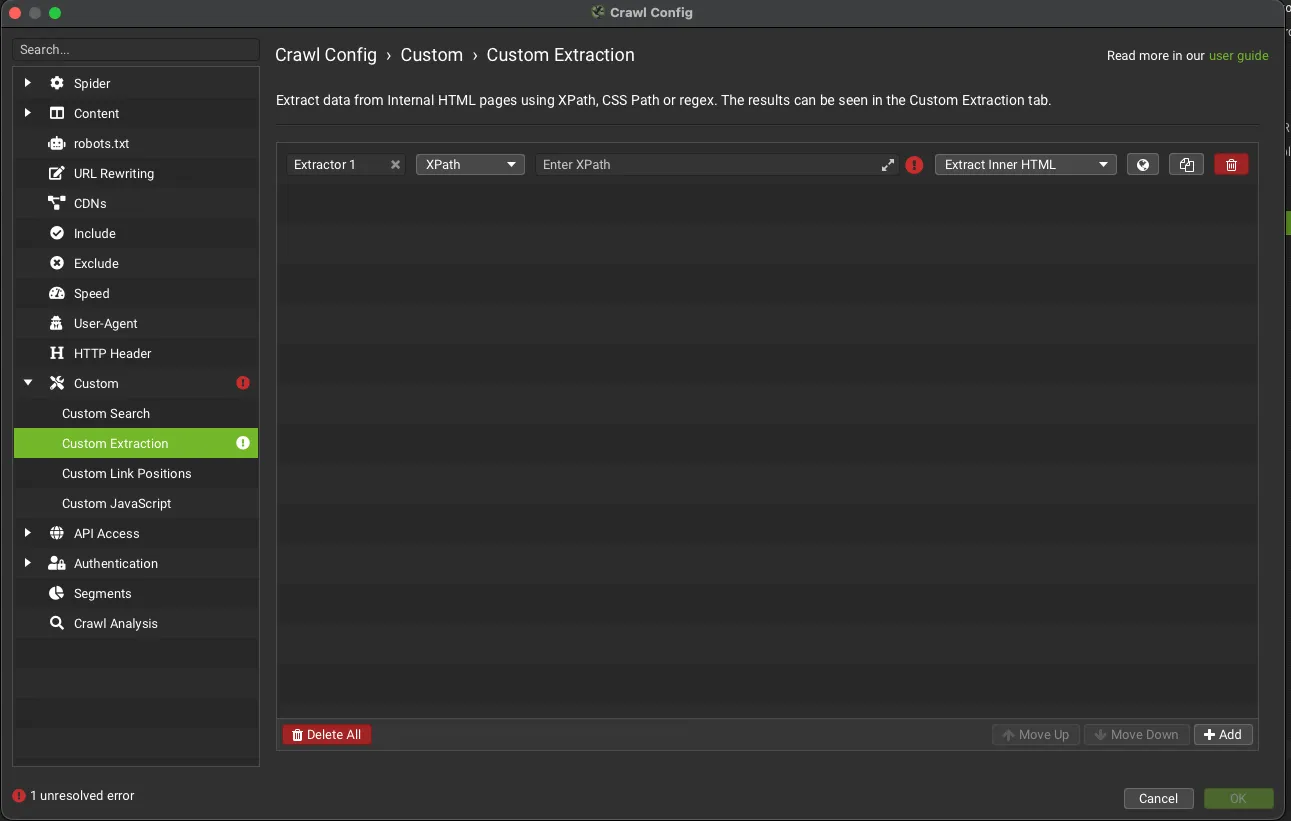
Si ya dominas las expresiones XPath, puedes escribirlas directamente en la celda «Enter XPath»; si no, usa la versión «Visual» de SEO Spider, que en pocos clics te deja ver qué información extraer con el navegador interno de Screaming Frog.
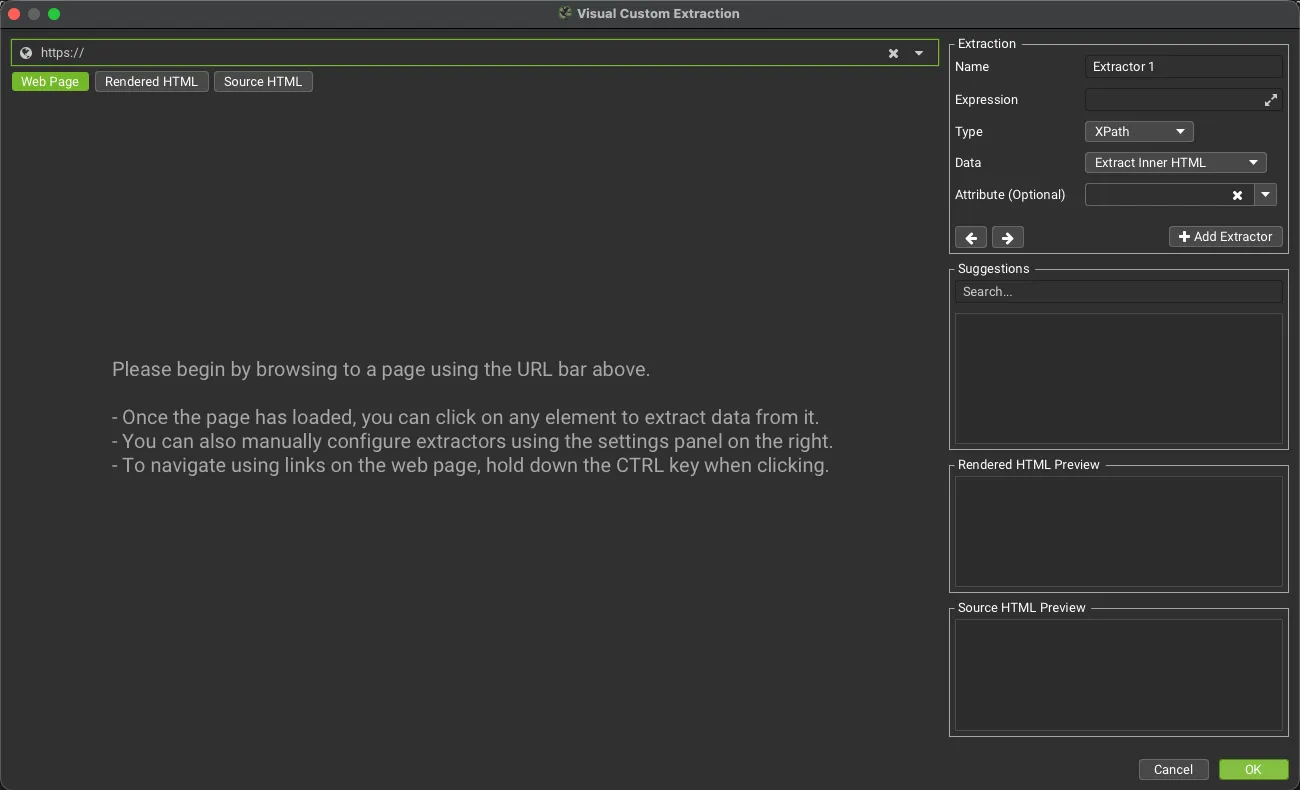
Después, al seleccionar en la página el elemento que quieres extraer, SEO Spider resalta la zona, crea varias expresiones sugeridas (a la derecha) y muestra una vista previa de lo que se extraerá del HTML sin procesar o renderizado.
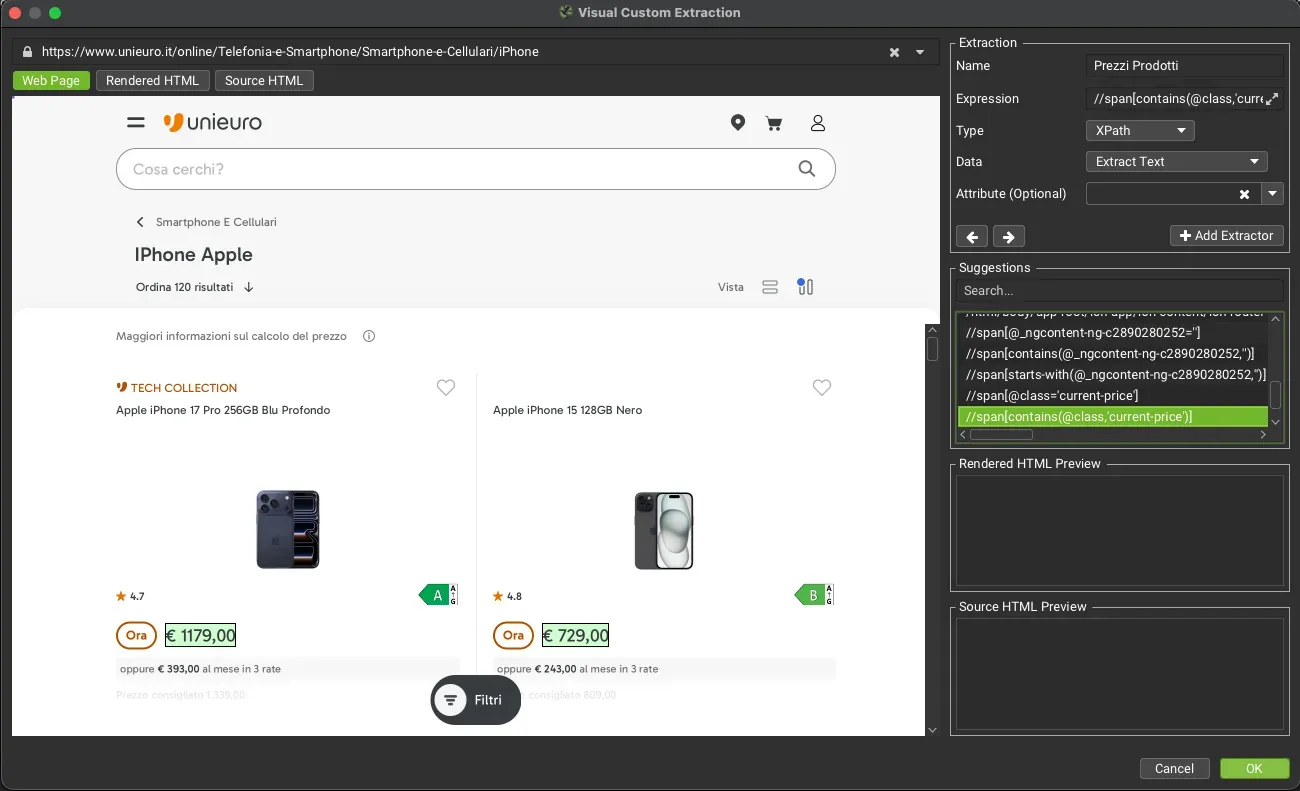
En el ejemplo de arriba he seleccionado los precios de los productos (haciendo clic en ellos) y, como ves a la derecha, SEO Spider ha introducido la sintaxis de extracción correcta.
Hay básicamente 4 tipos de extracción («Data»):
- Extract HTML Element: el elemento seleccionado y todo su HTML interno.
- Extract Inner HTML: el HTML interno del elemento seleccionado. Si contiene otros elementos HTML, se incluyen.
- Extract Text: el contenido de texto del elemento seleccionado y de sus posibles hijos.
- Function Value: el resultado de la función indicada, por ejemplo count(//h1) para saber cuántas etiquetas h1 tiene una página.
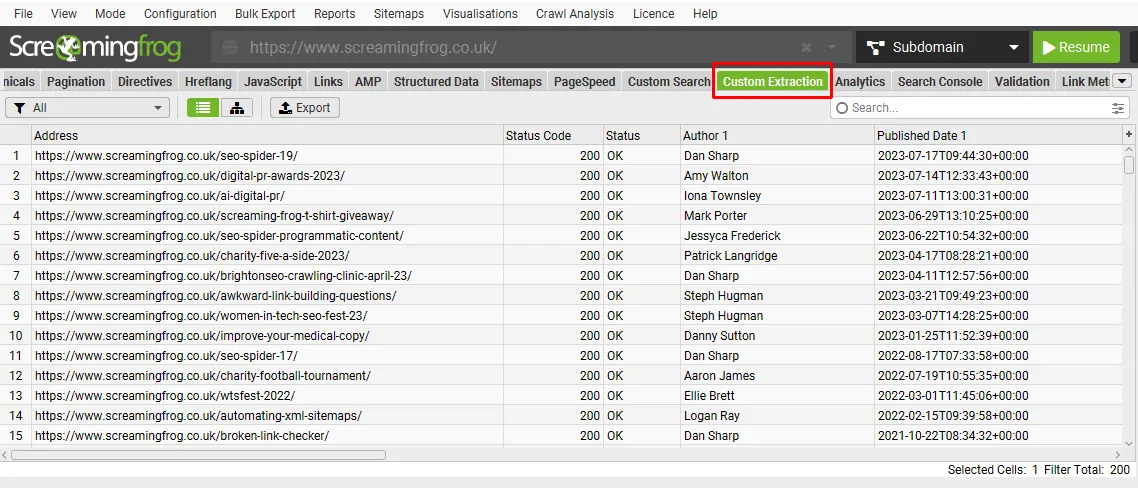
Terminado el rastreo, encontrarás los resultados de la Custom Extraction en su pestaña; si hay varias extracciones, usa los filtros para pasar de una a otra.
Scraping de las SERP
Además del scraping de tu propio sitio o de sitios de la competencia, también puedes extraer datos de directorios y del propio buscador. Hay que hacerlo con cuidado para que no te bloqueen la IP, pero es muy útil, por ejemplo, para recoger datos de posicionamiento de palabras clave estratégicas.
Screaming Frog no sustituye a servicios como Semrush, pero para las palabras clave en las que quieres posicionarte es una buena herramienta para ver la posición de la competencia, las características de los sitios mejor posicionados, etc.
- El primer paso es crear una URL de búsqueda de Google que SEO Spider rastreará. Puedes hacerlo fácilmente con esta plantilla de Google Sheets.
- El segundo paso es configurar SEO Spider adecuadamente:
- Usar el renderizado JavaScript: 1Configuration›2Spider›3Rendering.
- Activar «Ignore robots.txt»: 1Configuration›2robots.txt.
- Usar el user agent «Chrome»: 1Configuration›2User-Agent.
- Reducir la velocidad de rastreo (Max Threads = 1, Max URI/s = 0,5): 1Configuration›2Speed.
Te aconsejo guardar esta configuración como nuevo perfil en 1Configuration›2Profiles›3Save As…, para reutilizarla cuando la necesites.
Para profundizarCrawl Profiles.Cómo guardar y cargar los perfiles de configuración de SEO Spider, por ejemplo el del scraping de las SERP.Leer la guíaConfigurar el rastreo en modo List
Terminada la configuración técnica de Screaming Frog, toca definir la sintaxis para extraer datos personalizados de las SERP con un rastreo en modo List: 1Mode›2List.
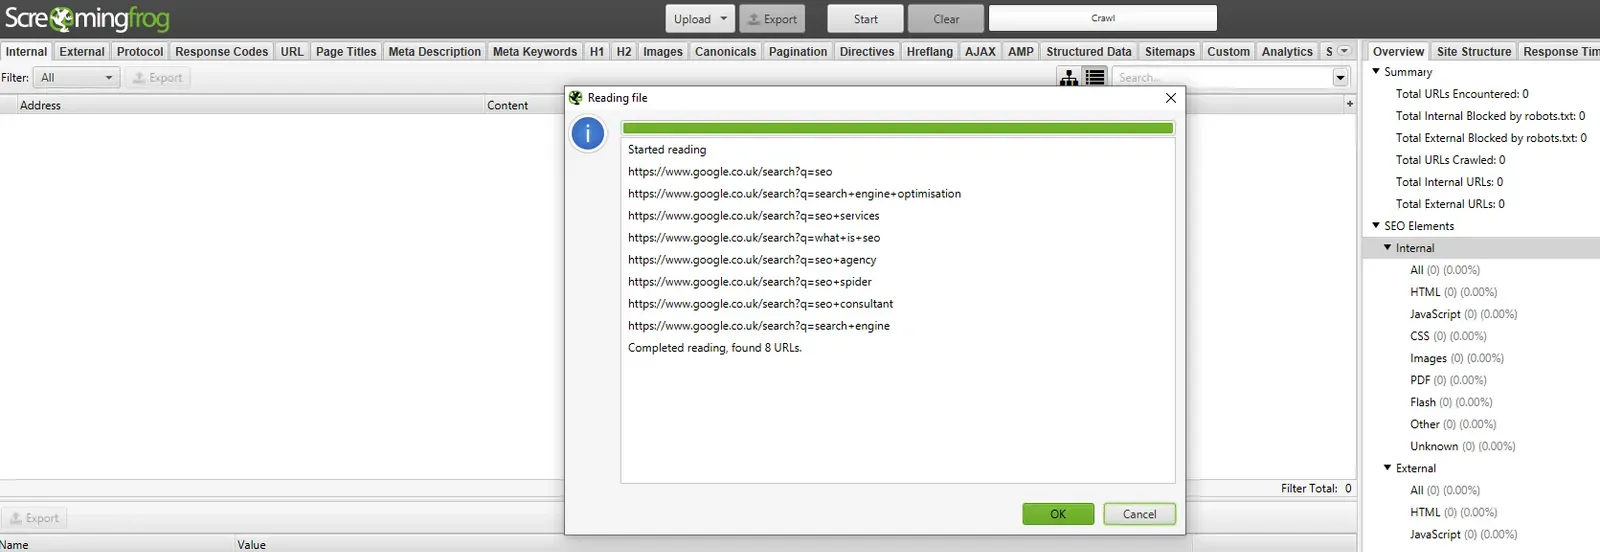
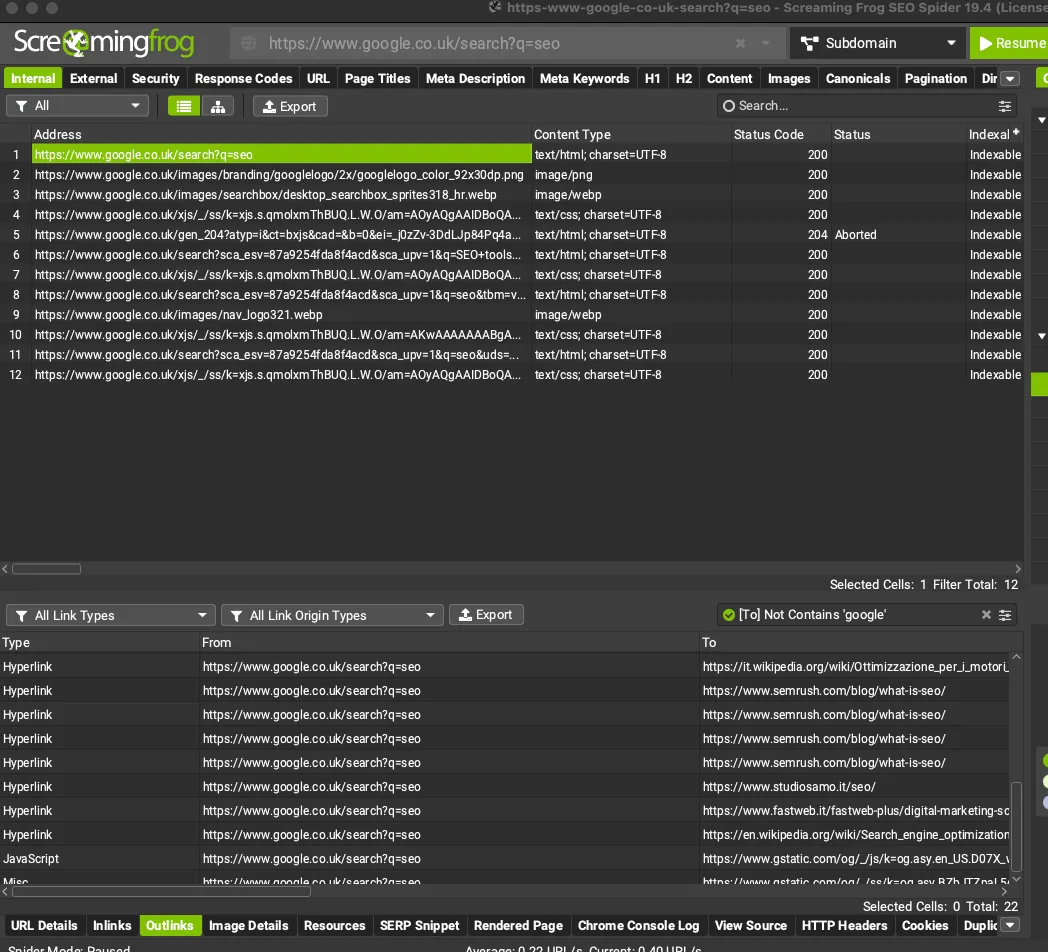
Por defecto, al rastrear en modo List las URL generadas, ya obtendrás resultados interesantes en la pestaña inferior «Outlinks», donde aparecen las URL posicionadas para esa consulta.
Como verás, habrá muchos enlaces hacia Google, así que te aconsejo usar el filtro de la pestaña inferior con la condición [To] Not Contains 'google'.
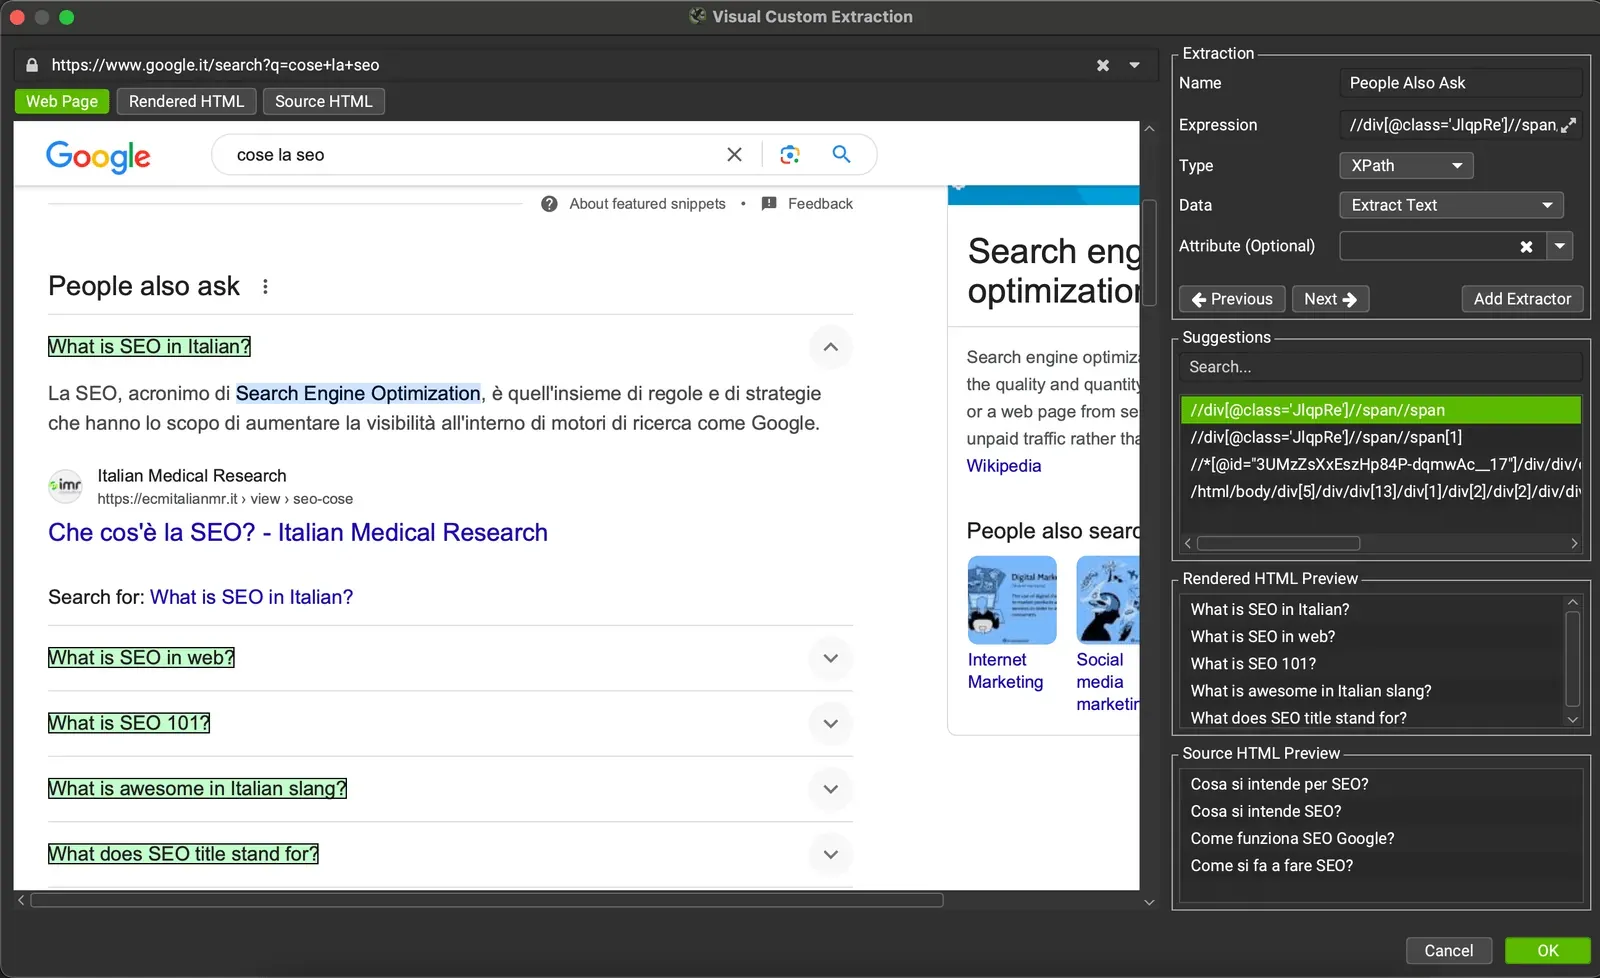
Además de esta función básica, podemos hacer auditorías de SERP más avanzadas con la Custom Extraction, por ejemplo de los «People Also Ask», los fragmentos destacados, la presencia de vídeos u otros elementos que definen la SERP. Encontrarás las sintaxis XPath con el navegador interno de SEO Spider.
Ejemplo práctico: extraer las preguntas People Also Ask
El objetivo de esta prueba es extraer los datos de «People Also Ask» de la SERP. Nuestra consulta de referencia es «Cos’è la SEO» («qué es el SEO» en italiano).
- Introducimos la URL generada con la plantilla:
https://www.google.it/search?q=cose+la+seo. - Abrimos 1Configuration›2Custom›3Custom Extraction y usamos el navegador interno.
- Lanzamos el rastreo en modo List y consultamos los datos en la pestaña Custom Extraction.
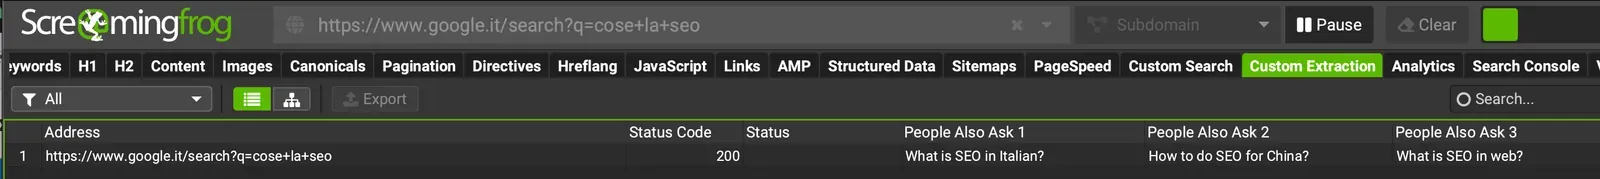
Del mismo modo podrás extraer de forma muy sencilla todas las demás funciones de Google y obtener una visión de conjunto y detallada para tus auditorías SEO.
Recuerda: la plantilla que has usado trae algunas sintaxis XPath ya configuradas, pero Google cambia a menudo el código de las SERP y puede que no den resultados fiables. Mi consejo es usar siempre el navegador interno para estos análisis.
¿Dudas sobre Qué es el web scraping?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
