

Rastrear sitios de gran tamaño.
Cómo rastrear sitios de gran tamaño con el modo "Database Storage" y algunos trucos.
Cómo rastrear sitios de millones de URL sin bloquear el ordenador: modo Database Storage, memoria asignada, elección de los elementos que rastrear, exclusiones, include y muestreos.
El modo Database Storage
Para rastrear un sitio de millones de URL, el modo «Memory Storage», que guarda los datos en la RAM, no es la opción recomendada, así que mi primer consejo es pasar a «Database Storage» desde 1File›2Settings›3Storage Mode (en Mac el menú Settings está en Screaming Frog SEO Spider).
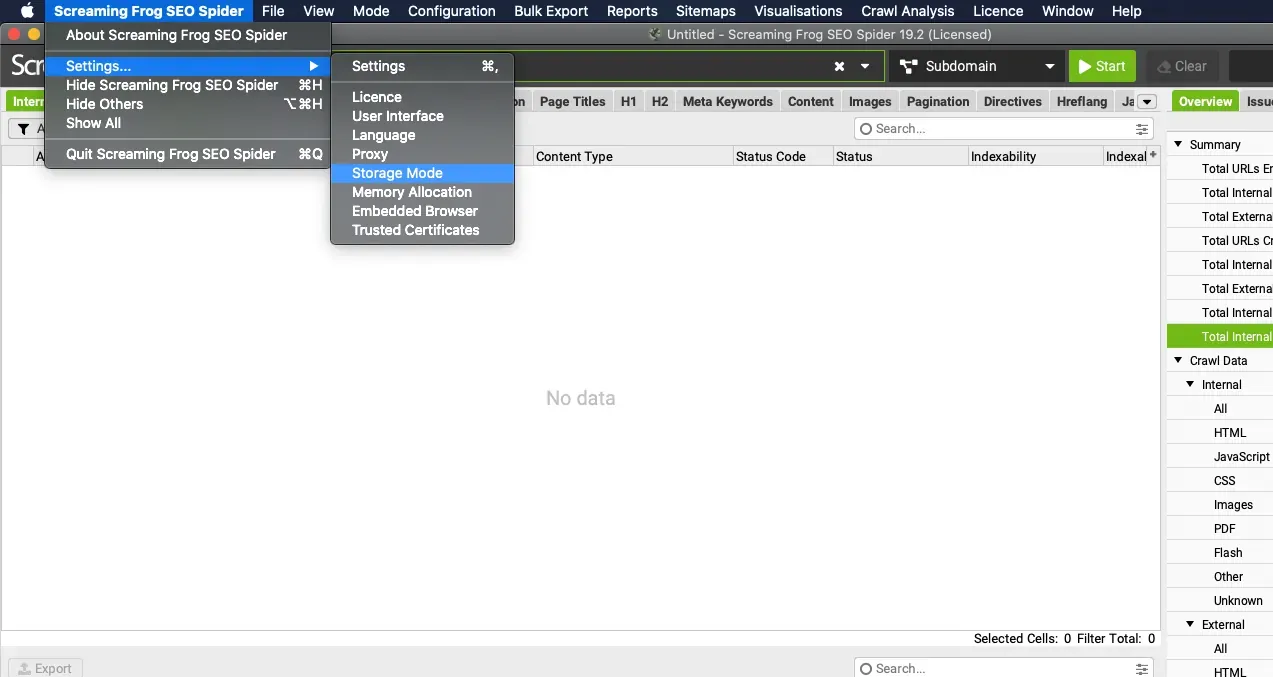
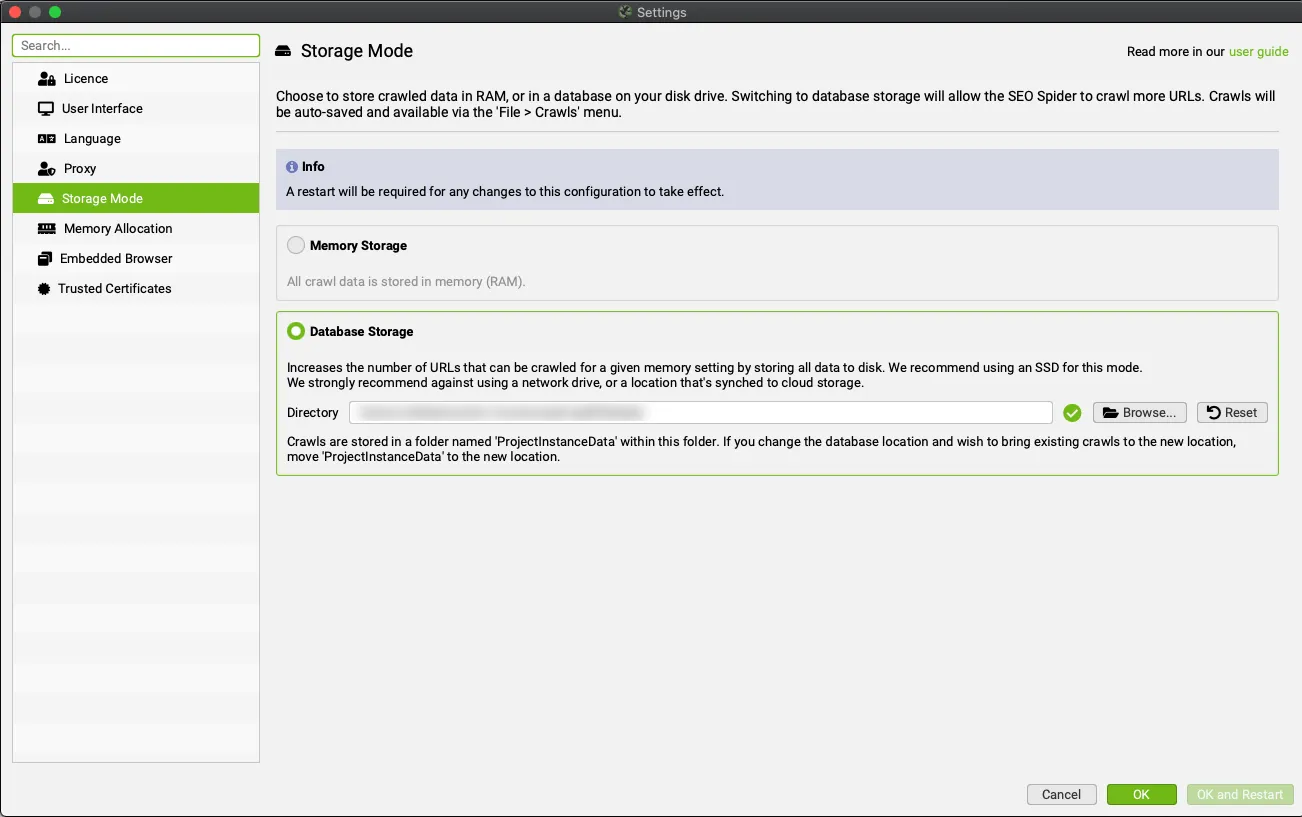
Para sacar el máximo rendimiento de SEO Spider en este modo, conviene usar un SSD interno, o externo si tu sistema admite UASP.
Memoria asignada
Elegido el modo «Database Storage», el segundo paso es aumentar la memoria asignada desde 1File›2Settings›3Memory Allocation.
Aquí tienes una comparación de rendimiento según el número máximo de URL que se pueden rastrear.
| Memoria asignada | Modo RAM | Database Storage |
|---|---|---|
| 4 GB | 2-3 millones de URL | |
| 8 GB | 200.000 URL (requisito mínimo para sitios grandes) | 5 millones de URL |
| 16 GB | 10 millones de URL |
Estas cifras son solo orientativas: parte siempre de la idea de que, cuanta más memoria asignes, mejor rendirá SEO Spider.
Reducir los datos que rastrear
Atributos que rastrear
No siempre hace falta rastrear un sitio entero, así que es buena práctica adaptar el rastreo al objetivo concreto del análisis. Recuerda que, cuantos más datos recoges, más RAM necesitas.
Para elegir qué métricas rastrear y cuáles dejar fuera, cambia directamente los ajustes de SEO Spider en 1Configuration›2Spider›3Crawl.
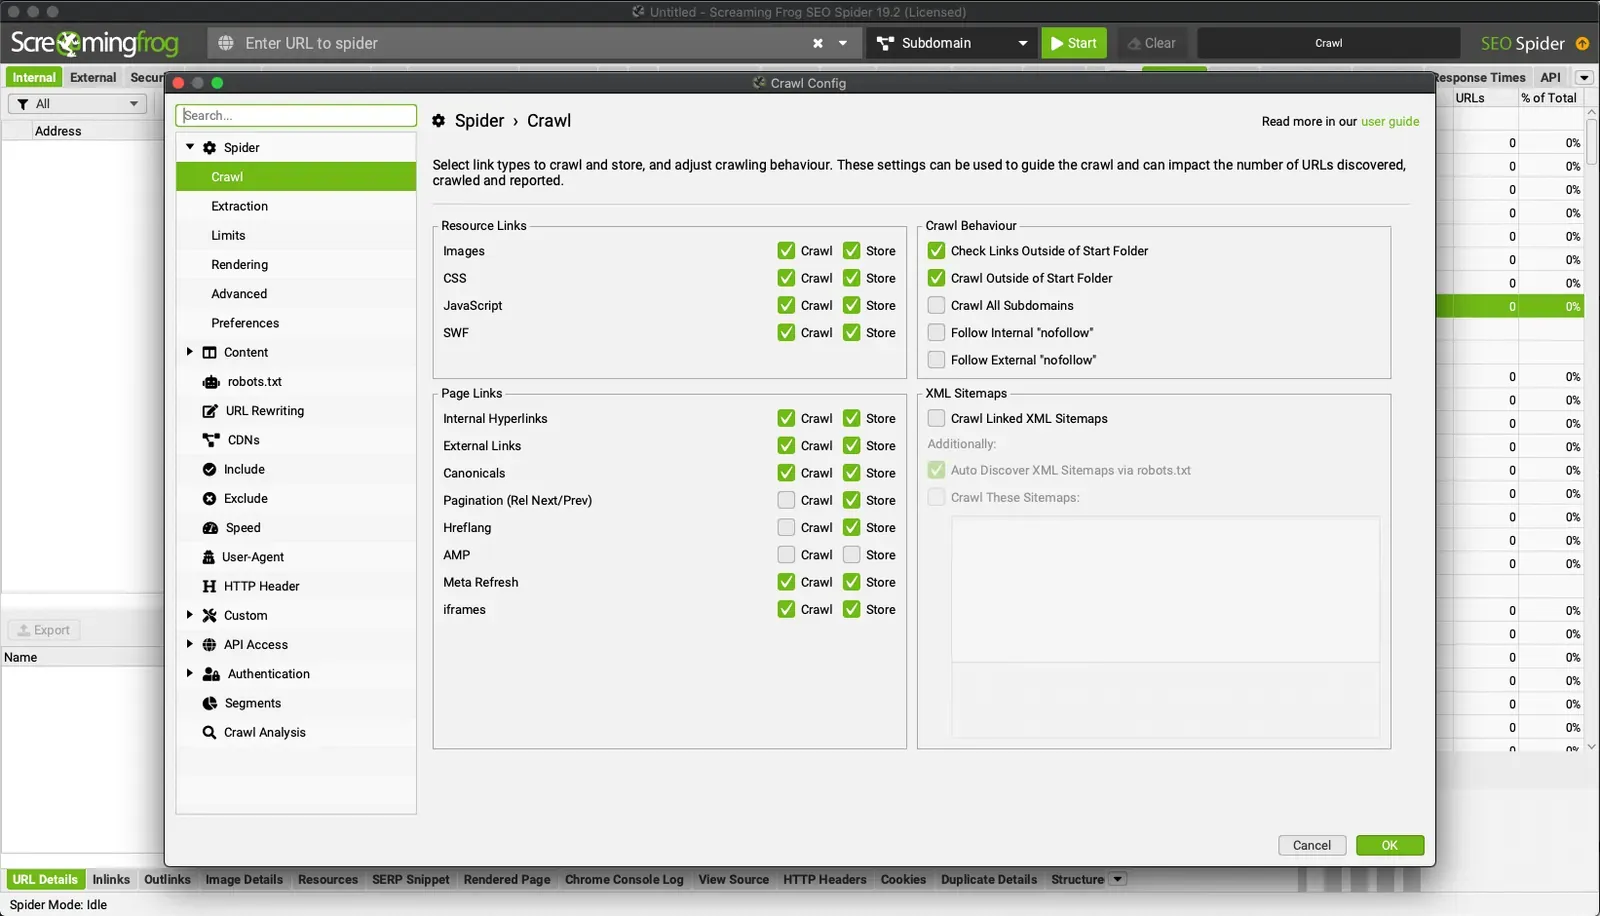
Según el tipo de análisis, puedes desactivar el rastreo y el almacenamiento de estos elementos:
- Images*;
- CSS*;
- JavaScript*;
- SWF*.
*En términos de memoria tiene mucho sentido desactivar estos recursos, pero si usas el modo de renderizado JavaScript tendrás que dejarlos activos para no perjudicar el renderizado.
- External Links;
- Canonicals;
- Pagination;
- Hreflang;
- AMP.
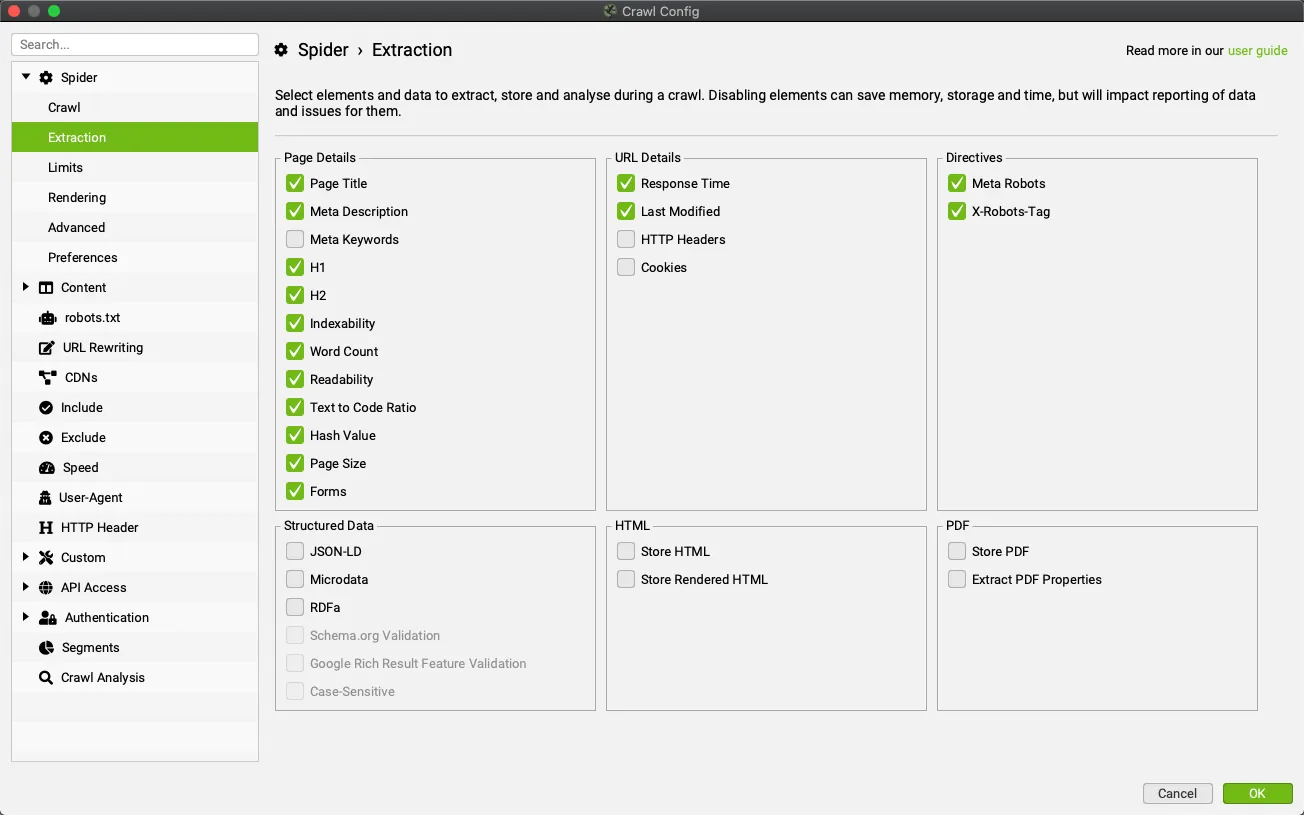
También puedes desactivar la extracción de elementos no esenciales como las «Meta Keywords» u otros atributos que no necesites estrictamente para el análisis, desde 1Configuration›2Spider›3Extraction, eligiendo entre los «Page Details» (p. ej. page title, word count, headings), los detalles de URL, las directivas o los datos estructurados.
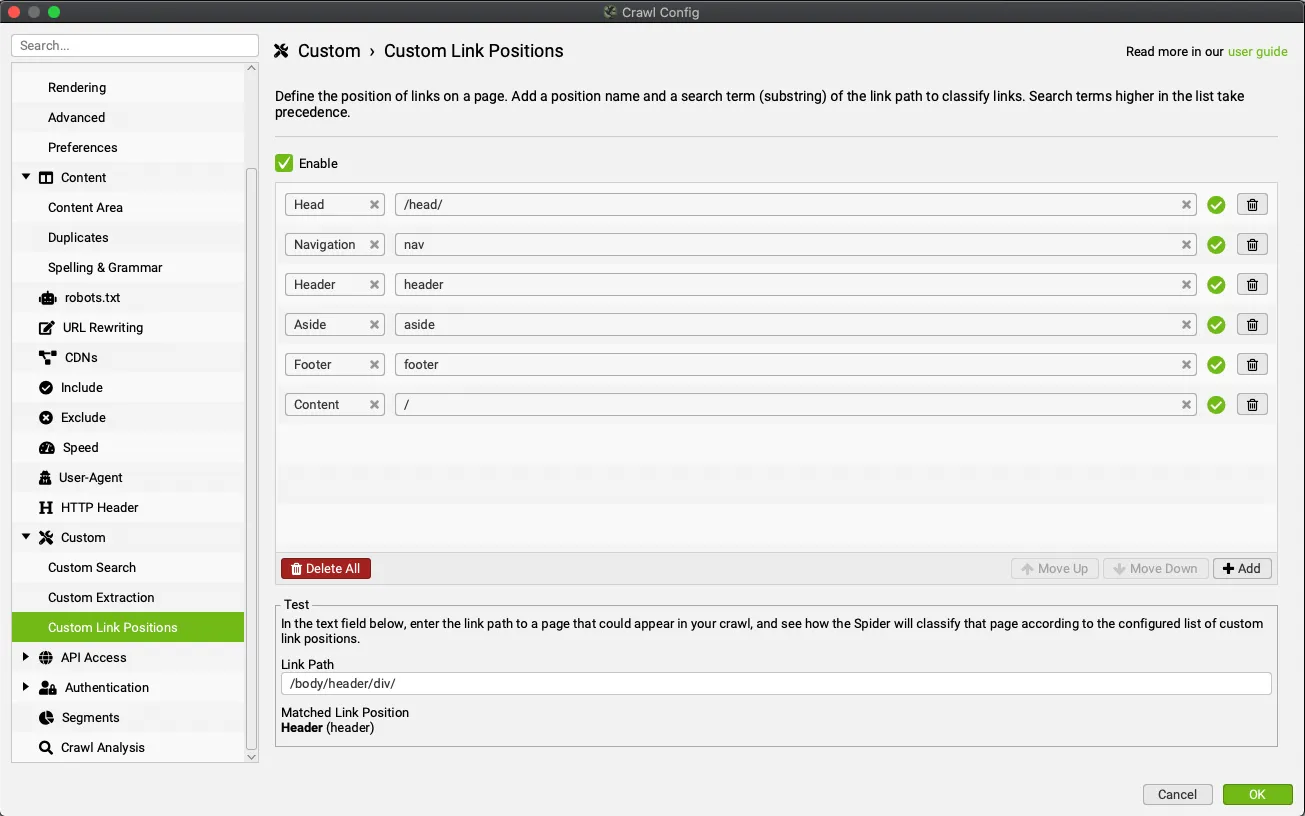
Además de lo anterior, te aconsejo desactivar la función de posición de los enlaces en 1Configuration›2Custom›3Custom Link Positions.
Otra buena práctica es evitar rastrear con funciones avanzadas como estas, que puedes añadir en una segunda fase del análisis:
- Custom Search.
- Custom Extraction.
- Integración con Google Analytics.
- Integración con Google Search Console.
- Integración con PageSpeed Insights.
- Spelling & Grammar.
- Integración con Link Metrics (Majestic, Ahrefs y Moz).
Excluir URL
Para un rastreo más ligero y con menos consumo de memoria, puedes limitarlo a zonas concretas del sitio y excluir elementos como las ordenaciones generadas por la «navegación facetada», parámetros concretos de las URL o URL infinitas con directorios repetidos, con la función 1Configuration›2Exclude.
Mediante expresiones Regex, esta función te permite excluir las URL que no quieres rastrear. Pero cuidado: si las URL excluidas contienen enlaces a otras páginas, esas páginas tampoco se rastrearán.
Para entender bien la importancia de la función «Exclude», veamos un caso real: el sitio de John Lewis.
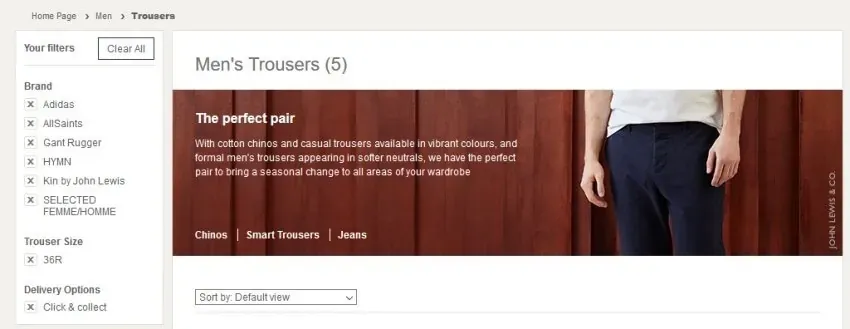
Con los ajustes por defecto de SEO Spider, por culpa de las numerosas ordenaciones, el rastreo incluiría una serie infinita de URL como esta:
https://www.johnlewis.com/browse/men/mens-trousers/adidas/allsaints/gant-rugger/hymn/kin-by-john-lewis/selected-femme/homme/size=36r/_/N-ebiZ1z13ruZ1z0s0la1Esto es muy habitual en los e-commerce que usan la «navegación facetada» para marcas, color, corte de los pantalones, etc., creando combinaciones infinitas y lastrando inevitablemente el rastreo.
En este caso concreto, basta con hacer un rastreo de muestra del sitio para detectar este tipo de patrón de URL con parámetros y excluirlo.
Limitar el área de rastreo
Subcarpetas y subdominios
Si el sitio es muy grande, puedes plantearte rastrear por separado los subdominios o, de forma aún más detallada, subcarpetas concretas.
Por defecto, SEO Spider solo rastrea el subdominio introducido, y los demás subdominios que encuentre se tratan como enlaces externos y aparecen en la pestaña ‘External’.
Puedes elegir rastrear todos los subdominios, pero, lógicamente, necesitarás más memoria.
SEO Spider también se puede configurar para rastrear solo una subcarpeta: introduce la URL de la subcarpeta con su ruta y desactiva, en 1Configuration›2Spider›3Crawl, las opciones Check Links Outside of Start Folder y Crawl Outside of Start Folder.
Por ejemplo, supongamos que solo quieres rastrear el blog del sitio de Screaming Frog.
El primer paso es identificar la subcarpeta y lanzar el rastreo; en nuestro caso: https://www.screamingfrog.co.uk/blog/.

Nota: para rastrear una subcarpeta, recuerda añadir la barra final «/blog**/**»; si no, SEO Spider no la reconoce como tal. Puedes tener el mismo problema si la versión con «/» redirige a la versión sin ella.
En ese segundo caso puedes usar la función «include» con una regla Regex (por ejemplo «.*blog.*»).
Para profundizarRastreo de subcarpetas.Cómo limitar el rastreo a una o varias subcarpetas con los ajustes de carpeta y la función Include.Leer la guíaLa función Include
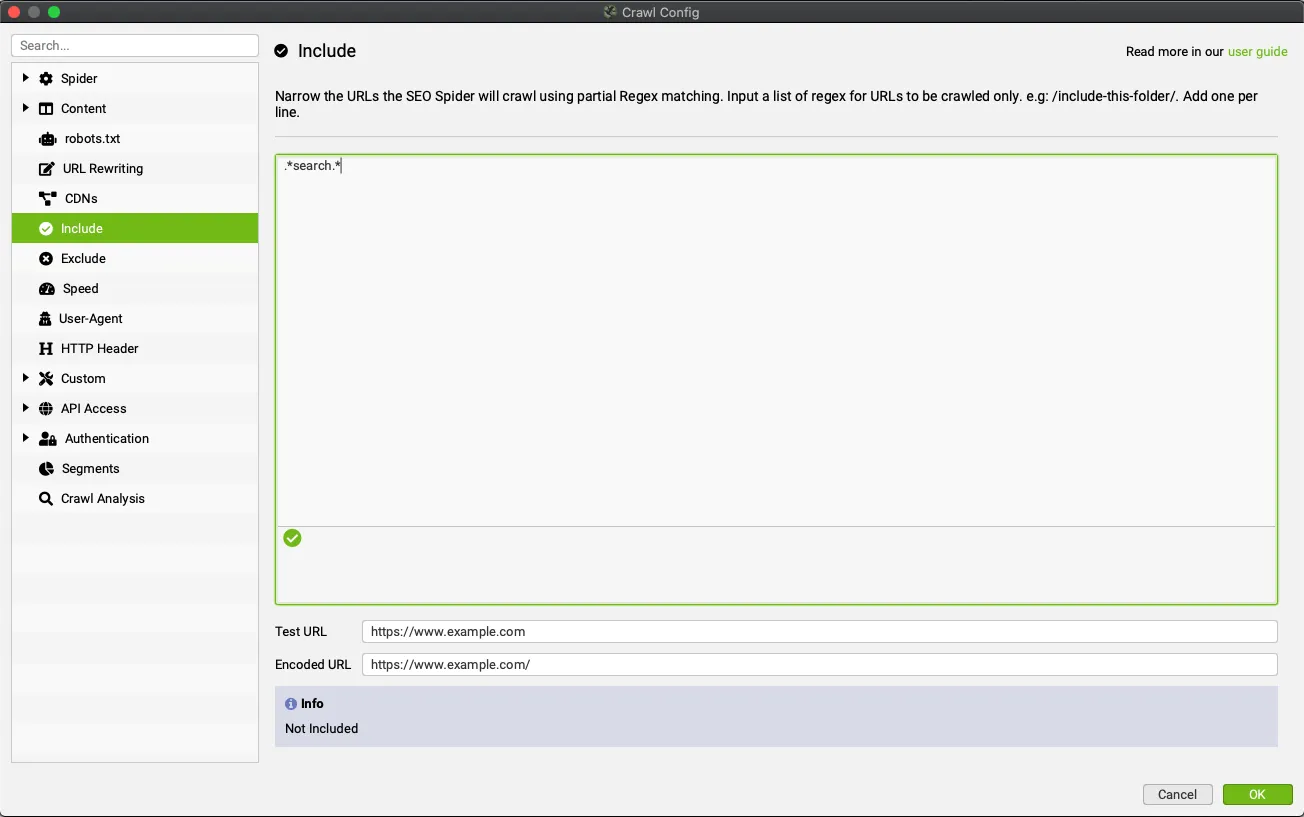
Además de excluir áreas y/o desactivar elementos que rastrear y guardar, puedes usar la función 1Configuration›2Include, que limita las URL que rastrear mediante expresiones Regex.
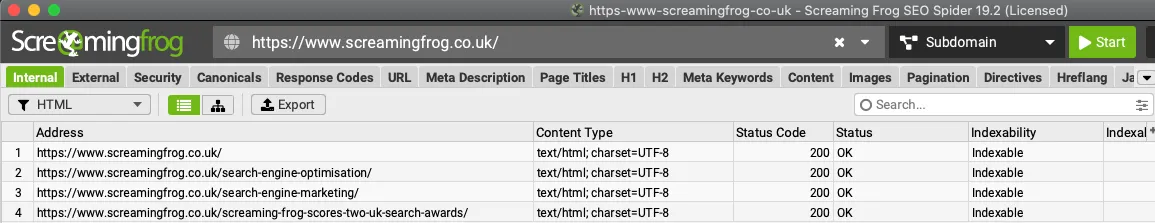
Por ejemplo, si solo quieres rastrear las páginas que tienen «search» en la URL, basta con añadir la Regex «.*search.*» en la función «include».
En el sitio de Screaming Frog obtendrías estos resultados.
Muestreos
Otra forma de ahorrar tiempo y aligerar el rastreo es trabajar con muestras del sitio mediante los límites de 1Configuration›2Spider›3Limits:
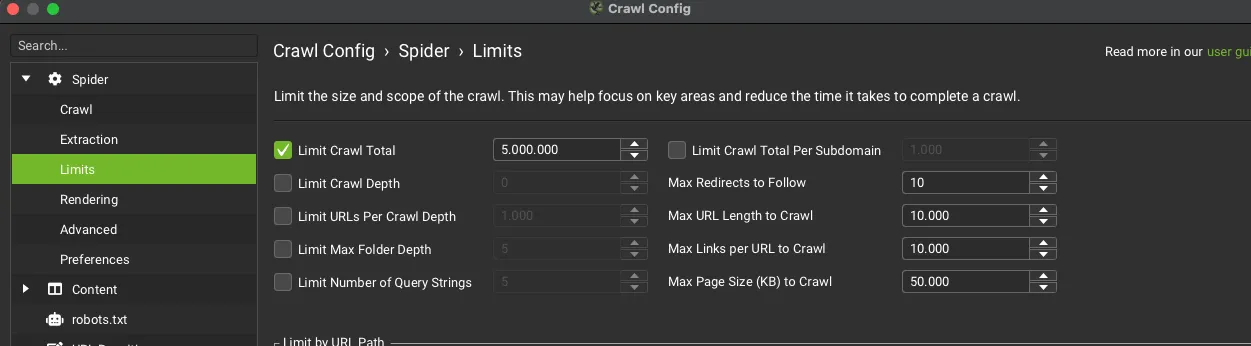
Limit Crawl Total: fija el número máximo de páginas que rastrear en total.
Limit Crawl Depth: limita la profundidad del rastreo a las páginas más cercanas, en clics, a la página de inicio (o la home) para obtener una muestra de todas las plantillas.
Max URL Length to Crawl: solo rastrea URL hasta un número máximo de caracteres, evitando las URL muy profundas.
Limit Max Folder Depth: limita el rastreo según la profundidad de las carpetas.
Limit Number of Query Strings: limita el rastreo de parámetros según el número de query strings. Si pones el límite en ‘1’, SEO Spider rastreará URL con un único parámetro como máximo (?=color, por ejemplo), evitando combinaciones infinitas.
Vídeo tutorial (en italiano)
¿Dudas sobre Rastrear sitios de gran tamaño?
Estas guías nacen de proyectos reales. Si algo no cuadra en tu rastreo, o quieres aplicar este proceso a tu sitio, escríbeme.
 Autor.Raffaele Visintin.Search & Strategic Marketing Advisor
