

Canonical.
Analyse de l’attribut canonical et bonnes pratiques pour éviter le contenu dupliqué.
Comment contrôler la balise canonical, indispensable sur les e-commerce où un même produit a plusieurs chemins. Lis les filtres de l’onglet Canonicals et repère les erreurs les plus courantes, comme les canonicals vers des pages non indexables.
Tutoriel d’analyse des canonicals
L’élément canonical (rel="canonical") est un attribut qui indique aux robots quelle est la version préférée d’un contenu présent sur plusieurs pages (avec des slugs différents), pour éviter le contenu dupliqué.
Cette balise est importante sur tous les sites mais devient indispensable sur les e-commerce. Voyons pourquoi.
Exemple :
Imagine un e-commerce qui vend des vêtements de sport des meilleures marques, où la fiche produit d’une « chaussure de running » est accessible depuis la page de la marque et depuis la catégorie « running ».
Deux scénarios :
l’internaute clique sur la chaussure depuis la page de la marque.
Fiche produit atteinte depuis la page de la marque Asics : domaine.com/asics/gel-venture-8
l’internaute clique sur le produit dans la catégorie « Running ».
Fiche produit atteinte depuis la page de catégorie Running :
domaine.com/running/gelventure-8.
Ici, la fiche produit reprend la catégorie dans son slug et le site présente le même contenu sur deux chemins différents.
La balise canonical t’aide à définir laquelle des deux le robot doit prendre en compte pour le classement.
Configurer le crawl des canonicals
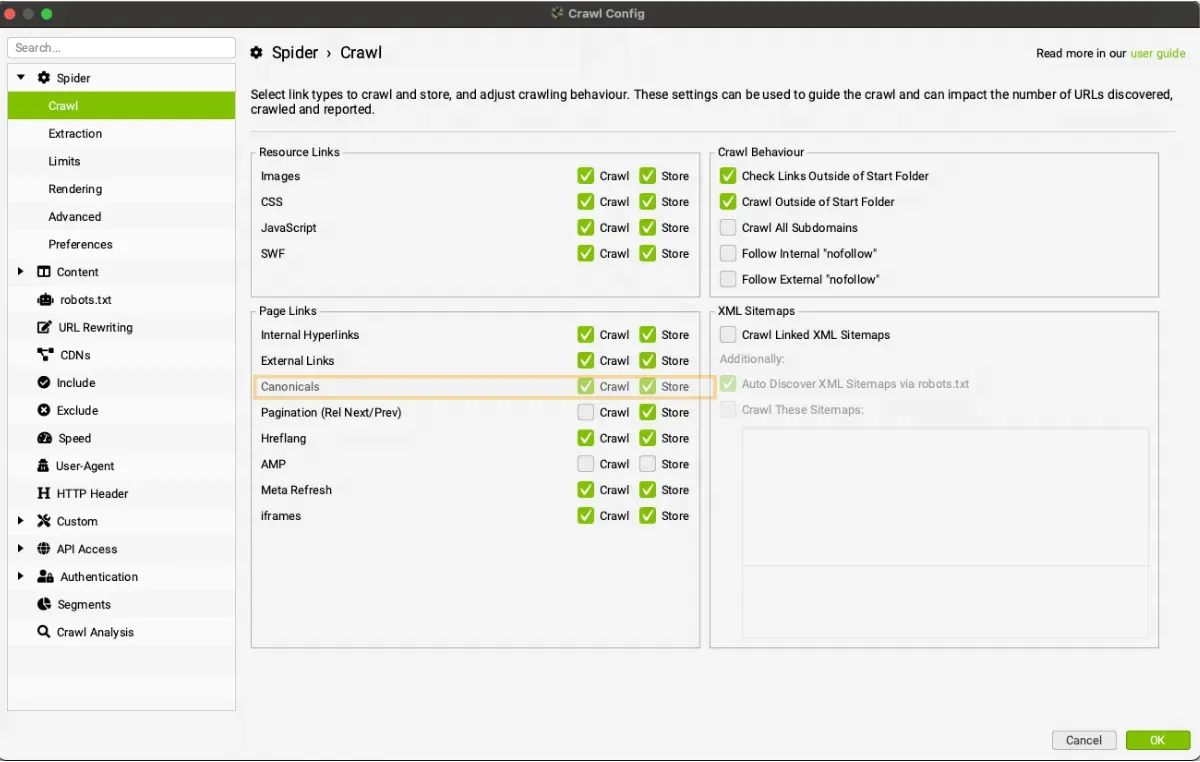
Avant le crawl, vérifie que Canonicals est activé dans Crawl et Store depuis 1Configuration›2Spider›3Crawl.
Filtres de l’onglet Canonicals
Les données se trouvent dans l’onglet 1Canonicals de la fenêtre supérieure et peuvent être filtrées selon ces critères :
- Contains Canonicals : la page a une URL canonical définie (via élément de lien, en-tête HTTP ou les deux). Ce peut être une canonical auto-référente, où l’URL de la page est identique à l’URL canonical, ou une page « canonicalisée », où l’URL canonical est différente de l’URL de la page.
- Self Referencing : le lien canonical pointe vers l’URL même de la page, qui est ainsi désignée comme version principale de ce contenu (voir l’exemple de la chaussure ci-dessus) ; tout autre chemin d’URL avec le même contenu devrait donc être « Canonicalised ».
- Canonicalised : la page a une URL canonical différente d’elle-même. L’URL est « canonicalisée » vers un autre emplacement : les moteurs sont invités à ne pas indexer la page et le classement est consolidé sur la version canonique.
- Missing : aucune URL canonical, ni en élément de lien, ni via en-tête HTTP. Si une page n’indique pas d’URL canonical, Google choisit ce qu’il juge être la meilleure version ou URL. Le classement peut devenir imprévisible : en règle générale, toutes les URL devraient indiquer une version canonique (self-referencing).
- Multiple : plusieurs canonicals sont définies pour une même URL (plusieurs éléments de lien, en-têtes HTTP, ou les deux). Cela peut être imprévisible : chaque page ne devrait avoir qu’une URL canonical, définie par une seule implémentation (élément de lien ou en-tête HTTP).
- Multiple Conflicting : la page a plusieurs canonicals qui pointent vers des URL différentes, par exemple une dans le HTML et une dans l’en-tête HTTP. Google peut toutes les ignorer.
- Non-Indexable Canonical : l’URL canonical pointe vers une page non indexable. Cela inclut les canonicals bloquées par le robots.txt, sans réponse, redirigées (3XX), en erreur client (4XX), en erreur serveur (5XX) ou en « noindex ».
- Canonical Is Relative : l’URL canonical est relative et non absolue. Ça fonctionne, mais une erreur de chemin peut pointer vers la mauvaise page : mieux vaut utiliser des URL absolues.
- Unlinked : l’URL canonical ne reçoit aucun lien interne (filtre rempli par la Crawl Analysis).
- Outside <head> : le lien canonical est hors du head, par exemple dans le body, et les moteurs l’ignorent.
Les versions canoniques des URL doivent toujours être des pages indexables répondant « 200 ». Les canonicals qui pointent vers des pages non indexables doivent donc être corrigées vers les versions indexables.
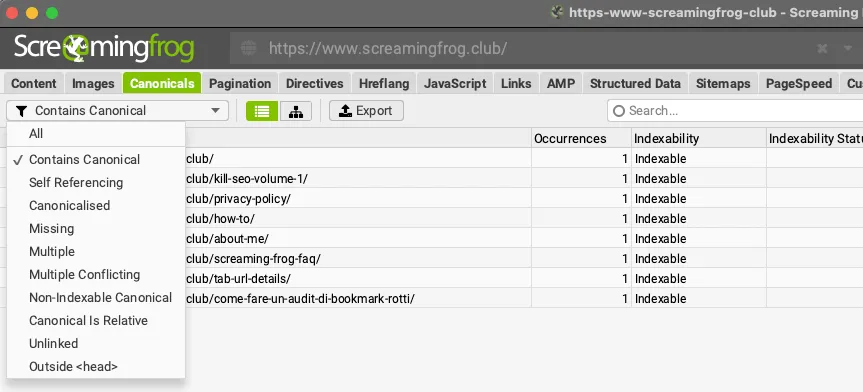
La colonne « Occurrences » compte le nombre d’éléments rel="canonical" trouvés pour chaque URL.
Barre latérale
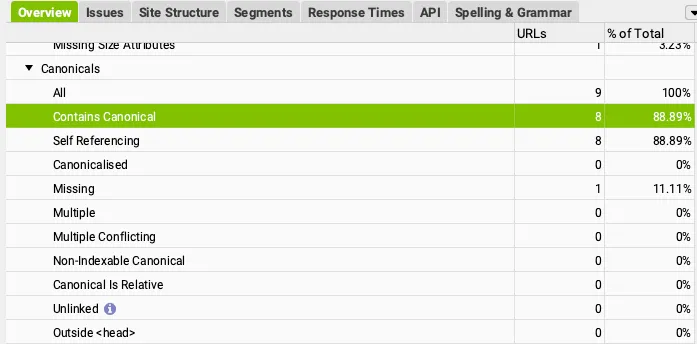
Depuis la barre latérale, tu vérifies en temps réel toutes les URL qui présentent des problèmes de canonical. Dans l’image ci-dessous, on voit 8 URL avec une canonical auto-référente (Self Referencing) et 1 URL sans canonical (Missing).
Onglets associés : Canonicals | Barre latérale | Rapports
Tutoriels vidéo
Analyse de la balise canonical
Erreurs courantes sur la balise canonical
Des questions sur Canonical?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
