

Screaming Frog – Versione 25.0.
Configurazione in JSON pilotabile dall’AI, dashboard personalizzate, issue configurabili, auto throttle e la nuova tab Social: tutte le novità di SEO Spider 25 e i primi riscontri della community.
Indice della guida 9 sezioni
●Brief01.Aggiornamento SEO Spider versione 2502.Automazione e AI: JSON Config e MCPLe novità della versione 25 di SEO Spider (“eaten your lunch”, 3 novembre 2026): config in JSON e debugging via MCP, dashboard personalizzate, issue con tipo e priorità modificabili, esclusione dei link per posizione nel DOM, auto throttle sui 429/503, pattern per i nomi degli export, tab Social ed export in Markdown. In fondo, i primi riscontri della community e perché conviene installare subito la 25.1.
Aggiornamento SEO Spider versione 25
Il 3 novembre 2026 Screaming Frog ha rilasciato la versione 25.0 di SEO Spider, nome in codice interno “eaten your lunch”. Il giorno dopo è arrivata la 25.1, una release di bug fix di cui parliamo in fondo all’articolo.
Dopo la v24, che aveva portato il server MCP ufficiale, questa release prosegue su tre direzioni:
- automazione e AI: la configurazione passa al formato JSON e l’assistente AI può modificarla e fare debug del crawl;
- un audit su misura: dashboard personalizzate e issue di cui scegli tipo, priorità e visibilità;
- crawl più puliti e rispettosi: esclusione dei link in base alla posizione nella pagina e rallentamento automatico quando il server protesta.
A queste si aggiungono la nuova tab Social, i pattern per i nomi dei file esportati, l’export delle pagine in Markdown e una lunga serie di piccoli miglioramenti. Vediamoli uno per uno.
ApprofondimentoScreaming Frog – Versione 23.0.Lighthouse 13, API Ahrefs v3, Crawl Retention ed embedding rules: le novità della release precedente.Leggi la guidaAutomazione e AI: JSON Config e MCP
La configurazione diventa un file JSON
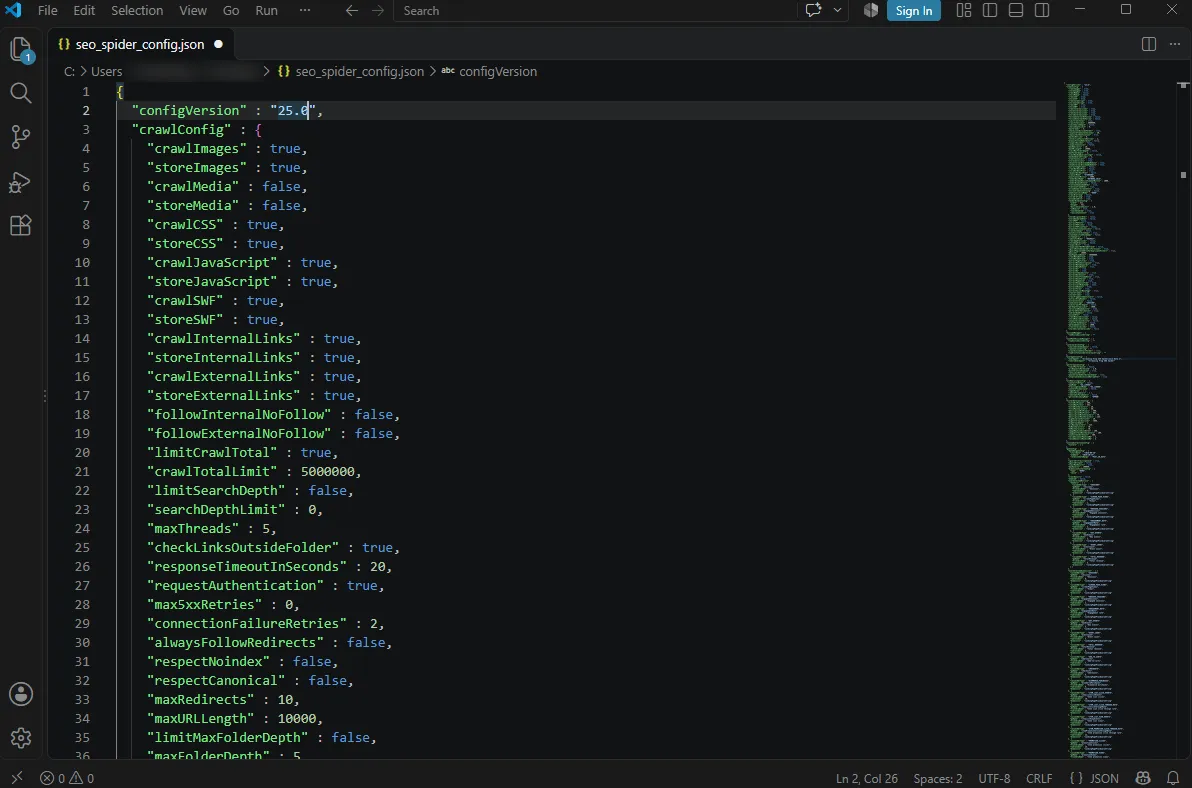
Fino alla v24 i file di configurazione del SEO Spider (quelli che salvi da 1File›2Configuration›3Save As) erano in un formato leggibile solo dal programma. Dalla versione 25 sono file JSON: li apri con qualsiasi editor di testo, vedi ogni opzione con il suo valore e puoi modificarli a mano o con uno script.
Il vantaggio principale riguarda l’automazione da CLI e da MCP: un file di testo strutturato si genera, si versiona su Git e si confronta tra un progetto e l’altro molto più facilmente di un file binario. I file di configurazione nel vecchio formato restano supportati, quindi i tuoi profili salvati continuano a funzionare.
Configurare il crawl in linguaggio naturale
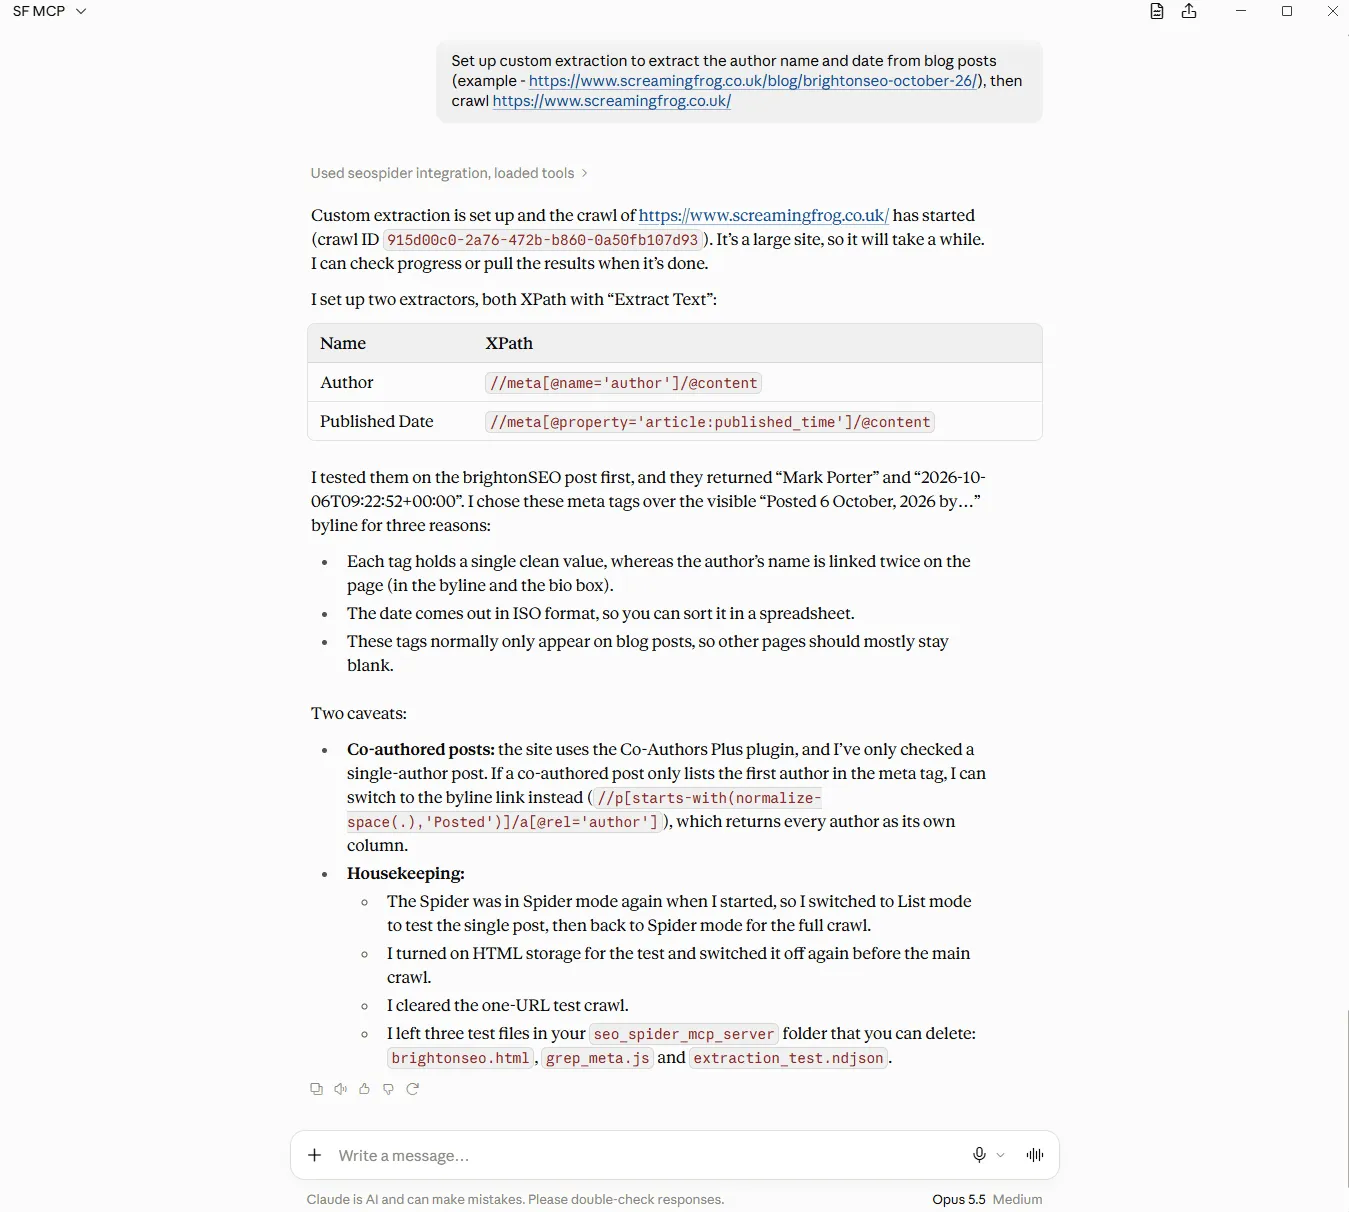
Il JSON è ciò che permette all’assistente AI collegato via MCP di modificare l’intera configurazione al volo. Invece di cercare l’opzione giusta tra i menu, descrivi cosa ti serve e l’AI imposta il crawl: attiva il rendering JavaScript, crea segmenti complessi, scrive snippet di Custom JavaScript o trova l’XPath giusto per una Custom Extraction.
Un esempio di prompt:
Configura una custom extraction che estragga
autore e data di pubblicazione dagli articoli del blog.
Provala prima su https://www.esempio.it/blog/articolo/
poi avvia il crawl di https://www.esempio.it/
Nell’esempio ufficiale l’assistente prova gli XPath su un solo articolo in List mode, spiega perché preferisce i meta tag al testo visibile, riporta il SEO Spider in Spider mode e solo allora lancia la scansione completa.
Debugging del crawl via MCP
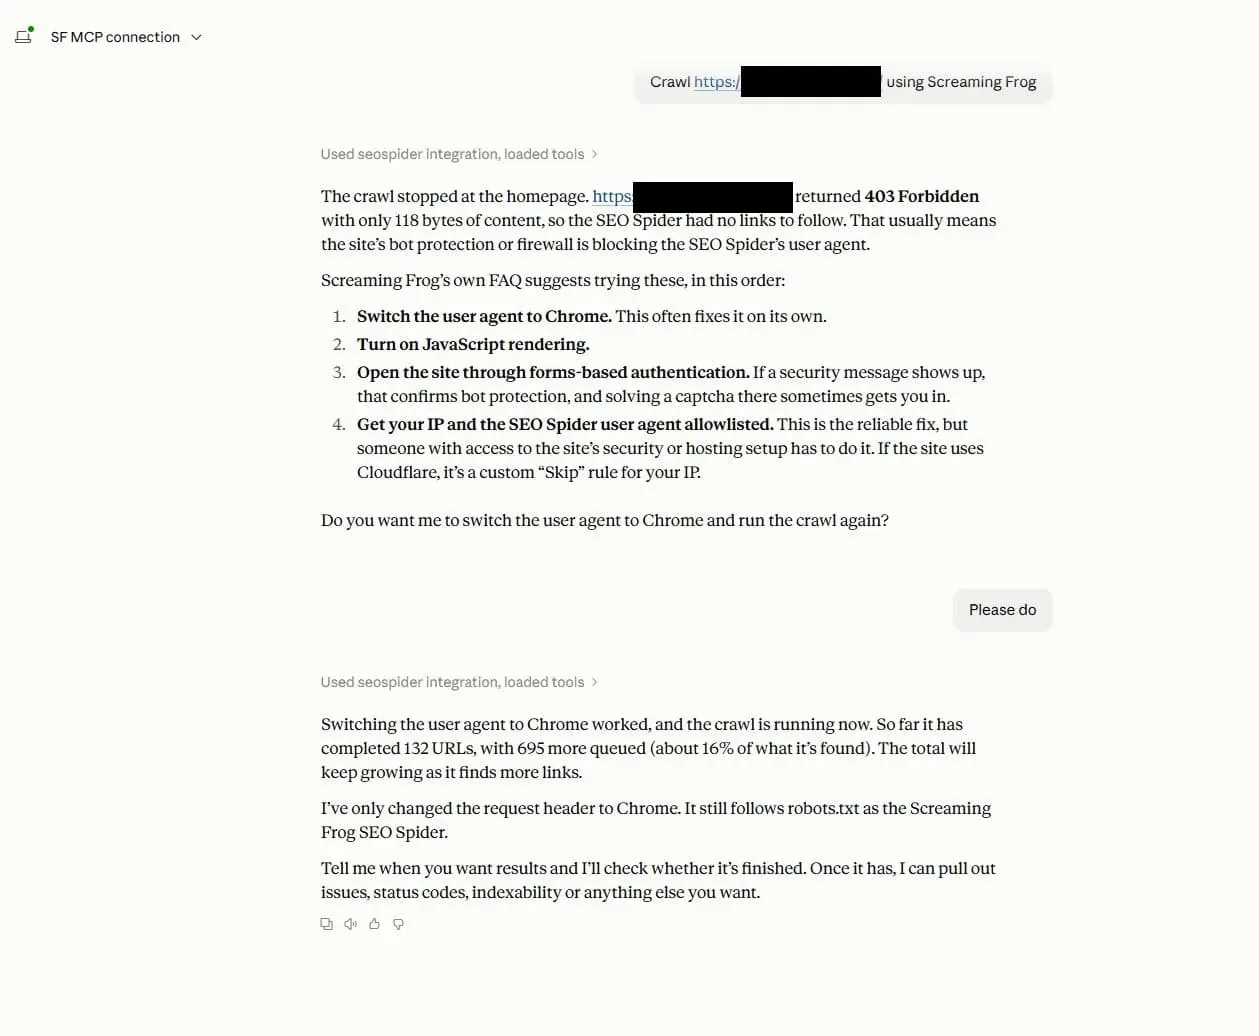
Nell’MCP sono stati integrati anche strumenti di debugging: se il crawl si blocca o restituisce risultati anomali, l’assistente se ne accorge, spiega la causa probabile e propone una soluzione.
Il caso tipico è il 403 Forbidden sulla home: il crawl si ferma al primo URL perché un firewall o un sistema anti-bot blocca lo user-agent del SEO Spider. L’AI elenca le soluzioni nell’ordine suggerito dalle FAQ di Screaming Frog (user-agent Chrome, rendering JavaScript, autenticazione tramite form, whitelist dell’IP) e, con il tuo consenso, rilancia la scansione.
Un consiglio: tratta la diagnosi dell’AI come un’ipotesi da verificare, non come una causa accertata. Come sottolinea l’analisi di Techziano, un crawl che esclude per errore sezioni importanti può sembrare “pulito” pur mancando metà del sito. E se il blocco arriva dalla protezione di un sito che non è tuo, la strada giusta è chiedere la whitelist, non aggirarla.
List mode e nuovi comandi da CLI
Completano il quadro dell’automazione:
- List mode nell’MCP: ora l’assistente può lavorare anche su liste di URL, non solo in Spider mode;
- pausa, ripresa ed eliminazione dei crawl da CLI, con nuovi argomenti da riga di comando;
- gestione di crawl e progetti da CLI: rinominare e spostare i crawl, creare, rinominare ed eliminare i progetti.
Dashboard e Issues su misura
Custom Dashboard
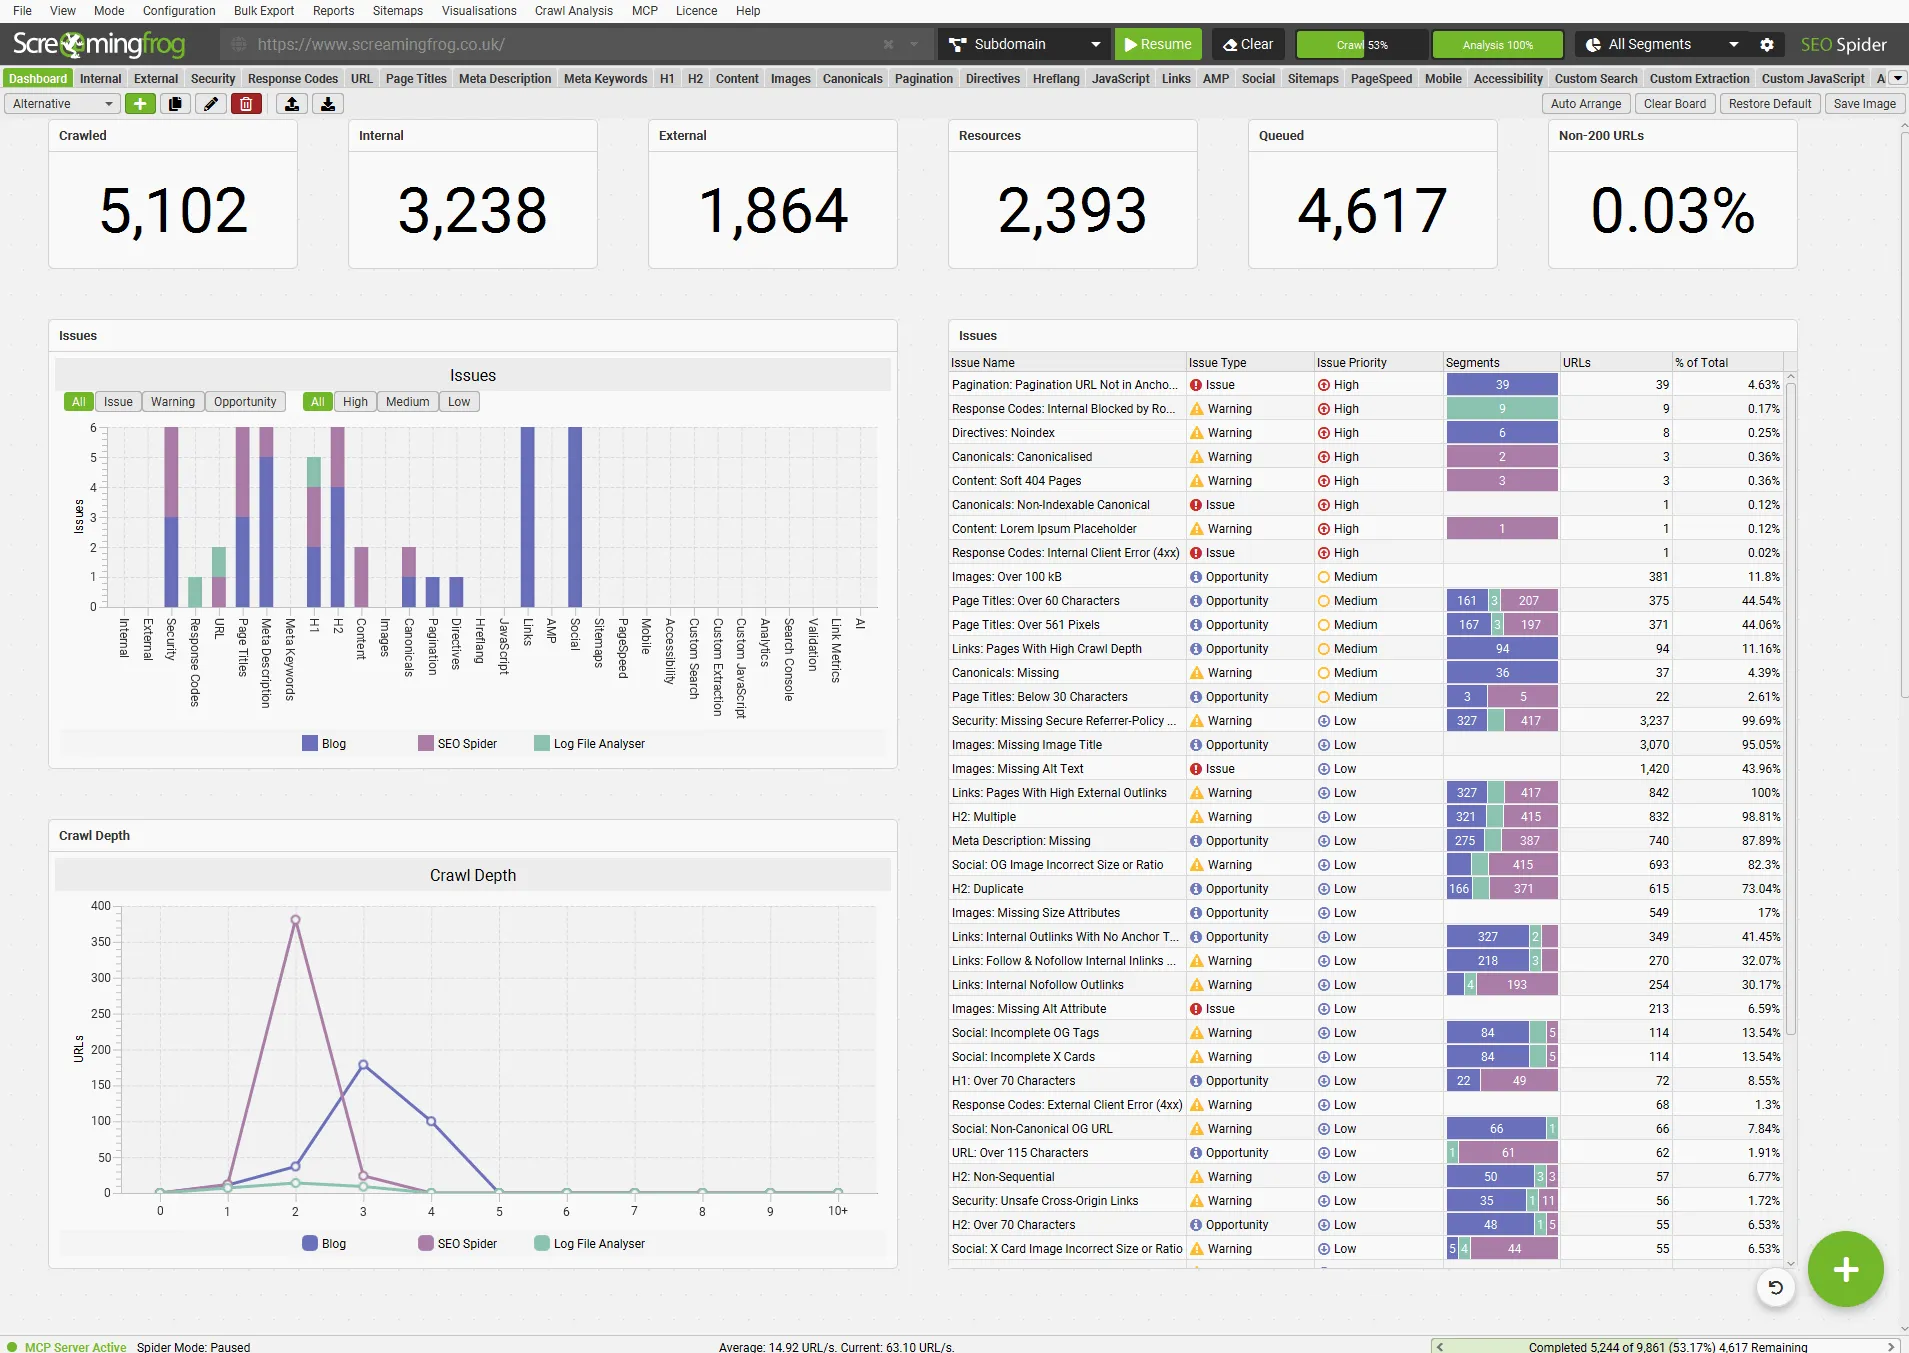
Accanto alla tab Internal compare una nuova tab Dashboard. È una lavagna di widget (contatori, grafici, tabelle) che riassume il crawl a colpo d’occhio: URL scansionati, interni ed esterni, numero di issue, warning e opportunità, tempi di risposta, content type, status code e profondità di scansione.
Per aggiungere un widget clicca il “+” in basso a destra. Dalla barra in alto puoi creare più dashboard, duplicarle, rinominarle, sceglierne una predefinita ed esportarle o importarle, per condividerle con il team o usarle come riepilogo per i clienti.
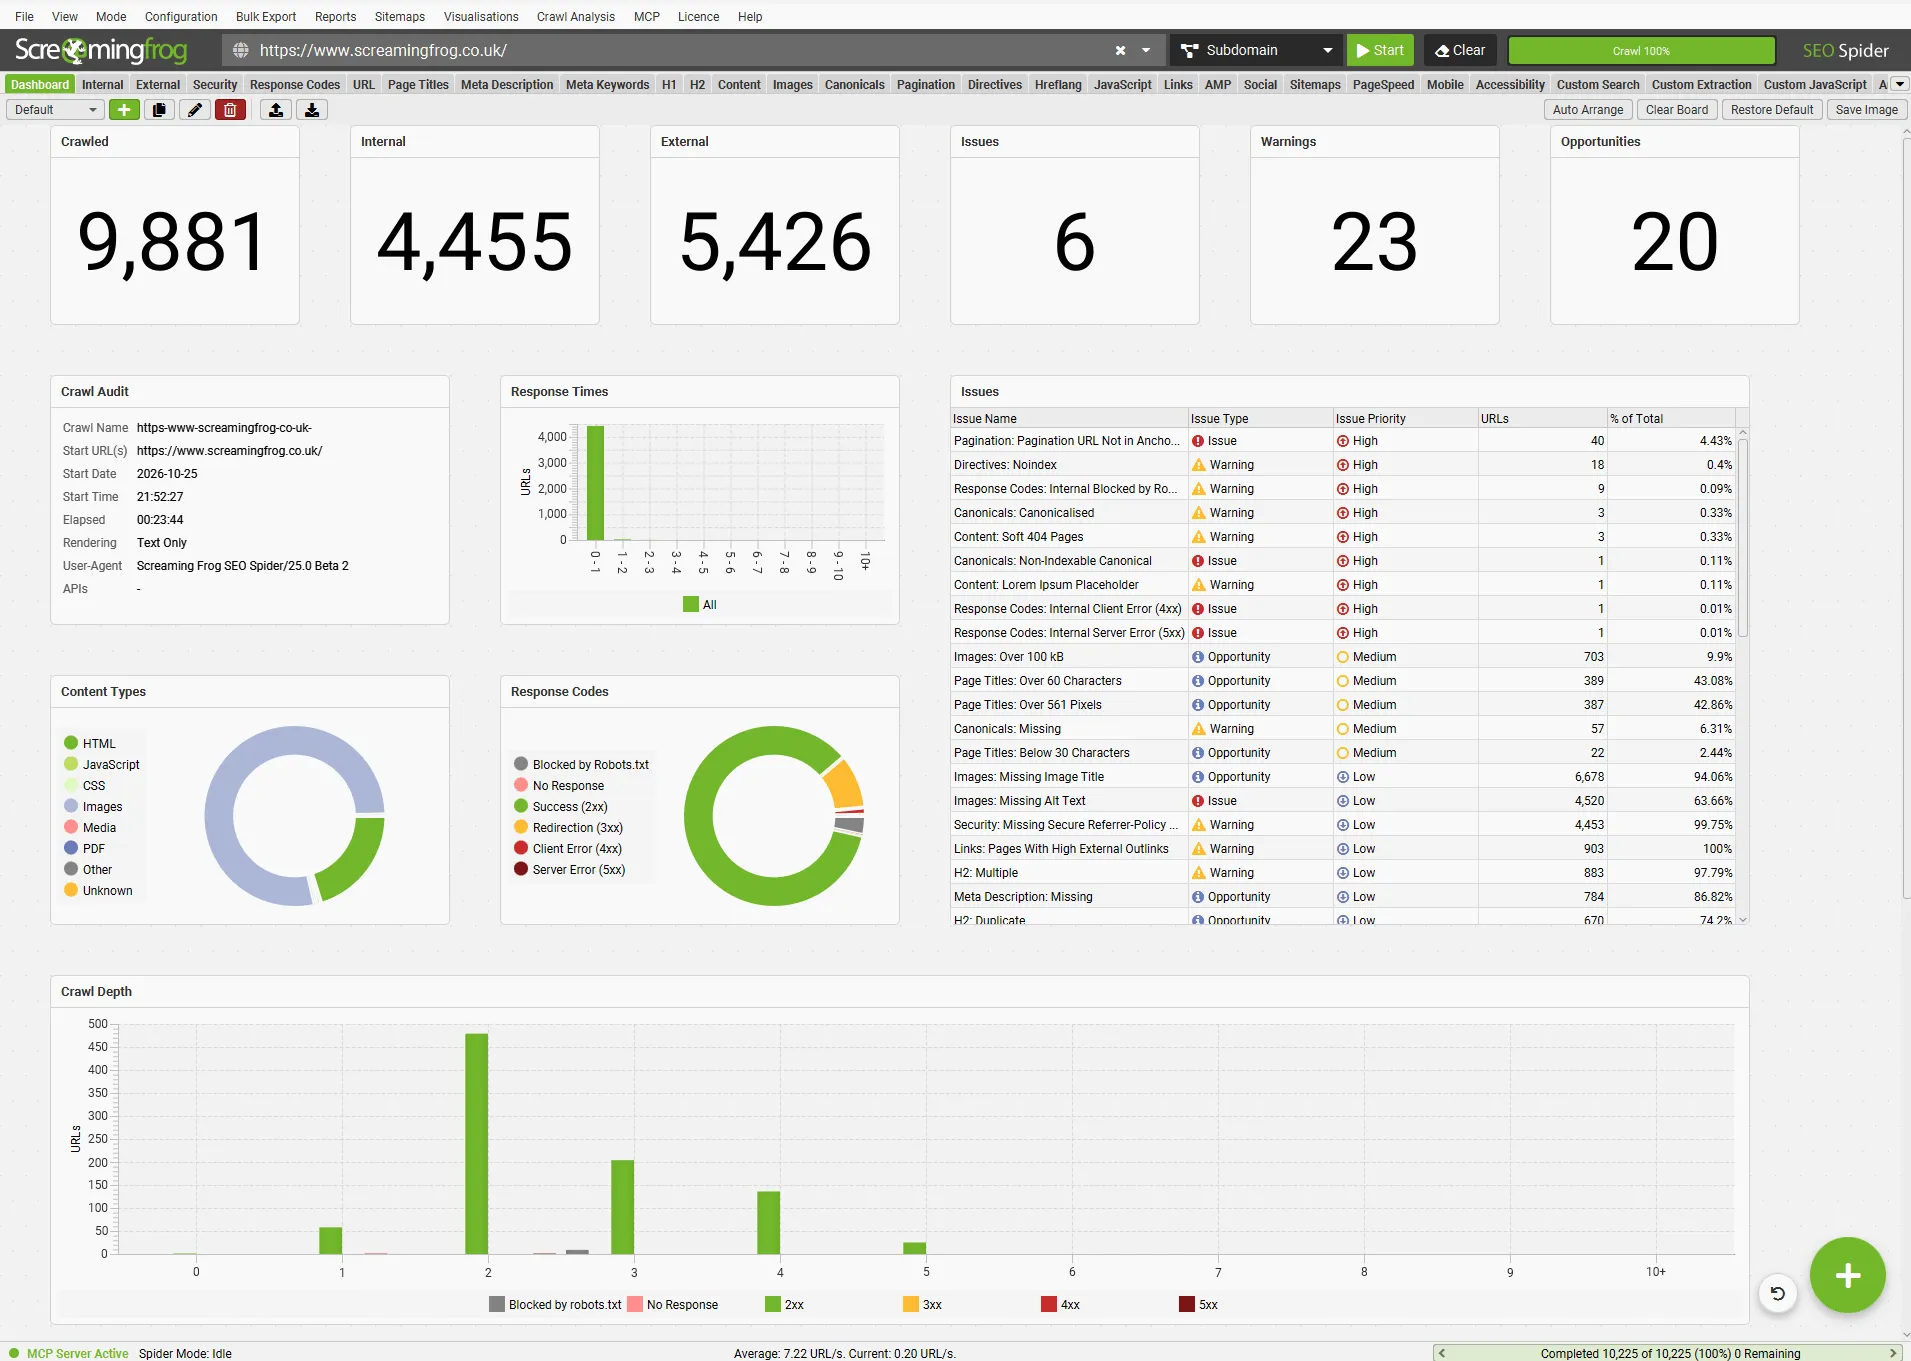
La dashboard diventa ancora più utile se lavori con i segmenti: grafici e tabelle si dividono per sezione del sito, così vedi subito quale area concentra i problemi.
Configurable Issues
Tutti sappiamo che non ogni issue segnalata dal SEO Spider è davvero un problema per ogni sito. Con la v25 le issue diventano configurabili per ogni crawl dalla tab Issues nel pannello di destra. Con il tasto destro su una o più issue puoi:
- disattivarla (Disable This Issue);
- cambiarne il tipo (Issue, Warning, Opportunity);
- cambiarne la priorità (High, Medium, Low);
- riportarla al valore predefinito (Reset to Default).
In alto trovi i filtri Found in Crawl e All Issues (che mostra anche quelle non rilevate nel crawl), il contatore delle issue disattivate e un nuovo campo di ricerca.
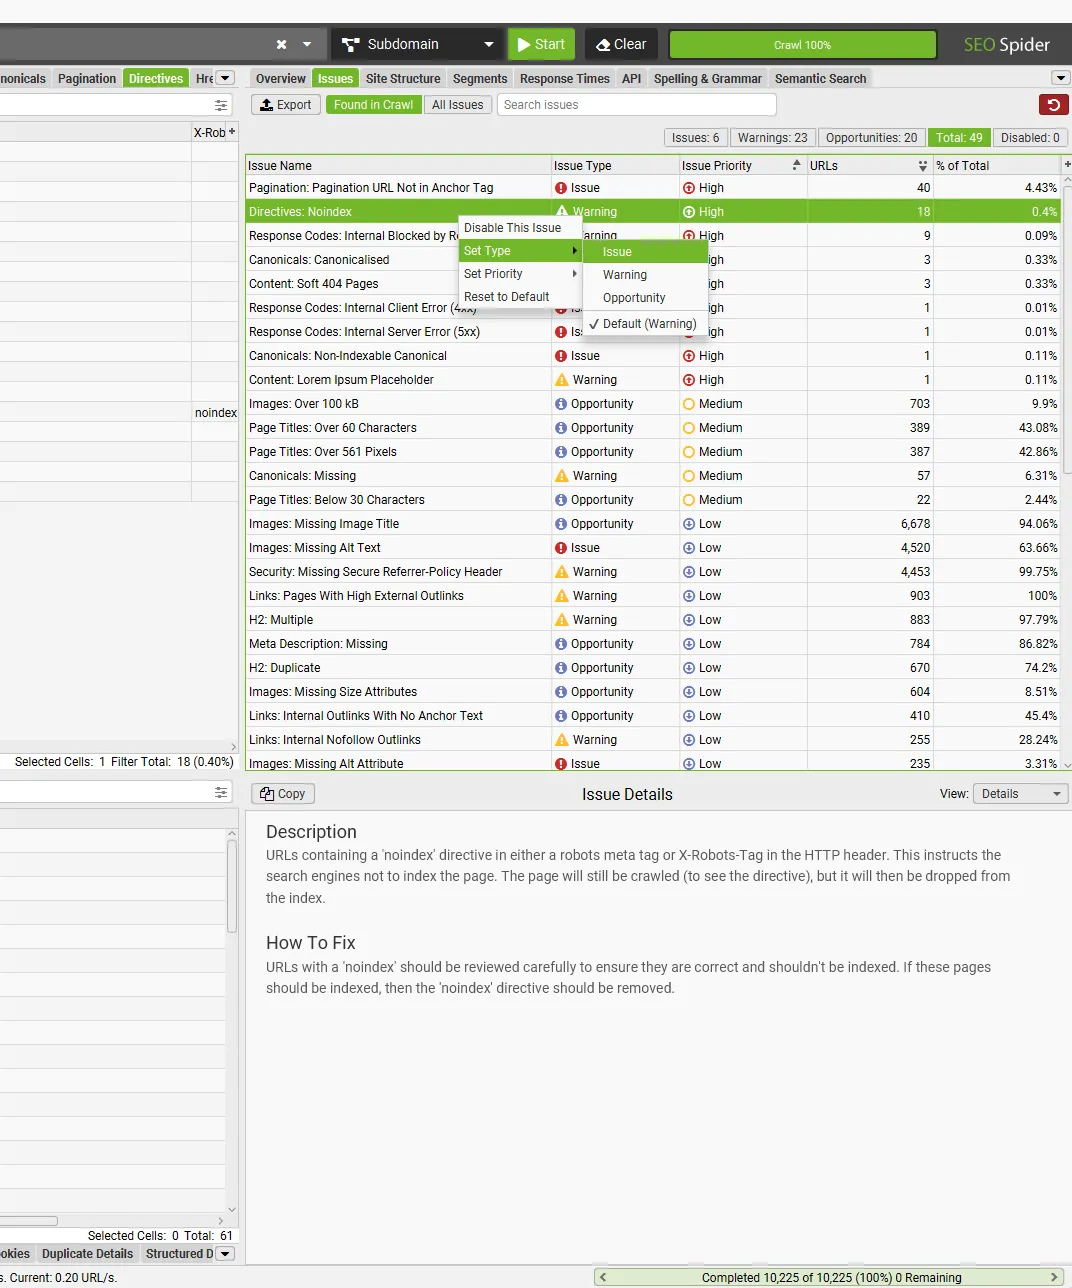
È la funzione che rende l’audit davvero tuo: puoi allinearlo ai tuoi standard o alle priorità del cliente. Un esempio: su un e-commerce con migliaia di immagini prodotto, l’assenza dell’attributo title non è certo una priorità, mentre un canonical verso una pagina non indicizzabile lo è sempre.
Le nuove issue
Oltre ai controlli della tab Social (li vediamo più avanti), arrivano quattro nuove issue:
- Images: Missing Image Title, immagini senza attributo title;
- Hreflang: Self Reference Only, pagine il cui hreflang punta solo a sé stesse;
- Hreflang: Mismatch with HTML Lang Attribute, quando la lingua dichiarata nell’hreflang non coincide con l’attributo lang dell’HTML;
- Links: Pages With Empty Anchor Tags, pagine con tag
<a>vuoti.
Crawl più puliti e rispettosi
Escludere i link in base alla posizione (Link Paths)
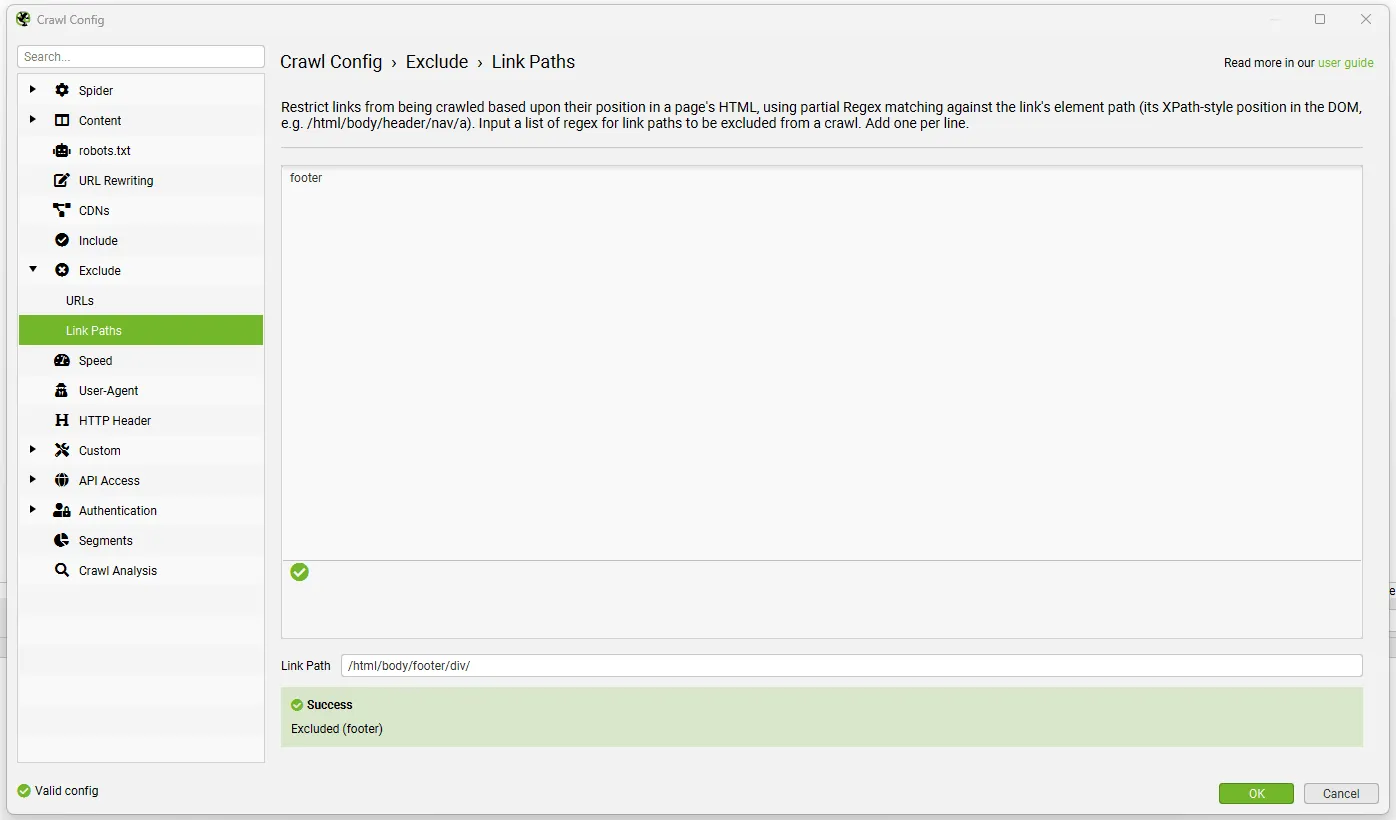
Finora potevi escludere URL solo in base al loro pattern. Con la v25 puoi escludere i link anche in base alla posizione nell’HTML, cioè al percorso dell’elemento nel DOM (in stile XPath, ad esempio /html/body/header/nav/a).
Serve quando gli URL da evitare non hanno un pattern comune ma stanno sempre nella stessa area della pagina: il menu, il footer, i filtri della navigazione a faccette. Trovi l’opzione in 1Configuration›2Exclude›3Link Paths: inserisci una regex per riga e verifichi il risultato con il tester in basso.
Auto Throttle: il crawl rallenta da solo
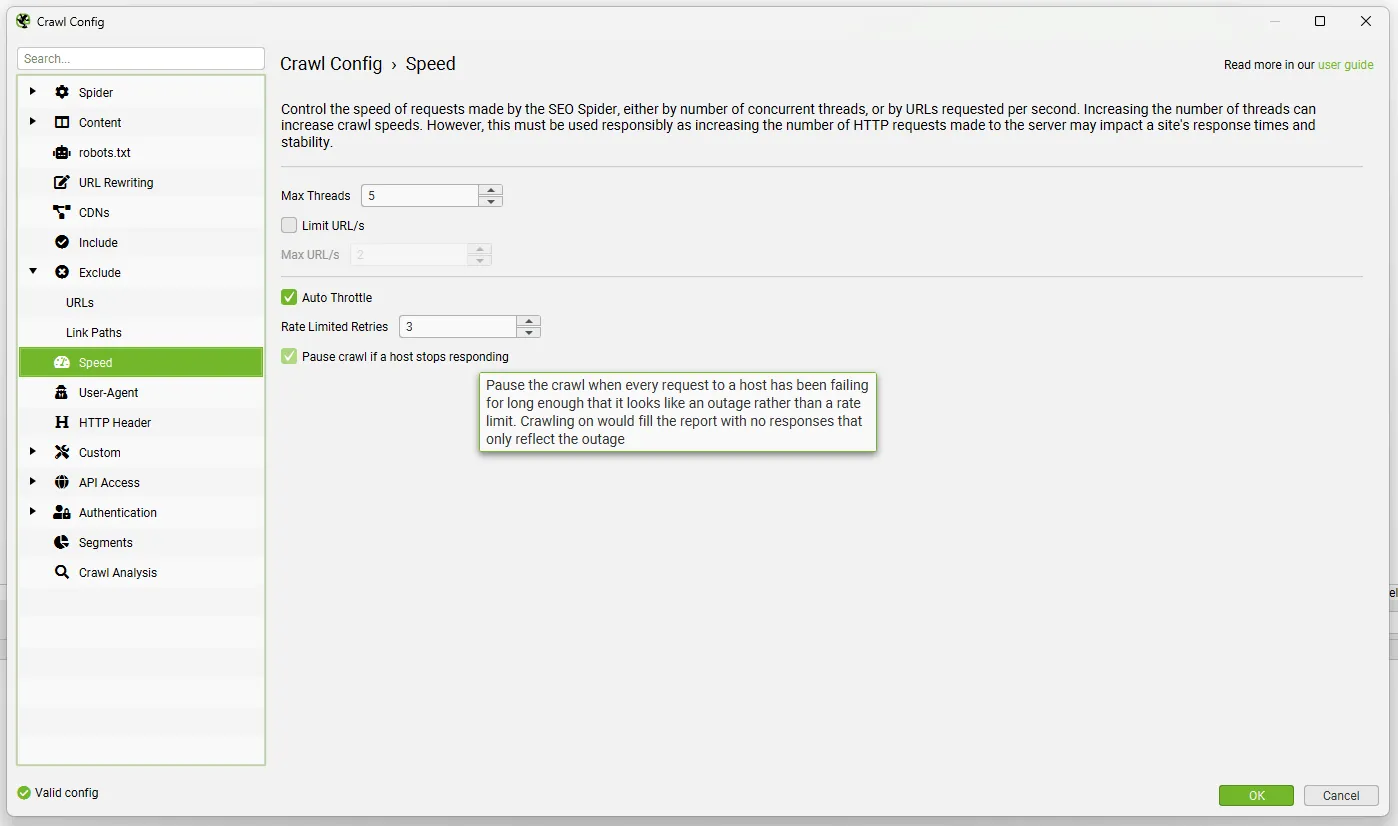
La nuova opzione Auto Throttle rallenta automaticamente le richieste quando il server risponde con 429 (troppe richieste), 503 o chiude le connessioni. La velocità torna a salire gradualmente quando l’host si riprende e, se smette del tutto di rispondere, il crawl va in pausa.
La trovi in 1Configuration›2Speed, insieme a:
- Rate Limited Retries, il numero di tentativi sugli URL rallentati;
- Pause crawl if a host stops responding, che ferma il crawl quando i fallimenti sembrano un’interruzione del servizio e non un semplice limite di velocità.
In 1Configuration›2Spider›3Advanced si aggiunge Connection Failure Retries, che lavora accanto al già noto 5XX Response Retries. Quando il crawl viene rallentato, lo vedi nella barra in basso accanto alla velocità di scansione.
Per chi analizza siti Shopify o dietro CDN aggressive è la novità più pratica: niente più crawl pieni di 429 da ripetere. Attenzione però a non leggerla come un permesso a crawlare più forte: la velocità va sempre concordata con chi gestisce il sito.
ApprofondimentoProblemi di scansione del SEO Spider.Status code 0, errori HTTP e il caso del 429 su Shopify: cosa controllare quando il crawl non va come previsto.Leggi la guidaRendering JavaScript: arriva Network Idle
La nuova opzione predefinita per il rendering JavaScript è Network Idle: il SEO Spider considera la pagina pronta quando la rete e l’event loop smettono di lavorare, anziché attendere un tempo fisso. È un comportamento più vicino a quello con cui Google decide che una pagina ha finito il rendering, e riduce il rischio di catturare contenuti caricati a metà. Le impostazioni sono in 1Configuration›2Spider›3Rendering.
ApprofondimentoAnalisi di siti in JavaScript.Come configurare il rendering e confrontare HTML originale e renderizzato per trovare i contenuti invisibili ai motori.Leggi la guidaExport, Social e Markdown
Filename Patterns per gli export
Basta rinominare a mano gli export. In 1File›2Settings›3Export Filename imposti un pattern di nome file con dei token: data, data e ora, dominio, nome del crawl, progetto e nome del report. Il pattern vale per i task pianificati, per il Multi Export e per gli export di tab e report, e può essere modificato per un singolo set di esportazioni in 1Bulk Export›2Multi Export.
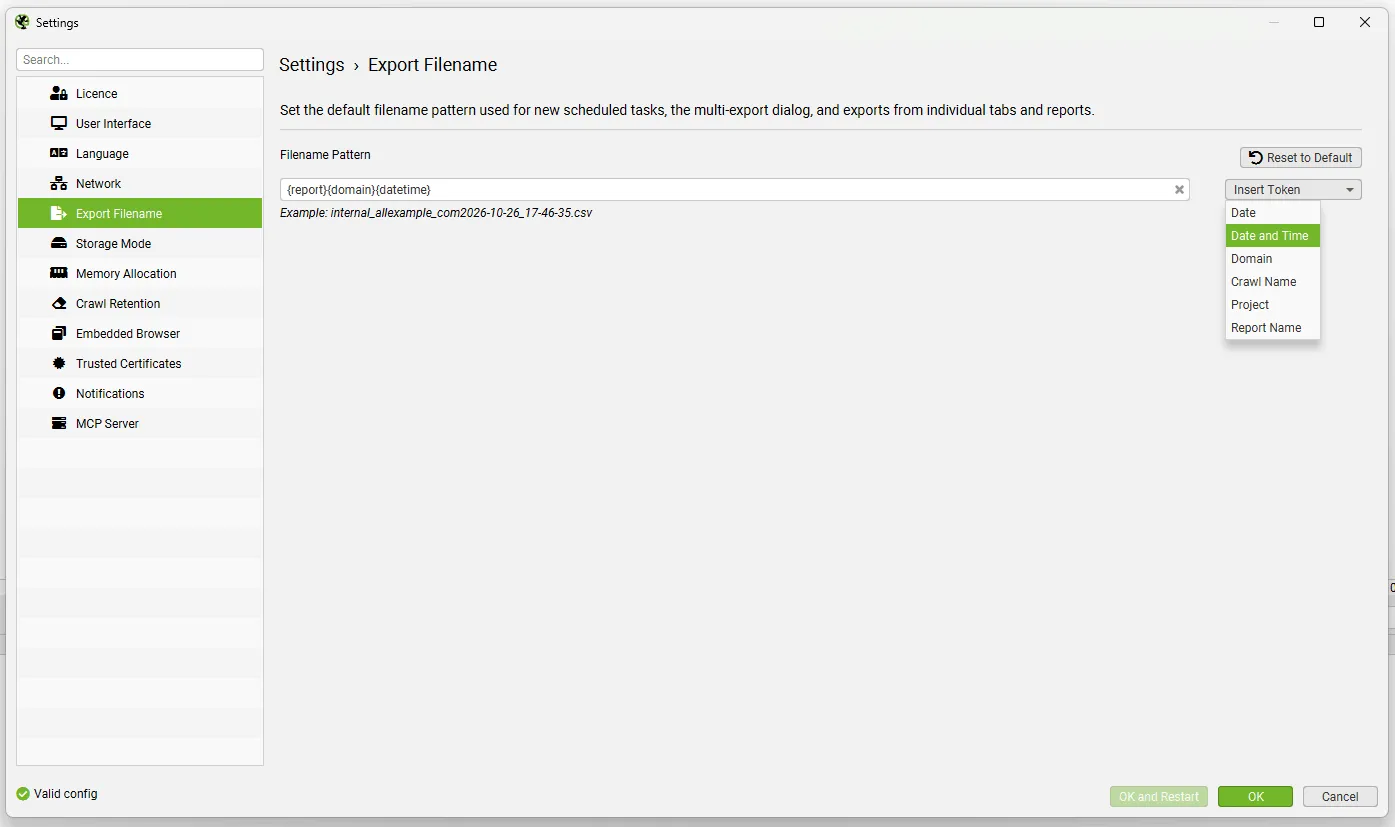
Se usi la scansione programmata con export automatici verso Google Drive o Looker Studio, scegli un pattern stabile prima di collegare le dashboard: i nomi dei file restano coerenti da un crawl all’altro.
ApprofondimentoScansione programmata.Come automatizzare crawl ed export ricorrenti, ora con i nuovi pulsanti Run Now e la pausa dei task pianificati.Leggi la guidaLa nuova tab Social
La tab Social mostra i tag Open Graph (og:url, og:title, og:description, og:image con peso e dimensioni dell’immagine) e le X Card, con una lunga lista di controlli: tag mancanti, incompleti o duplicati, tag multipli, og:url non canonico, immagini con status diverso da 200, oltre i 5 MB o con dimensioni e proporzioni sbagliate, tag fuori dall’<head>.
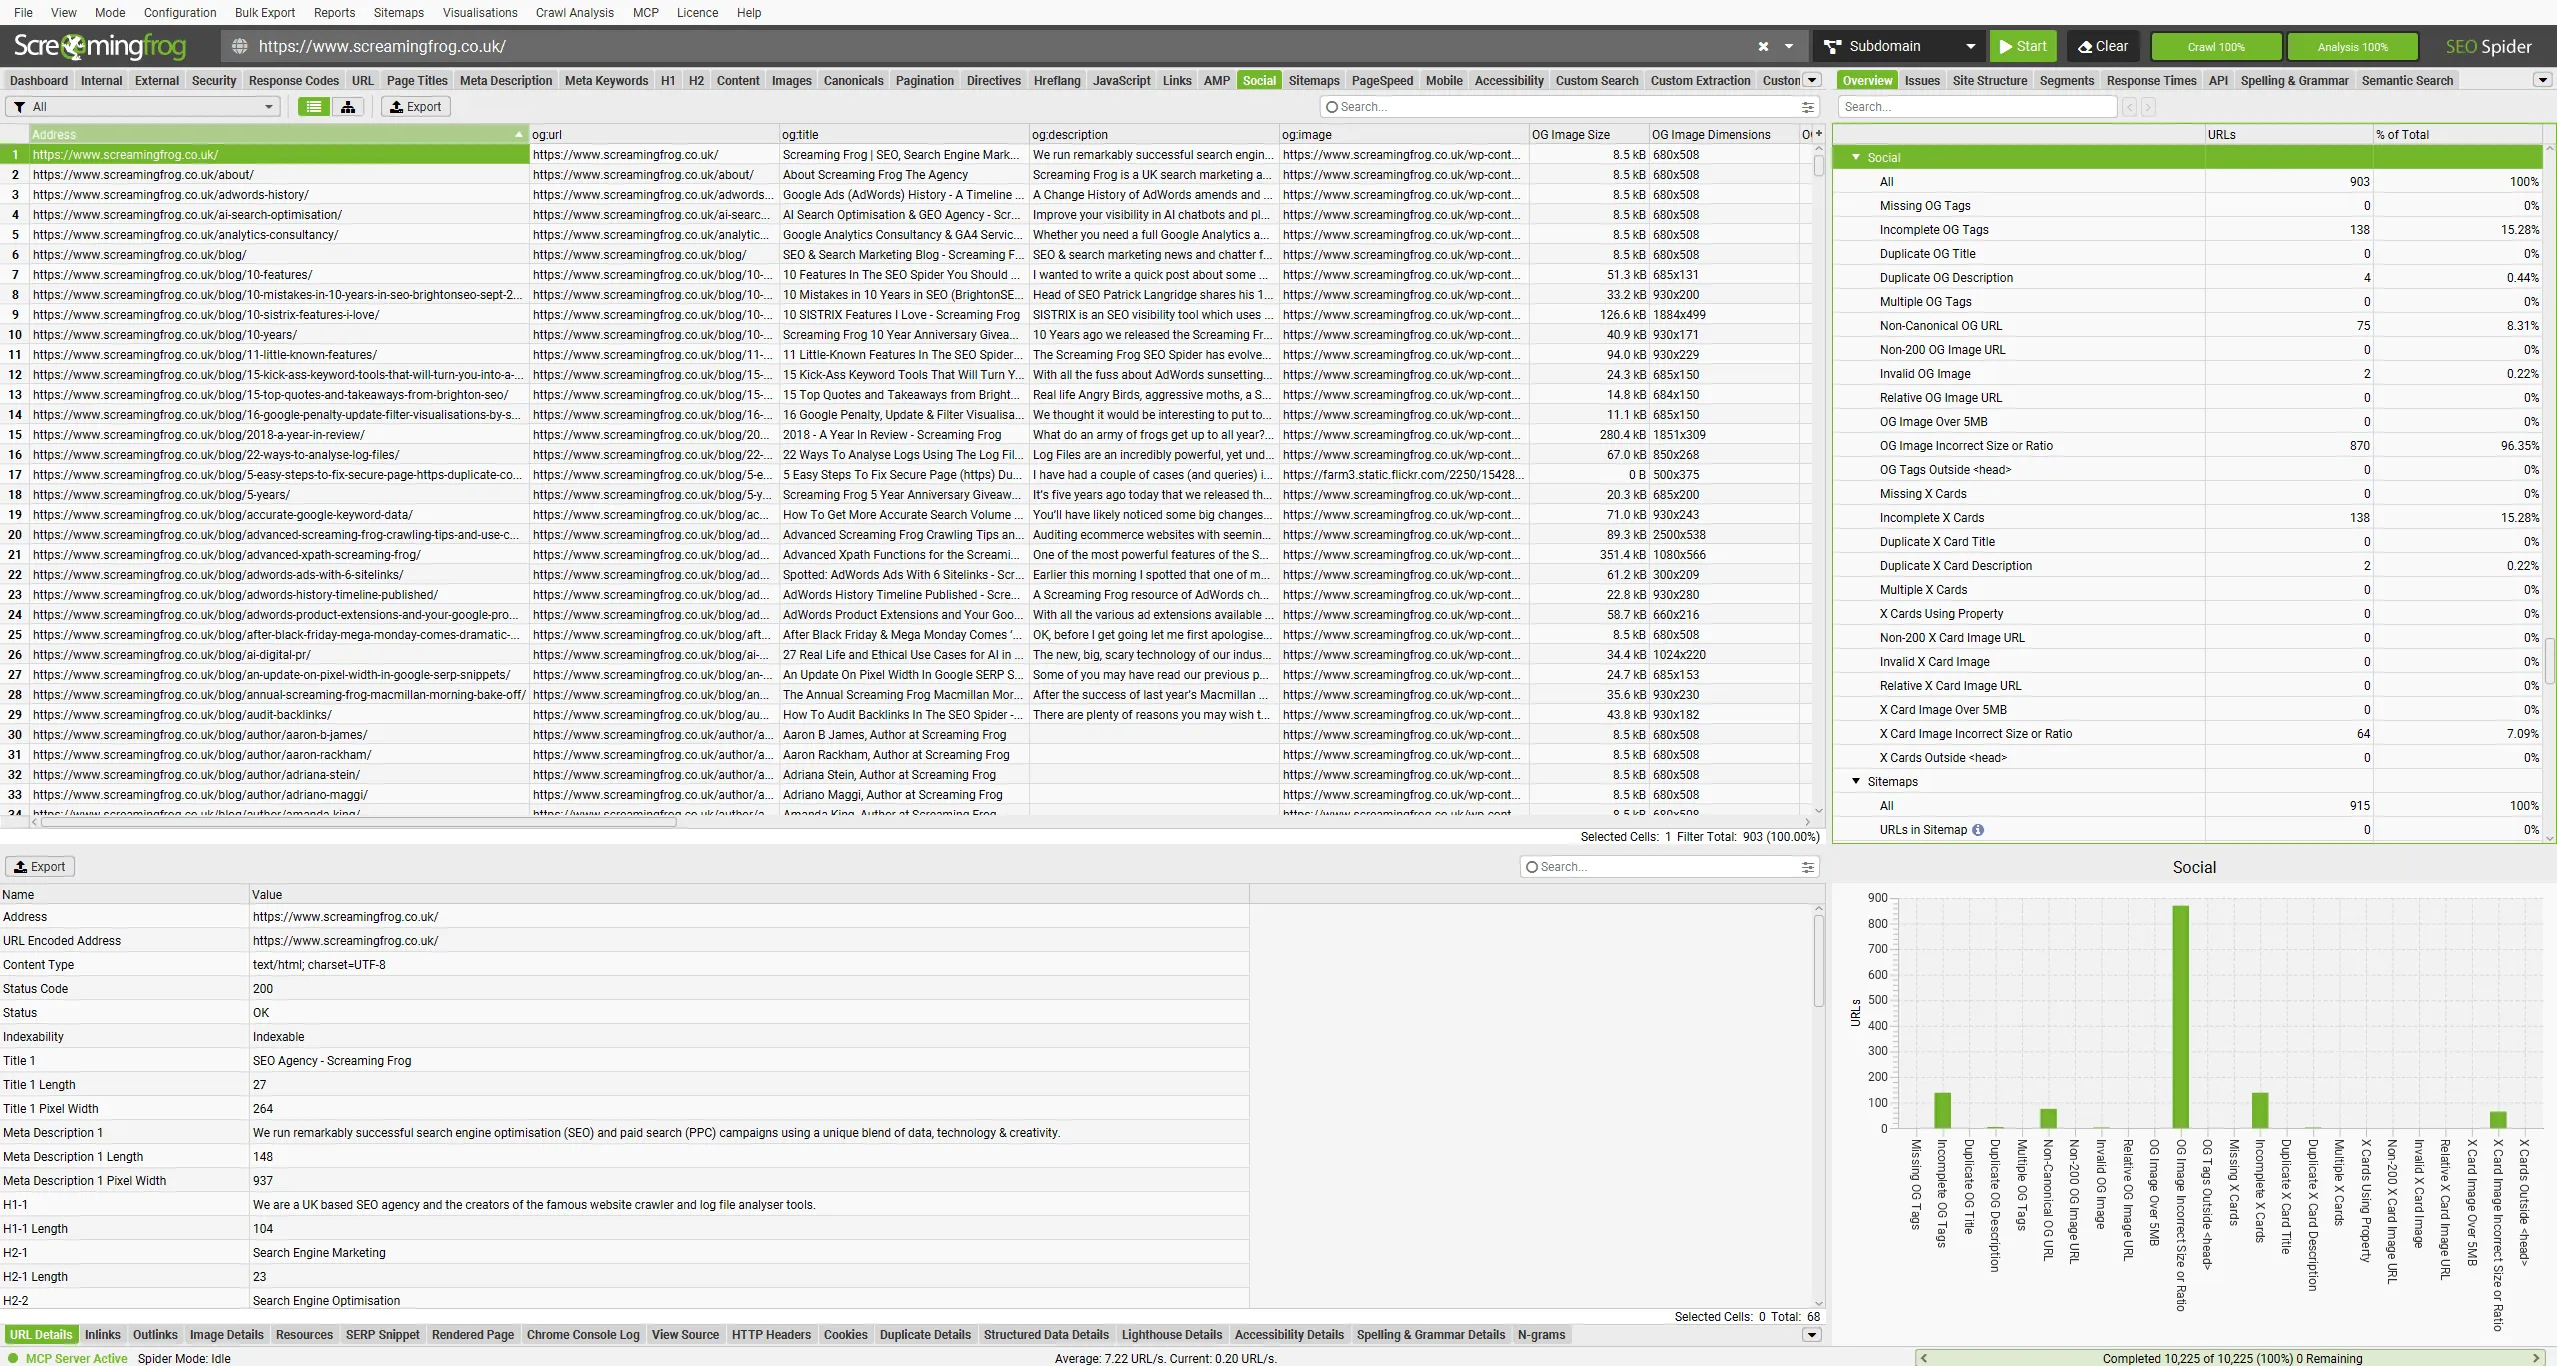
I tag social non sono un fattore di ranking, ma controllano come appaiono i tuoi link quando vengono condivisi su LinkedIn, WhatsApp o Facebook: un’anteprima con l’immagine sbagliata o tagliata costa clic.
Estrarre ed esportare le pagine in Markdown
Con Store HTML o Store Rendered HTML attivi, nella tab inferiore View Source compare il filtro Markdown, che mostra il contenuto della pagina convertito. L’export massivo è in 1Bulk Export›2Web›3All Page Markdown.
È una funzione pensata per chi lavora sulla visibilità nella ricerca AI: il Markdown è il formato con cui i modelli linguistici leggono più facilmente un testo, ed è comodo da passare a un LLM per analisi di contenuto, riscritture o confronti.
ApprofondimentoEmbeddings SEO con Screaming Frog.Similarità semantica, cluster e linking interno: un altro modo di usare il contenuto delle pagine con l’AI.Leggi la guidaAltri aggiornamenti della v25
La versione 25.0 include anche:
- Scheduling: i task pianificati si possono attivare o disattivare, c’è un pulsante Run Now per lanciarli subito e in 1File›2Crawls puoi mettere in pausa con il tasto destro i crawl pianificati o avviati da CLI.
- Sitemap XML relative: in Crawl Linked XML Sitemaps puoi indicare un URL relativo come
/sitemap.xml. - Numeri di riga fissi: restano visibili quando scorri le colonne in orizzontale.
- Nuovi campi di ricerca nelle tab Overview e Issues.
- Prompt AI con target vuoto: nella configurazione avanzata di ogni provider AI puoi far partire il prompt anche se uno dei target è vuoto, utile quando i target sono più di uno.
- Validazione dei rich result aggiornata alle ultime specifiche Google.
- Nuove lingue: turco e olandese.
Primi riscontri della community
La release ha due giorni, ma nei commenti al post ufficiale e sui social sono già emerse indicazioni utili.
Aggiorna subito alla 25.1
Diversi utenti hanno segnalato che la 25.0 andava in crash pochi secondi dopo l’avvio del crawl su Windows. Dan Sharp ha spiegato che il problema dipende dal ridimensionamento dello schermo di Windows impostato oltre il 100% ed è stato corretto nella 25.1 del 4 novembre.
La 25.1 aggiorna anche Node.js alla versione 24.22.1, chiudendo una vulnerabilità segnalata da un utente (CVE-2026-111497). Node.js è il motore che il SEO Spider usa per gli script lanciati via MCP, quindi l’aggiornamento è consigliato soprattutto a chi usa l’integrazione con l’AI. Controlla la tua versione da 1Help›2About.
Cosa piace (e cosa no)
- Auto throttle e dashboard sono le novità più citate. Per molti utenti l’auto throttle è il vero cambio di passo nell’uso quotidiano.
- Chi usa già l’MCP per gli audit apprezza la combinazione JSON config + debugging: il team descrive il crawl in linguaggio naturale e l’AI lo configura, con un forte risparmio di tempo. Tra le funzioni più apprezzate c’è anche l’export in Markdown per il lavoro sulla visibilità nella ricerca AI.
- Su X, Prasenjit Sarkar ha notato che il debugging via MCP pesa soprattutto per chi lo introduce: il crawler di riferimento degli SEO tecnici si sta riorganizzando attorno agli agenti AI che lanciano i crawl.
- Più prudente l’analisi di Techziano: l’AI che configura il crawl non sostituisce il giudizio sul sito. Le issue vanno priorizzate per impatto e valore di business, non per numero di warning, e le configurazioni generate vanno verificate su un campione di pagine reali.
Ironia della sorte: Screaming Frog presenta la dashboard scrivendo che “tutti sanno che la GUI è morta”, ma come ha osservato un utente nei commenti, per una GUI morta le nuove dashboard sembrano molto vive.
Conclusioni
La versione 25 di Screaming Frog SEO Spider completa il percorso iniziato con l’MCP della v24. La configurazione in JSON e il debugging rendono l’AI un vero copilota del crawl, mentre dashboard, issue configurabili e tab Social rendono l’audit più leggibile e più vicino alle priorità di ogni progetto. Auto throttle ed esclusione per link path, infine, risolvono due problemi che chi crawla e-commerce e siti protetti conosce bene.
Il consiglio pratico: installa direttamente la 25.1, salva di nuovo i tuoi profili di configurazione per averli in JSON e dedica dieci minuti a costruire una dashboard e un set di issue su misura per i tuoi clienti. Li riuserai a ogni audit.
Buon crawling a tutti!
Hai domande su Screaming Frog – Versione 25.0?
Le guide nascono dai progetti di tutti i giorni. Se qualcosa non torna nel tuo crawl, o vuoi applicare questa procedura al tuo sito, scrivimi.
 Autore.Raffaele Visintin.Search & Strategic Marketing Advisor
