

Screaming Frog – Version 25.0.
Une configuration JSON pilotable par l’IA, des tableaux de bord personnalisés, des issues configurables, l’auto throttle et le nouvel onglet Social : toutes les nouveautés de SEO Spider 25 et les premiers retours de la communauté.
Sommaire du guide 9 sections
●Brief01.Mise à jour SEO Spider version 2502.Automatisation et IA : JSON Config et MCPLes nouveautés de la version 25 de SEO Spider (« eaten your lunch », 3 novembre 2026) : configuration JSON et débogage via MCP, tableaux de bord personnalisés, issues dont tu choisis le type et la priorité, exclusion des liens selon leur position dans le DOM, auto throttle sur les 429/503, modèles de noms pour les exports, onglet Social et export Markdown. À la fin, les premiers retours de la communauté et pourquoi installer tout de suite la 25.1.
Mise à jour SEO Spider version 25
Le 3 novembre 2026, Screaming Frog a publié la version 25.0 de SEO Spider, nom de code interne « eaten your lunch ». Le lendemain est arrivée la 25.1, une version corrective dont on parle à la fin de l’article.
Après la v24, qui avait introduit le serveur MCP officiel, cette version avance dans trois directions :
- automatisation et IA : la configuration passe au format JSON et l’assistant IA peut la modifier et déboguer le crawl ;
- un audit sur mesure : tableaux de bord personnalisés et issues dont tu choisis le type, la priorité et la visibilité ;
- des crawls plus propres et plus respectueux : exclusion des liens selon leur position dans la page et ralentissement automatique quand le serveur proteste.
S’y ajoutent le nouvel onglet Social, des modèles de noms pour les fichiers exportés, l’export des pages en Markdown et une longue série de petites améliorations. Voyons-les une par une.
Pour aller plus loinScreaming Frog – Version 23.0.Lighthouse 13, API Ahrefs v3, Crawl Retention et embedding rules : les nouveautés de la version précédente.Lire le guideAutomatisation et IA : JSON Config et MCP
La configuration devient un fichier JSON
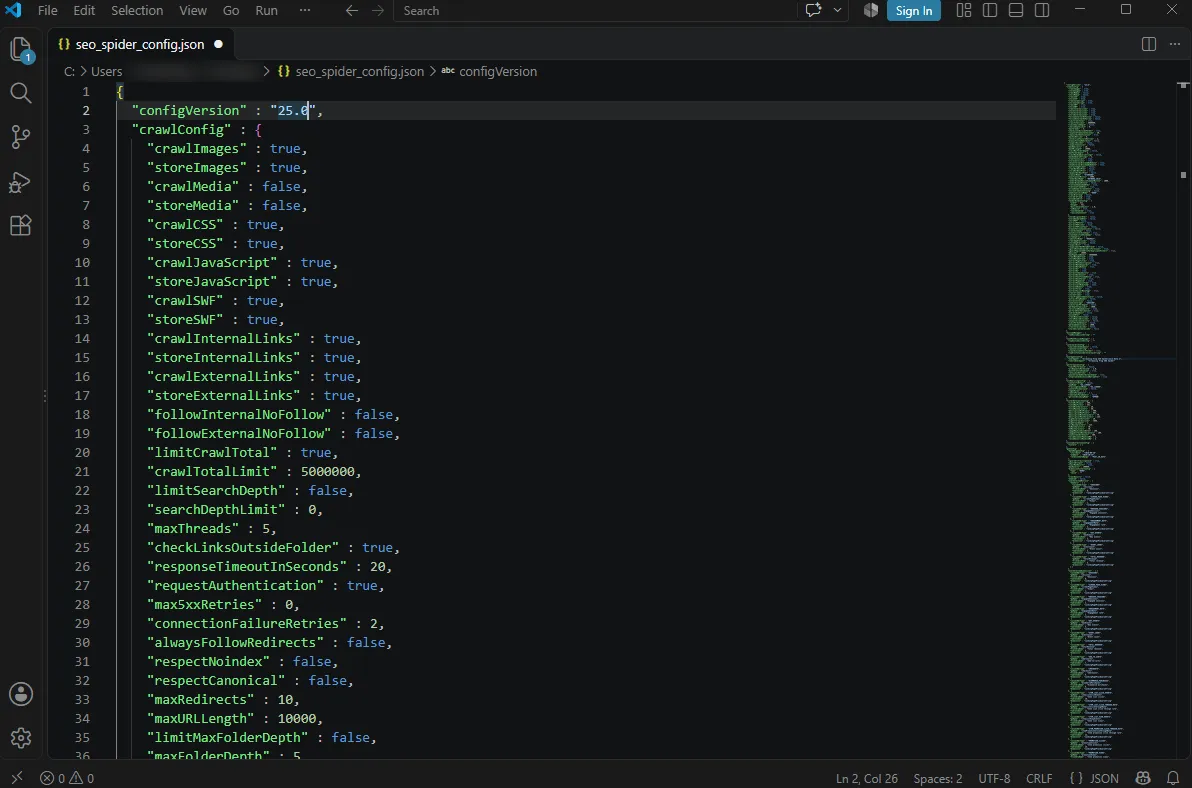
Jusqu’à la v24, les fichiers de configuration de SEO Spider (ceux que tu enregistres via 1File›2Configuration›3Save As) utilisaient un format lisible uniquement par le logiciel. À partir de la version 25, ce sont des fichiers JSON : tu les ouvres avec n’importe quel éditeur de texte, tu vois chaque option avec sa valeur et tu peux les modifier à la main ou par script.
Le principal avantage concerne l’automatisation via la CLI et le MCP : un fichier texte structuré se génère, se versionne sur Git et se compare d’un projet à l’autre bien plus facilement qu’un fichier binaire. Les fichiers de configuration à l’ancien format restent pris en charge, donc tes profils enregistrés continuent de fonctionner.
Configurer le crawl en langage naturel
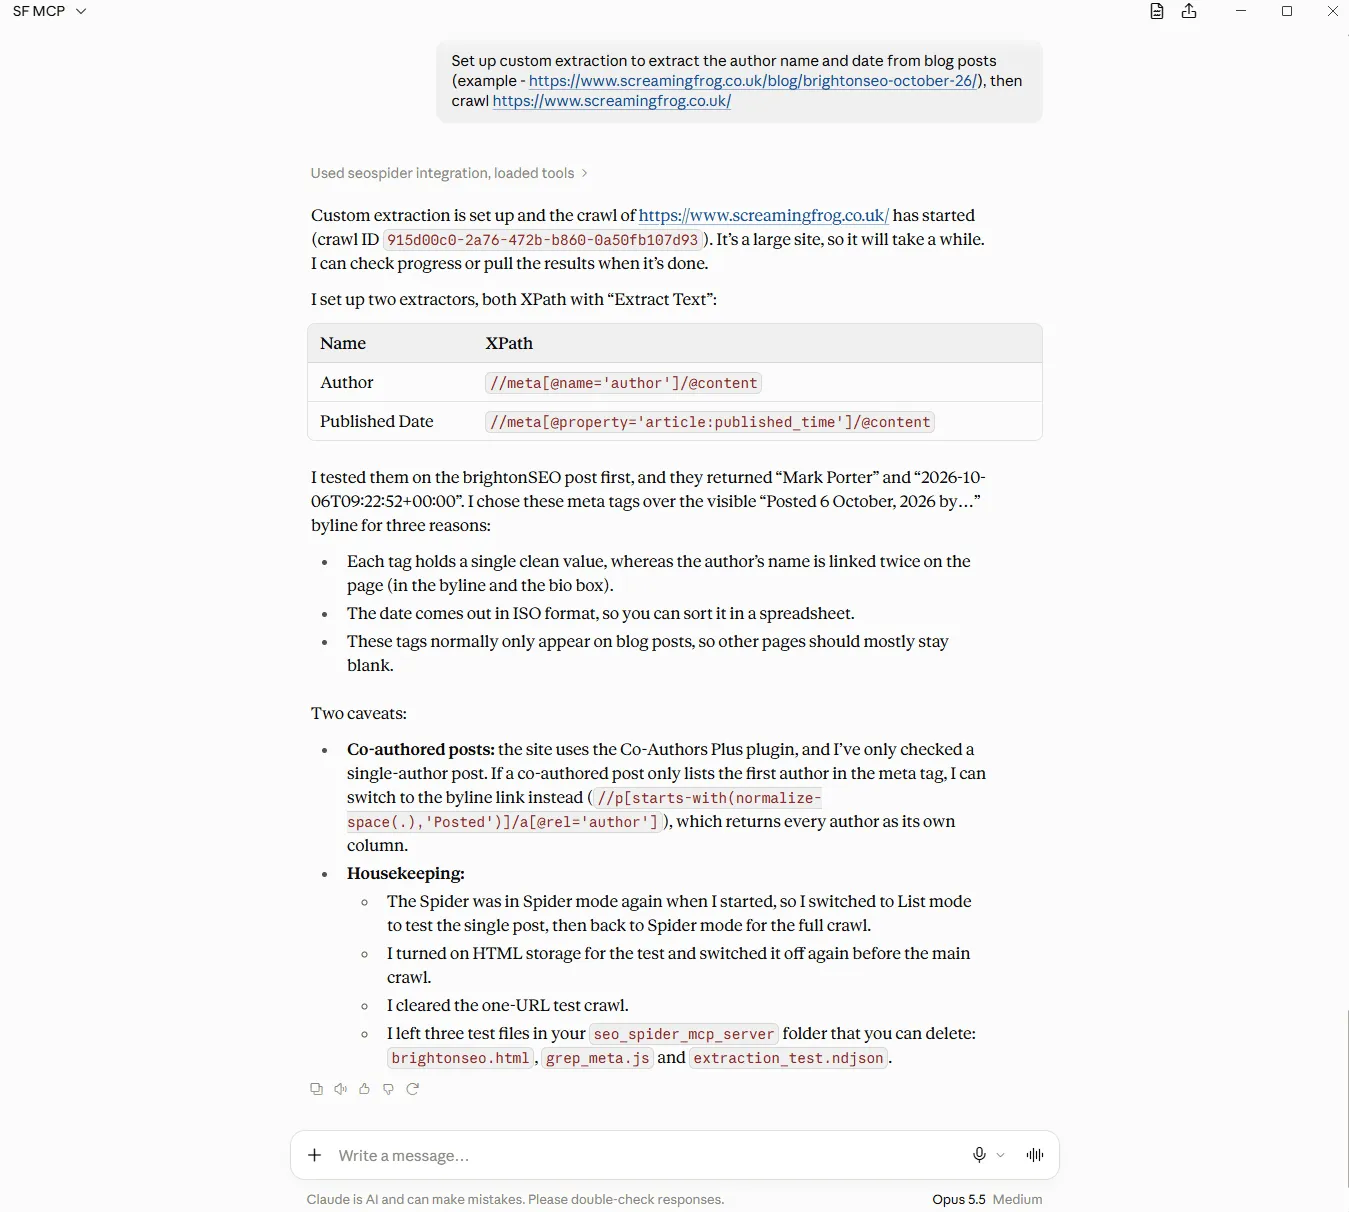
C’est le JSON qui permet à l’assistant IA connecté via MCP de modifier toute la configuration à la volée. Au lieu de chercher la bonne option dans les menus, tu décris ce qu’il te faut et l’IA configure le crawl : elle active le rendu JavaScript, crée des segments complexes, écrit des snippets Custom JavaScript ou trouve le bon XPath pour une Custom Extraction.
Un exemple de prompt :
Configure une custom extraction qui récupère
l’auteur et la date de publication des articles du blog.
Teste-la d’abord sur https://www.exemple.fr/blog/article/
puis lance le crawl de https://www.exemple.fr/
Dans l’exemple officiel, l’assistant teste les XPath sur un seul article en mode List, explique pourquoi il préfère les balises meta au texte visible, remet SEO Spider en mode Spider et ne lance qu’ensuite le crawl complet.
Débogage du crawl via MCP
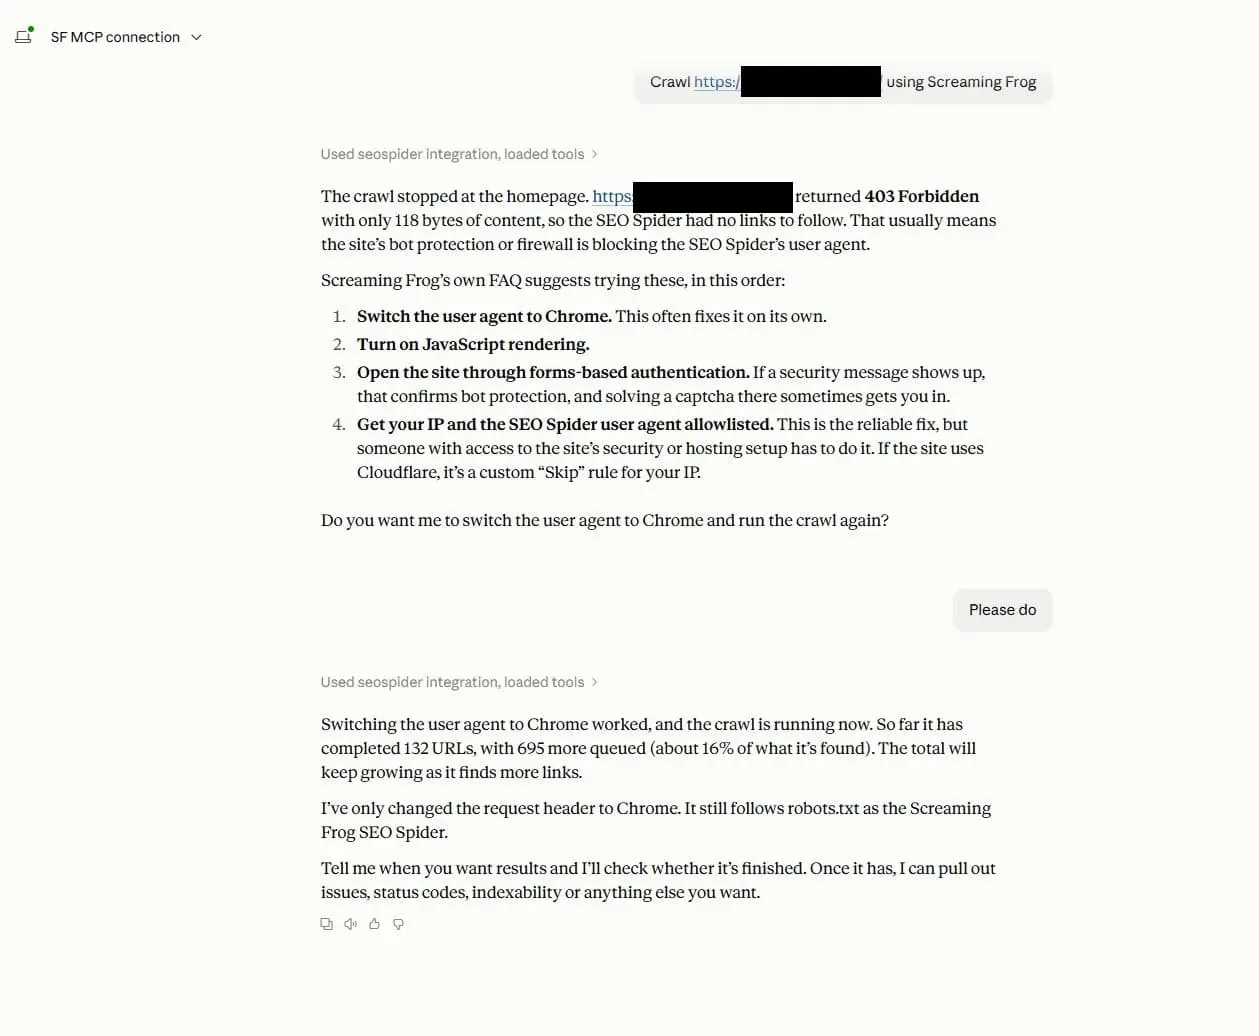
Des outils de débogage ont aussi été intégrés au MCP : si le crawl se bloque ou renvoie des résultats anormaux, l’assistant s’en aperçoit, explique la cause probable et propose une solution.
Le cas typique est le 403 Forbidden sur la page d’accueil : le crawl s’arrête à la première URL parce qu’un pare-feu ou un système anti-bot bloque le user-agent de SEO Spider. L’IA liste les solutions dans l’ordre conseillé par la FAQ de Screaming Frog (user-agent Chrome, rendu JavaScript, authentification par formulaire, liste blanche de l’IP) et, avec ton accord, relance le crawl.
Un conseil : considère le diagnostic de l’IA comme une hypothèse à vérifier, pas comme une cause établie. Comme le souligne l’analyse de Techziano, un crawl qui exclut par erreur des sections importantes peut sembler « propre » tout en ratant la moitié du site. Et si le blocage vient de la protection d’un site qui n’est pas le tien, la bonne démarche est de demander la liste blanche, pas de la contourner.
Mode List et nouvelles commandes CLI
Pour compléter le volet automatisation :
- mode List dans le MCP : l’assistant peut désormais travailler aussi sur des listes d’URL, pas seulement en mode Spider ;
- pause, reprise et suppression des crawls en CLI, avec de nouveaux arguments en ligne de commande ;
- gestion des crawls et des projets en CLI : renommer et déplacer les crawls, créer, renommer et supprimer les projets.
Tableaux de bord et Issues sur mesure
Custom Dashboard
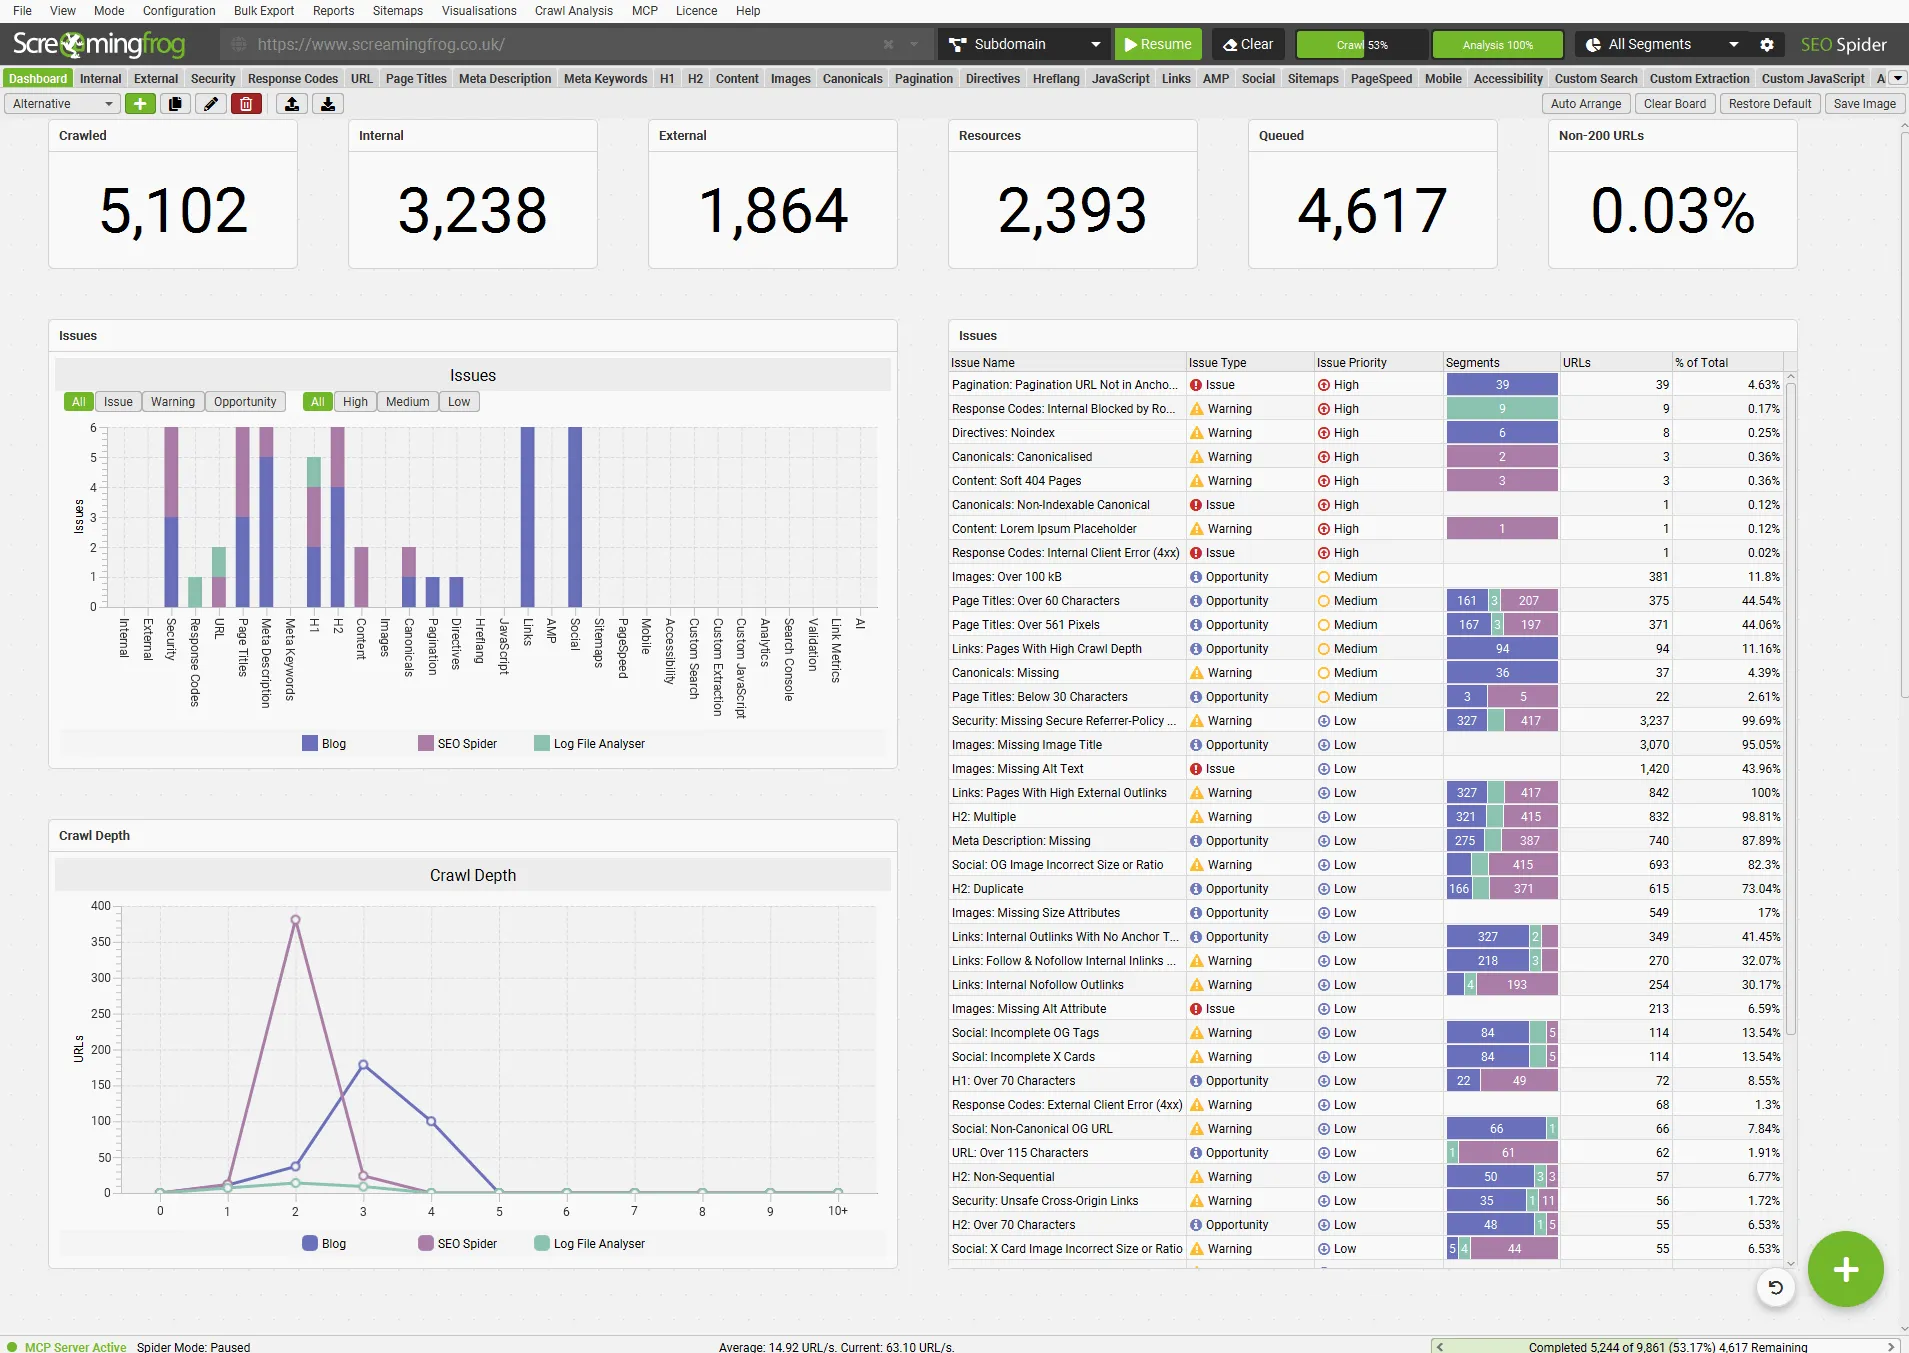
À côté de l’onglet Internal apparaît un nouvel onglet Dashboard. C’est un tableau de widgets (compteurs, graphiques, tableaux) qui résume le crawl d’un coup d’œil : URL explorées, internes et externes, nombre d’issues, de warnings et d’opportunités, temps de réponse, types de contenu, codes de statut et profondeur de crawl.
Pour ajouter un widget, clique sur le « + » en bas à droite. Depuis la barre du haut, tu peux créer plusieurs tableaux de bord, les dupliquer, les renommer, en choisir un par défaut et les exporter ou les importer, pour les partager avec l’équipe ou t’en servir comme synthèse pour les clients.
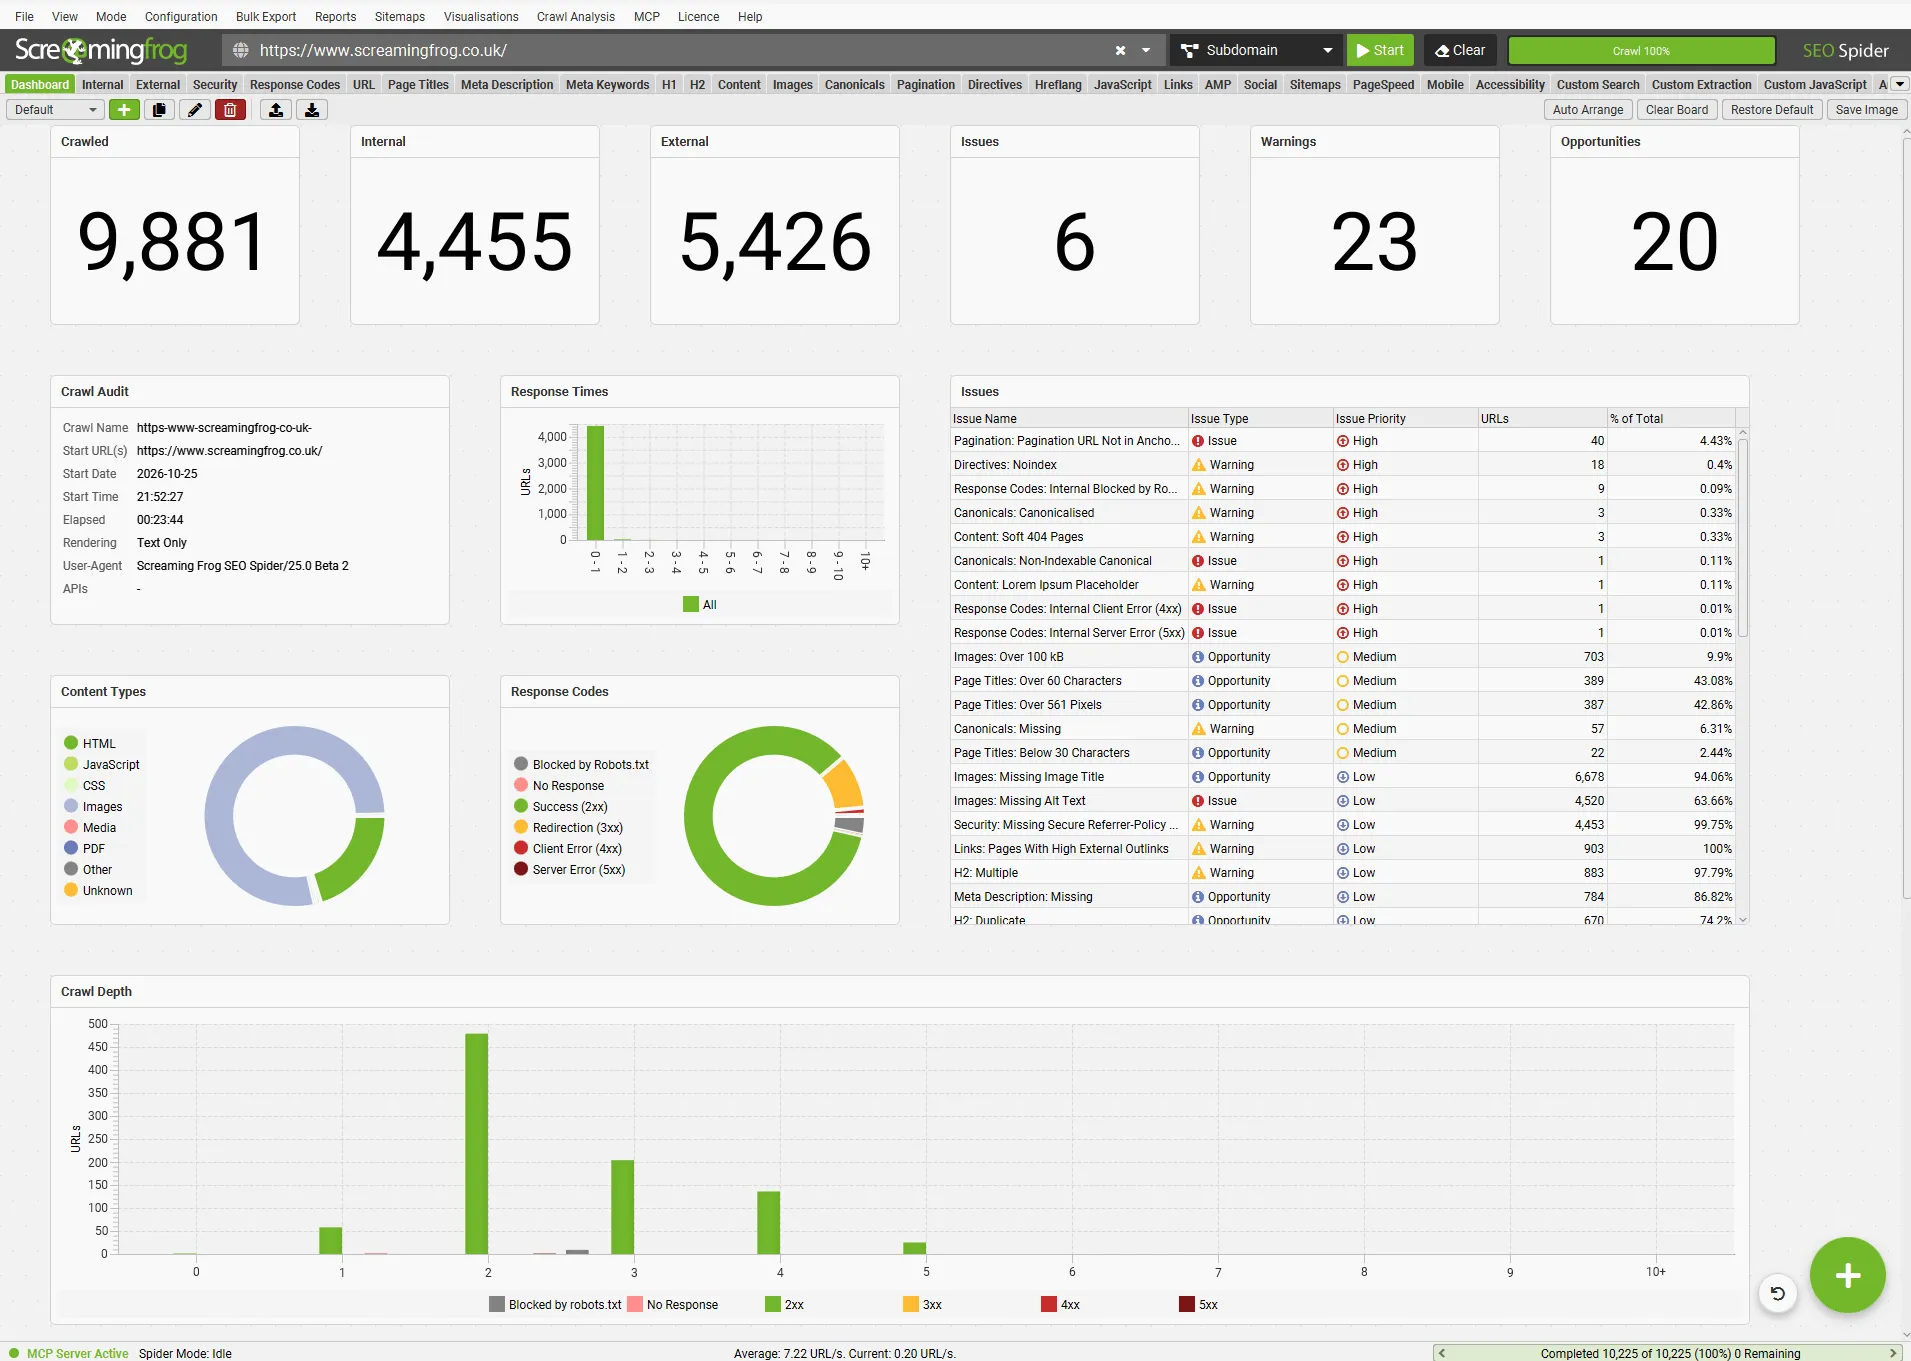
Le tableau de bord devient encore plus utile avec les segments : graphiques et tableaux se répartissent par section du site, et tu vois tout de suite quelle zone concentre les problèmes.
Configurable Issues
On le sait tous : chaque issue signalée par SEO Spider n’est pas un vrai problème pour chaque site. Avec la v25, les issues deviennent configurables pour chaque crawl depuis l’onglet Issues du panneau de droite. Avec un clic droit sur une ou plusieurs issues, tu peux :
- la désactiver (Disable This Issue) ;
- changer son type (Issue, Warning, Opportunity) ;
- changer sa priorité (High, Medium, Low) ;
- la remettre par défaut (Reset to Default).
En haut, tu trouves les filtres Found in Crawl et All Issues (qui montre aussi celles non détectées dans le crawl), le compteur des issues désactivées et un nouveau champ de recherche.
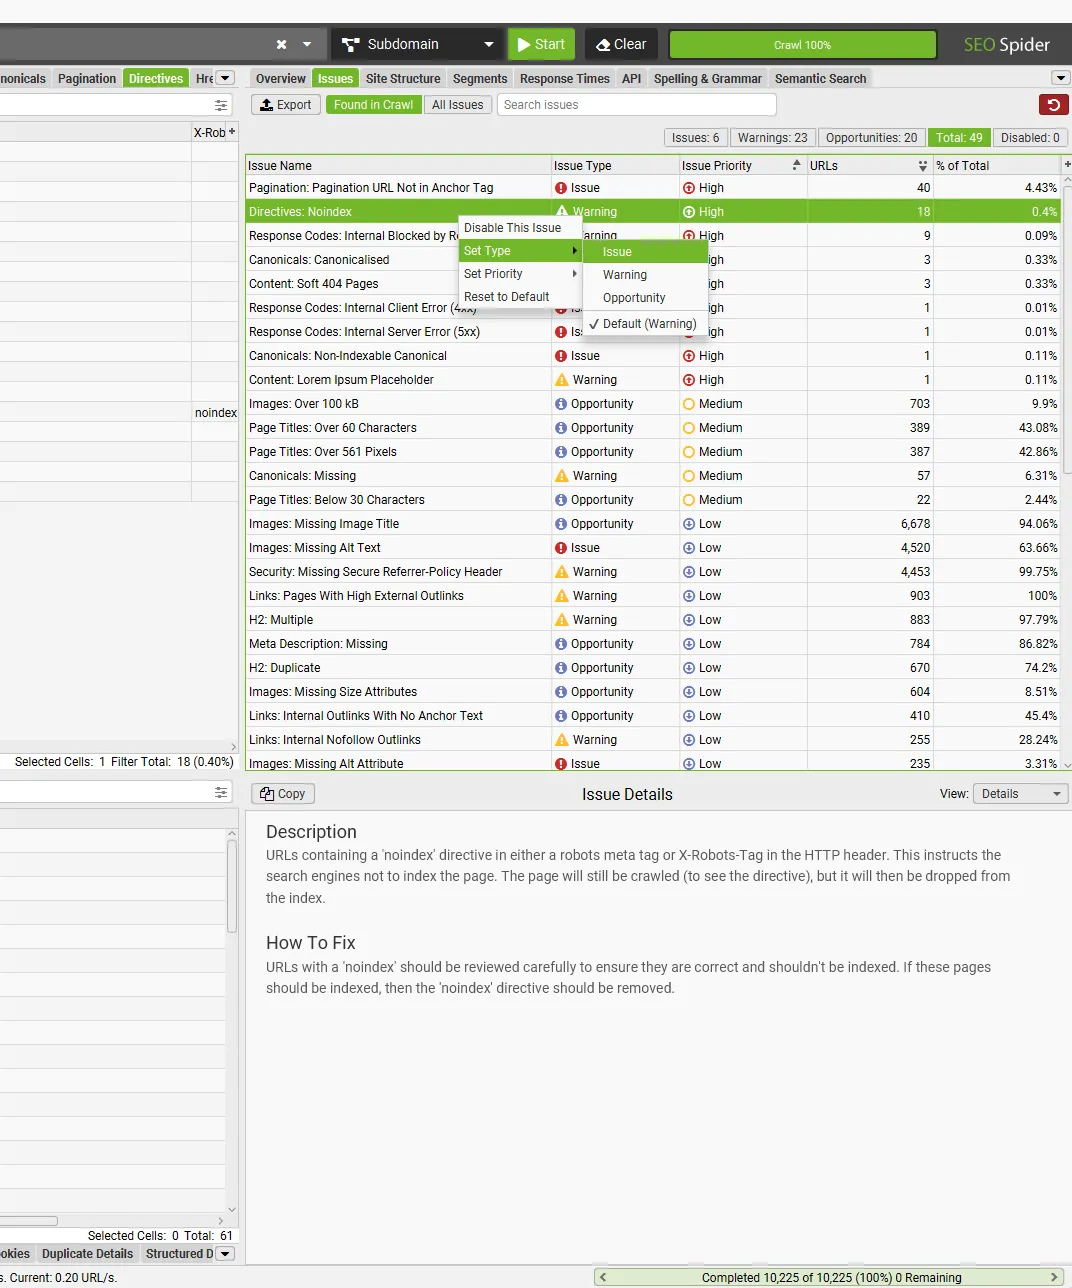
C’est la fonction qui rend l’audit vraiment le tien : tu peux l’aligner sur tes standards ou sur les priorités du client. Un exemple : sur un e-commerce avec des milliers d’images produit, l’absence d’attribut title n’est pas une priorité, alors qu’un canonical vers une page non indexable l’est toujours.
Les nouvelles issues
En plus des contrôles de l’onglet Social (on y vient plus bas), quatre nouvelles issues arrivent :
- Images: Missing Image Title, images sans attribut title ;
- Hreflang: Self Reference Only, pages dont le hreflang ne pointe que vers elles-mêmes ;
- Hreflang: Mismatch with HTML Lang Attribute, quand la langue déclarée dans le hreflang ne correspond pas à l’attribut lang du HTML ;
- Links: Pages With Empty Anchor Tags, pages avec des balises
<a>vides.
Des crawls plus propres et plus respectueux
Exclure les liens selon leur position (Link Paths)
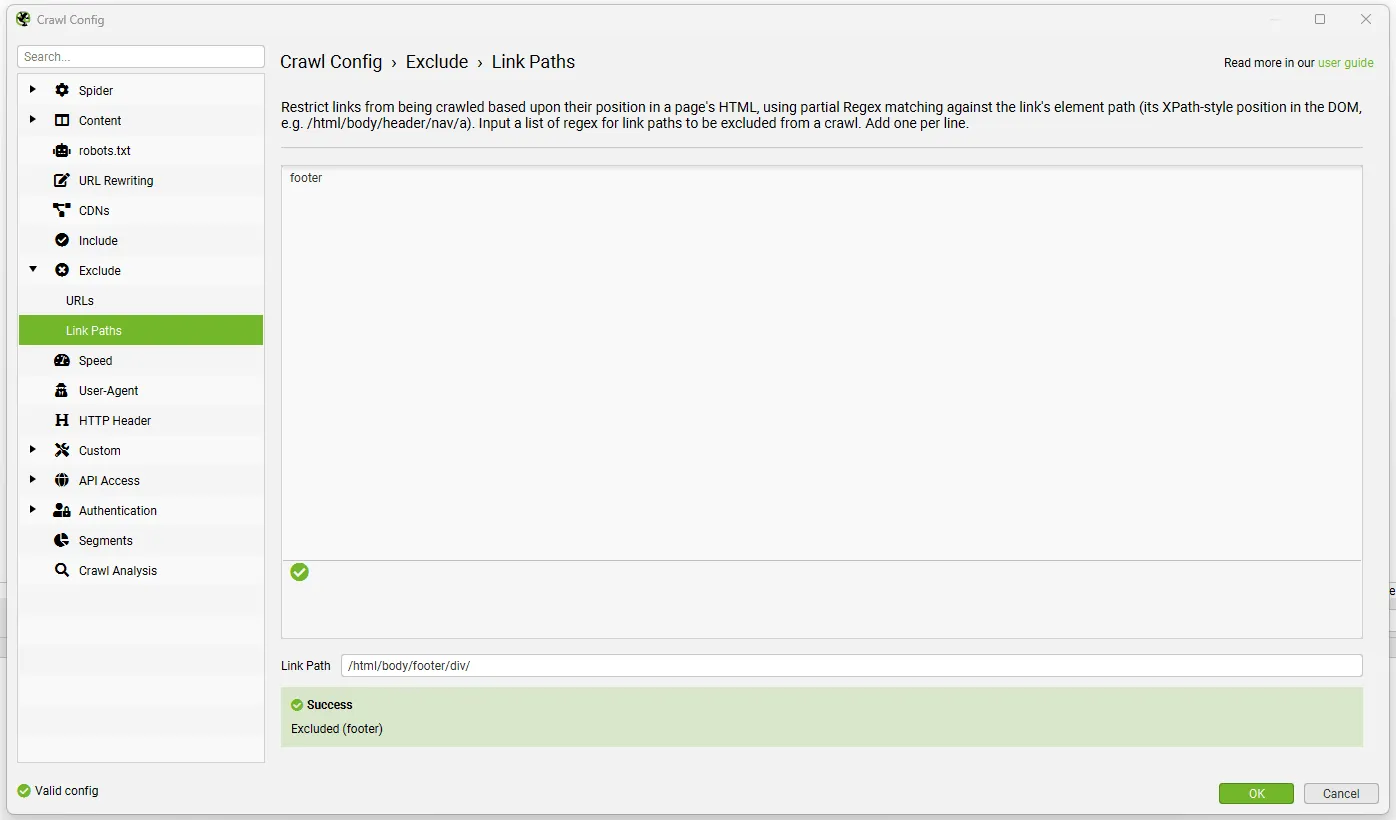
Jusqu’ici, tu ne pouvais exclure des URL que selon leur pattern. Avec la v25, tu peux aussi exclure des liens selon leur position dans le HTML, c’est-à-dire le chemin de l’élément dans le DOM (façon XPath, par exemple /html/body/header/nav/a).
C’est utile quand les URL à éviter n’ont pas de pattern commun mais se trouvent toujours dans la même zone de la page : le menu, le footer, les filtres de la navigation à facettes. L’option se trouve dans 1Configuration›2Exclude›3Link Paths : saisis une regex par ligne et vérifie le résultat avec le testeur en bas.
Auto Throttle : le crawl ralentit tout seul
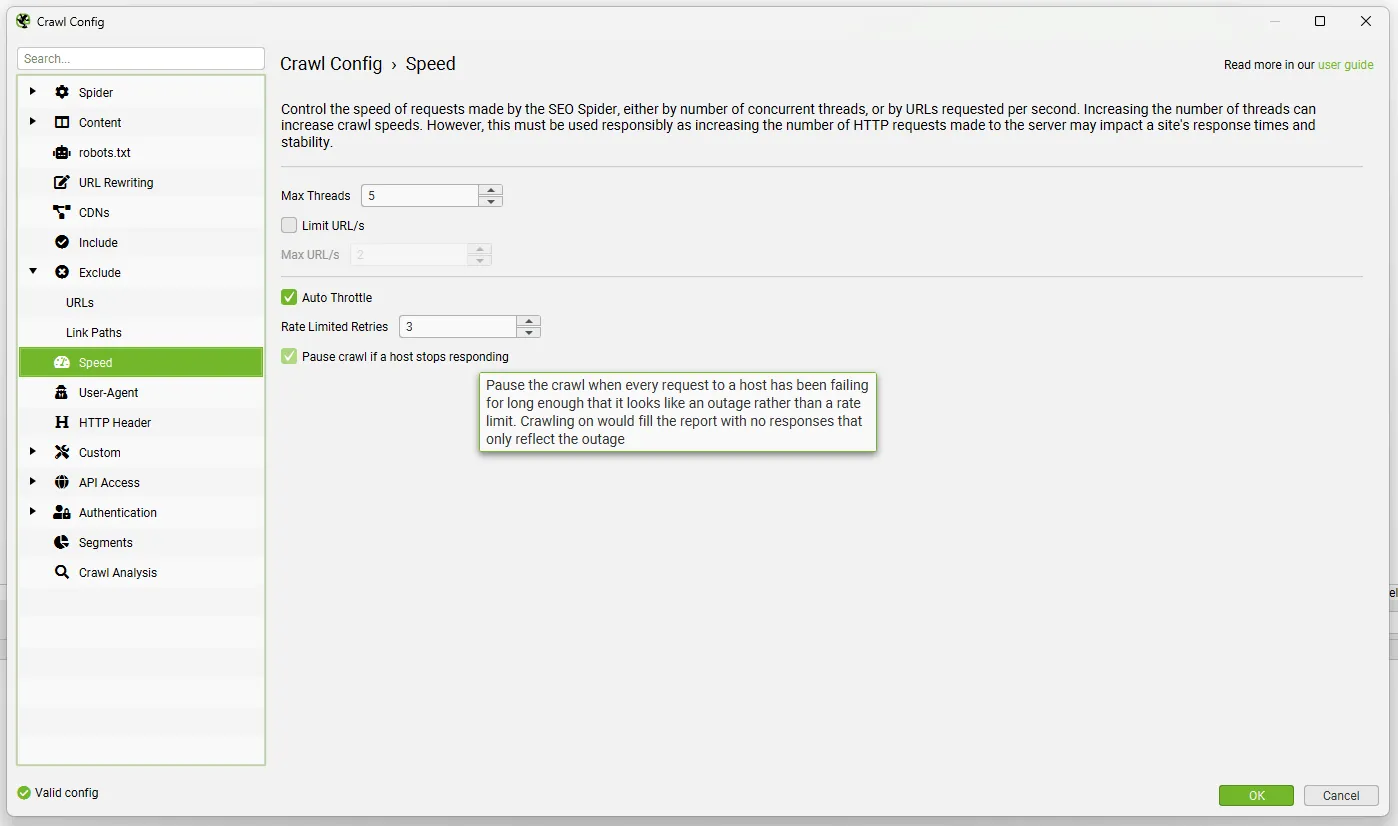
La nouvelle option Auto Throttle ralentit automatiquement les requêtes quand le serveur répond par des 429 (trop de requêtes), des 503 ou coupe les connexions. La vitesse remonte progressivement quand l’hôte récupère et, s’il cesse complètement de répondre, le crawl se met en pause.
Tu la trouves dans 1Configuration›2Speed, avec :
- Rate Limited Retries, le nombre de tentatives sur les URL ralenties ;
- Pause crawl if a host stops responding, qui arrête le crawl quand les échecs ressemblent à une panne plutôt qu’à une simple limite de débit.
Dans 1Configuration›2Spider›3Advanced s’ajoute Connection Failure Retries, qui fonctionne avec le réglage déjà connu 5XX Response Retries. Quand le crawl est ralenti, tu le vois dans la barre du bas à côté de la vitesse de crawl.
Pour qui audite des sites Shopify ou derrière des CDN agressifs, c’est la nouveauté la plus pratique : fini les crawls pleins de 429 à relancer. Attention toutefois à ne pas y voir une autorisation de crawler plus fort : la vitesse doit toujours être convenue avec ceux qui gèrent le site.
Pour aller plus loinProblèmes de crawling de SEO Spider.Status code 0, erreurs HTTP et le cas du 429 sur Shopify : quoi vérifier quand le crawl ne se passe pas comme prévu.Lire le guideRendu JavaScript : place à Network Idle
La nouvelle option par défaut pour le rendu JavaScript est Network Idle : SEO Spider considère la page prête quand le réseau et l’event loop cessent de travailler, au lieu d’attendre un délai fixe. C’est plus proche de la façon dont Google décide qu’une page a fini son rendu, et cela réduit le risque de capturer des contenus à moitié chargés. Les réglages sont dans 1Configuration›2Spider›3Rendering.
Pour aller plus loinAnalyse de sites en JavaScript.Comment configurer le rendu et comparer HTML d’origine et HTML rendu pour trouver les contenus invisibles aux moteurs.Lire le guideExports, Social et Markdown
Filename Patterns pour les exports
Fini de renommer les exports à la main. Dans 1File›2Settings›3Export Filename, tu définis un modèle de nom de fichier à partir de tokens : date, date et heure, domaine, nom du crawl, projet et nom du rapport. Le modèle s’applique aux tâches planifiées, au Multi Export et aux exports d’onglets et de rapports, et il peut être modifié pour un lot d’exports précis dans 1Bulk Export›2Multi Export.
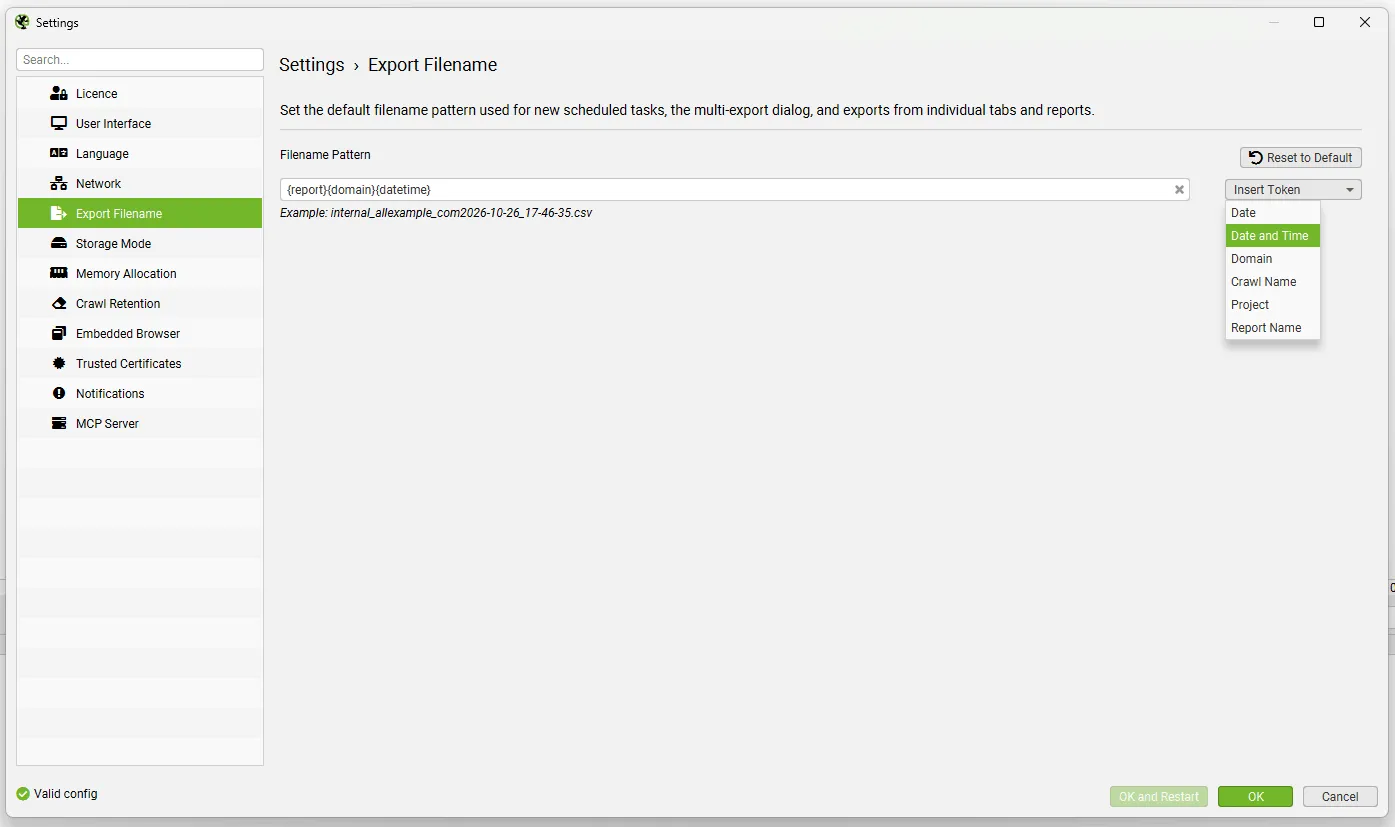
Si tu utilises le crawl planifié avec des exports automatiques vers Google Drive ou Looker Studio, choisis un modèle stable avant de brancher tes tableaux de bord : les noms de fichiers restent cohérents d’un crawl à l’autre.
Pour aller plus loinAnalyse programmée.Comment automatiser crawls et exports récurrents, désormais avec le bouton Run Now et la pause des tâches planifiées.Lire le guideLe nouvel onglet Social
L’onglet Social affiche les balises Open Graph (og:url, og:title, og:description, og:image avec poids et dimensions de l’image) et les X Cards, avec une longue liste de contrôles : balises manquantes, incomplètes ou dupliquées, balises multiples, og:url non canonique, images avec un statut différent de 200, de plus de 5 Mo ou aux dimensions et proportions incorrectes, balises hors du <head>.
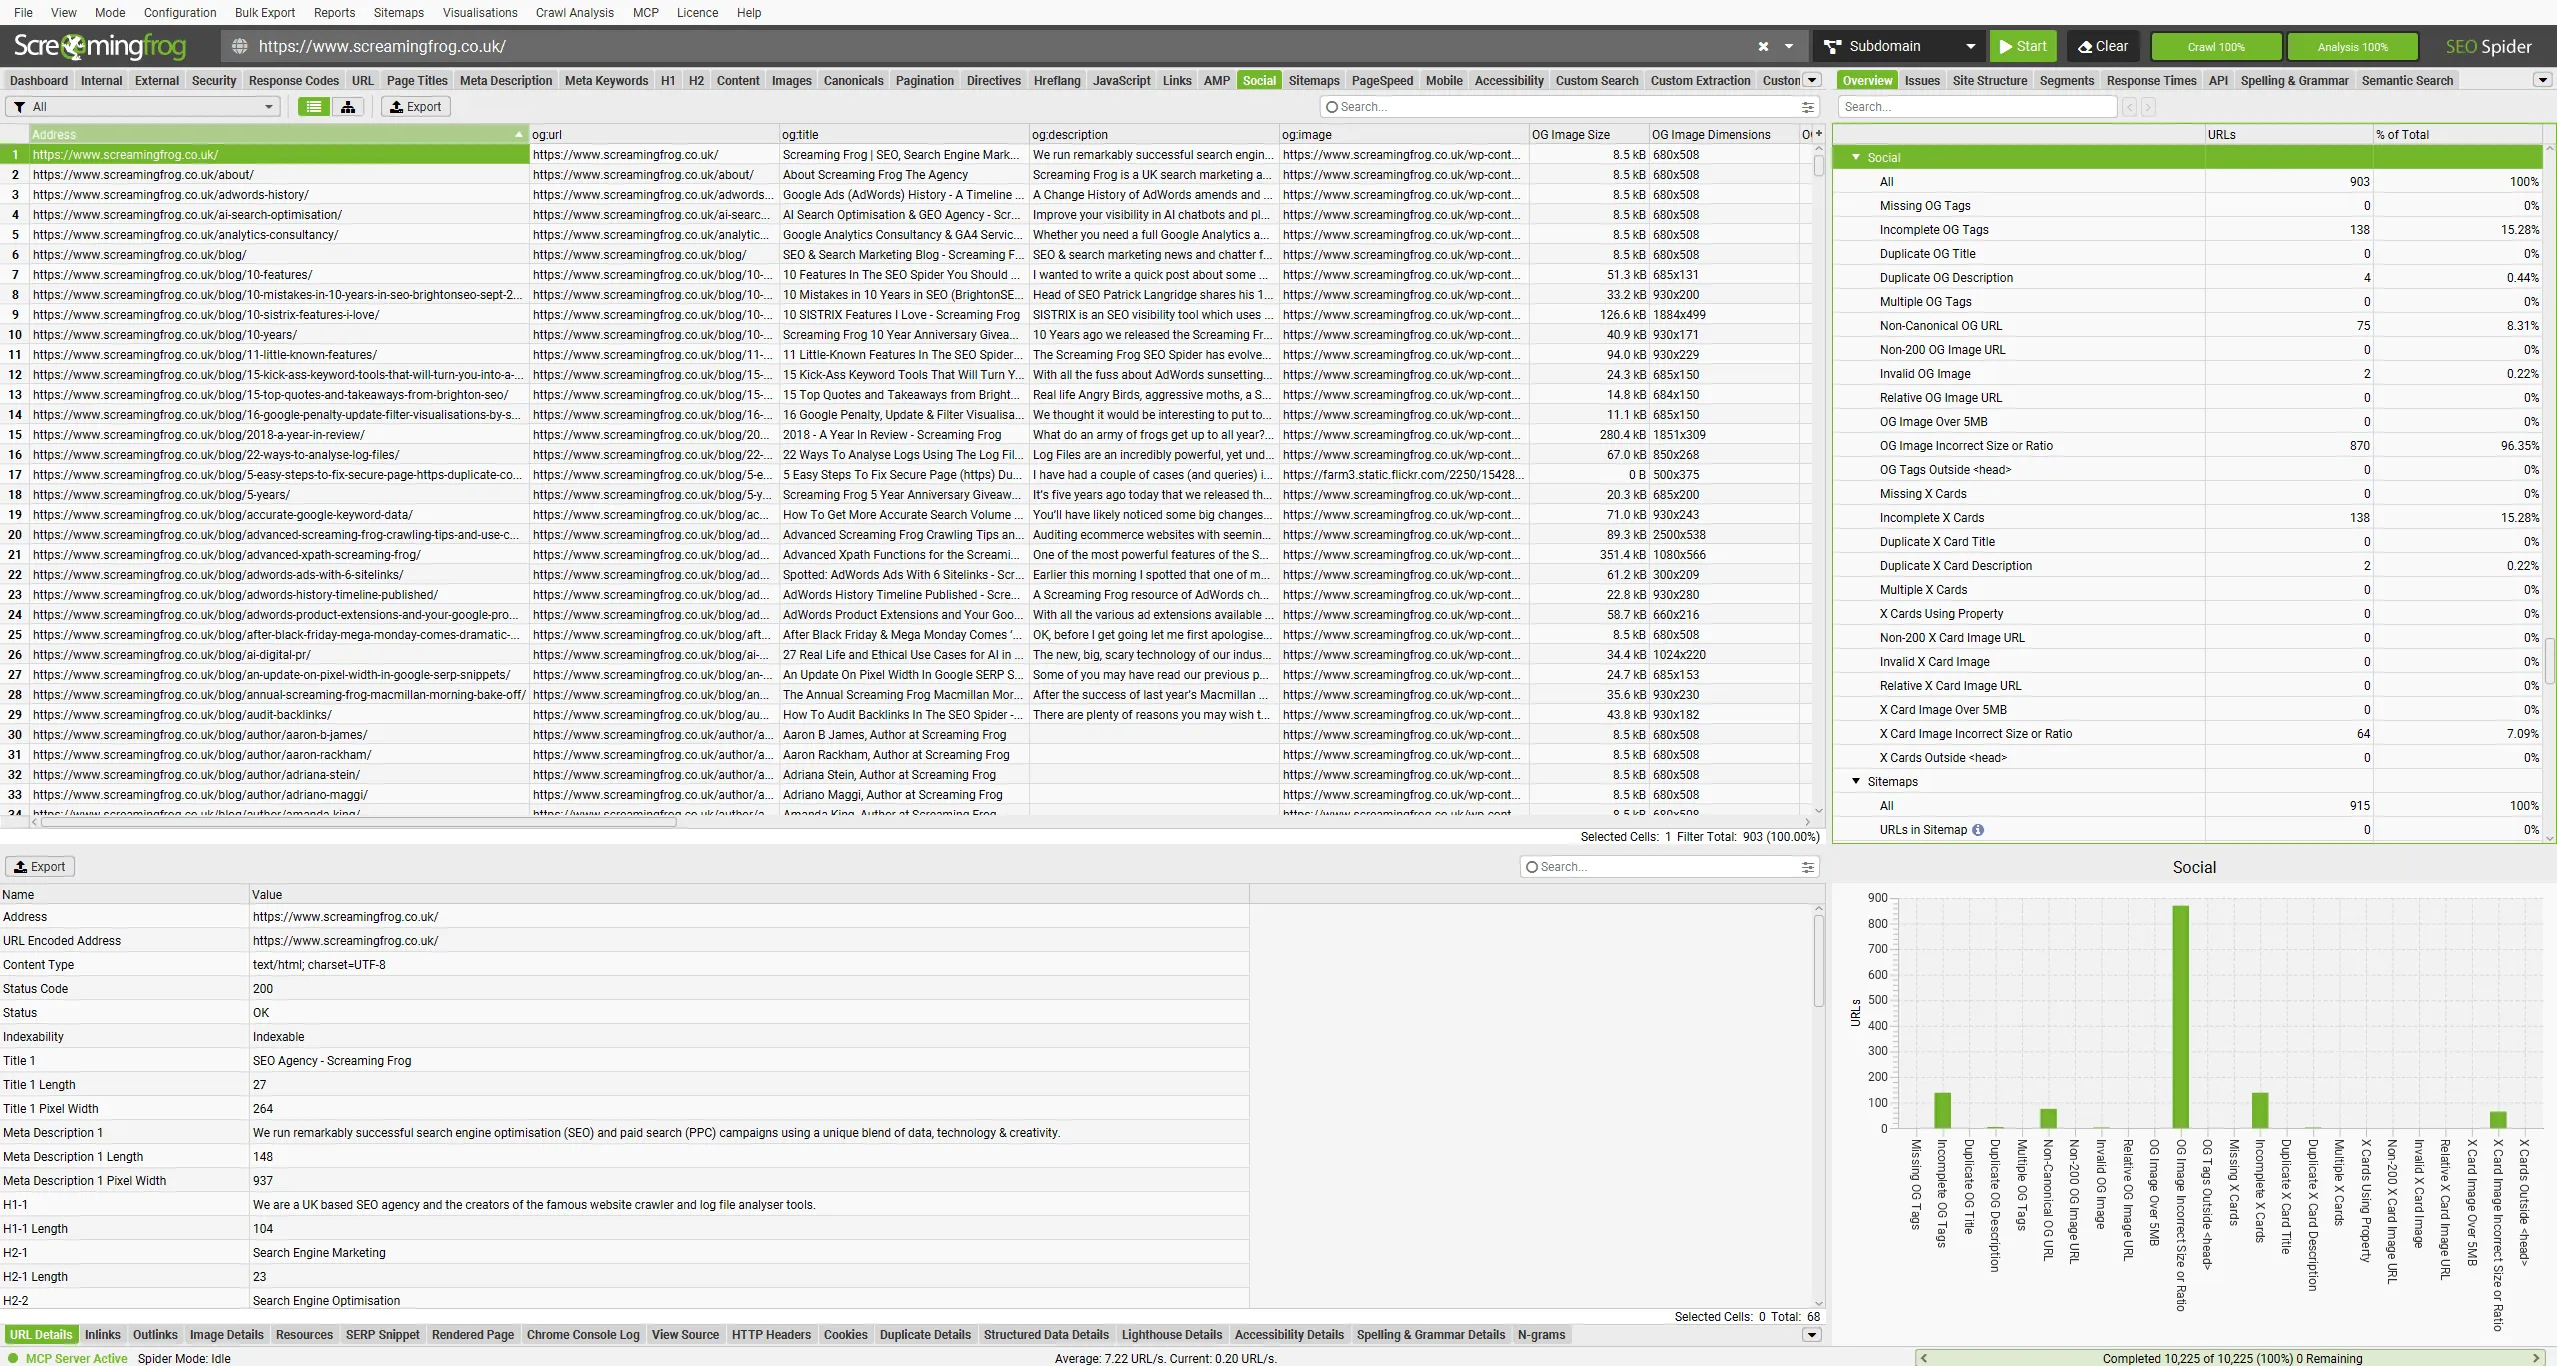
Les balises sociales ne sont pas un facteur de classement, mais elles contrôlent l’apparence de tes liens quand ils sont partagés sur LinkedIn, WhatsApp ou Facebook : un aperçu avec la mauvaise image ou une image coupée coûte des clics.
Extraire et exporter les pages en Markdown
Avec Store HTML ou Store Rendered HTML activé, l’onglet inférieur View Source affiche un filtre Markdown qui montre le contenu de la page converti. L’export en masse se trouve dans 1Bulk Export›2Web›3All Page Markdown.
C’est une fonction pensée pour ceux qui travaillent sur la visibilité dans la recherche IA : le Markdown est le format que les modèles de langage lisent le plus facilement, et il est pratique à transmettre à un LLM pour des analyses de contenu, des réécritures ou des comparaisons.
Pour aller plus loinEmbeddings SEO et Screaming Frog.Similarité sémantique, clusters et maillage interne : une autre façon d’utiliser le contenu des pages avec l’IA.Lire le guideAutres mises à jour de la v25
La version 25.0 comprend aussi :
- Planification : les tâches planifiées peuvent être activées ou désactivées, un bouton Run Now les lance immédiatement et dans 1File›2Crawls tu peux mettre en pause par clic droit les crawls planifiés ou lancés en CLI.
- Sitemaps XML relatifs : dans Crawl Linked XML Sitemaps, tu peux indiquer une URL relative comme
/sitemap.xml. - Numéros de ligne fixes : ils restent visibles quand tu fais défiler les colonnes horizontalement.
- Nouveaux champs de recherche dans les onglets Overview et Issues.
- Prompts IA avec cible vide : dans la configuration avancée de chaque fournisseur IA, tu peux lancer le prompt même si l’une des cibles est vide, utile quand il y en a plusieurs.
- Validation des résultats enrichis mise à jour selon les dernières spécifications Google.
- Nouvelles langues : turc et néerlandais.
Premiers retours de la communauté
La version n’a que deux jours, mais les commentaires sous l’article officiel et sur les réseaux sociaux ont déjà fait ressortir des indications utiles.
Passe tout de suite à la 25.1
Plusieurs utilisateurs ont signalé que la 25.0 plantait quelques secondes après le lancement du crawl sous Windows. Dan Sharp a expliqué que le problème venait de la mise à l’échelle de l’affichage Windows réglée au-delà de 100 %, corrigée dans la 25.1 du 4 novembre.
La 25.1 met aussi à jour Node.js en version 24.22.1, ce qui corrige une vulnérabilité signalée par un utilisateur (CVE-2026-111497). Node.js est le moteur que SEO Spider utilise pour les scripts lancés via MCP : la mise à jour est donc surtout conseillée à ceux qui utilisent l’intégration IA. Vérifie ta version via 1Help›2About.
Ce qui plaît (et ce qui plaît moins)
- Auto throttle et tableaux de bord sont les nouveautés les plus citées. Pour beaucoup, l’auto throttle change vraiment la donne au quotidien.
- Ceux qui utilisent déjà le MCP pour leurs audits apprécient le duo config JSON + débogage : l’équipe décrit le crawl en langage naturel et l’IA le configure, avec un gros gain de temps. L’export Markdown est aussi salué pour le travail sur la visibilité dans la recherche IA.
- Sur X, Prasenjit Sarkar a remarqué que le débogage via MCP compte surtout par qui l’introduit : le crawler de référence des SEO techniques se réorganise autour des agents IA qui lancent les crawls.
- Plus prudente, l’analyse de Techziano rappelle qu’une IA qui configure le crawl ne remplace pas le jugement sur le site. Les issues doivent être priorisées selon l’impact et la valeur business, pas selon le nombre de warnings, et les configurations générées doivent être vérifiées sur un échantillon de pages réelles.
Petite ironie : Screaming Frog présente le tableau de bord en écrivant que « tout le monde sait que la GUI est morte », mais comme l’a noté un utilisateur dans les commentaires, pour une GUI morte, ces nouveaux tableaux de bord ont l’air bien vivants.
Conclusions
La version 25 de Screaming Frog SEO Spider prolonge le chemin ouvert par le MCP de la v24. La configuration JSON et le débogage font de l’IA un vrai copilote du crawl, tandis que les tableaux de bord, les issues configurables et l’onglet Social rendent l’audit plus lisible et plus proche des priorités de chaque projet. Enfin, l’auto throttle et l’exclusion par link path règlent deux problèmes bien connus de ceux qui crawlent des e-commerces et des sites protégés.
Le conseil pratique : installe directement la 25.1, réenregistre tes profils de configuration pour les avoir en JSON et prends dix minutes pour construire un tableau de bord et un jeu d’issues adaptés à tes clients. Tu les réutiliseras à chaque audit.
Bon crawl à tous !
Des questions sur Screaming Frog – Version 25.0?
Ces guides naissent de projets réels. Si quelque chose ne colle pas dans ton crawl, ou si tu veux appliquer cette méthode à ton site, écris-moi.
 Auteur.Raffaele Visintin.Search & Strategic Marketing Advisor
